كل كلمة في التحليل لها تصنيفها الخاص. مناقشة المواضيع العلمية والثقافية، استخدام اللغة الإنجليزية
تم دعم الدراسة بمنحة من مؤسسة العلوم الروسية.
استخدمت دراسة سميرنوفعينة تمثيلية من البيانات من دراسة فريق الصحة والسلامة والبيئة الطولية "المسارات التعليمية والمهنية" (TrEC). تتتبع الدراسة التطوير الوظيفي لـ 4400 طالب من 42 منطقة في روسيا من الجامعات المشاركة في برنامج PISA (برنامج تقييم الطلاب الدوليين). تضمنت بيانات الدراسة أيضًا بيانات عن حسابات VK الخاصة بالطلاب (وافق 3483 طالبًا مشاركًا على تقديم هذه المعلومات).
"منذ هذه البيانات ، جنبا إلى جنب مع الرقميةيشرح سميرنوف: "من الصعب الحصول على آثار ، فهي لا تستخدم أبدًا تقريبًا". وفي الوقت نفسه ، تسمح مجموعة البيانات هذه بتطوير نموذج قوي يمكن تطبيقه على معلمات أخرى. ويمكن استقراء النتائج لجميع طلاب المدارس الثانوية والثانوية الأخرى.
كعينة تدريب ، استخدمناهارسائل من الصفحات العامة "فكونتاكتي" - ما مجموعه 130575 رسالة من 2468 شخصًا اجتازوا اختبار PISA في عام 2012. سمح الاختبار للباحث بتقييم القدرة الأكاديمية للطالب ، وكذلك قدرته على إثبات معرفته في الممارسة. تضمنت الدراسة فقط رسائل فكونتاكتي المتاحة للجمهور من المشاركين المتفق عليهم.
أثناء الدراسة، تم إجراء تعلم آلي غير خاضع للرقابة مع تمثيل متجه للكلمات في مجموعة ما بعد فكونتاكتي (إجمالي 1.9 مليار كلمة، مع 2.5 مليون كلمة فريدة).
لقد قدمنا كل منشور على شكل 300 بعدالمتجه من خلال حساب متوسط تمثيلات المتجهات لجميع الكلمات المكونة لها ، "يشرح سميرنوف. "تم استخدام وجهات النظر هذه لتدريب نموذج الانحدار الخطي للتنبؤ بتقييمات مؤلفي ما بعد PISA."
بواسطة "تنبؤ" الباحثلا يعني التنبؤ بالمستقبل، بل وجود علاقة بين النتائج المحسوبة والدرجات الفعلية التي حصل عليها الطلاب في اختبار PISA، بالإضافة إلى نتائج امتحان الدولة الموحدة (والتي تكون متاحة للجمهور على الإنترنت في شكل مجمع - أي أنها متوسط الدرجات في المدرسة). في المرحلة الأولية، تعلم النموذج كيفية التنبؤ ببيانات برنامج التقييم الدولي للطلاب (PISA). في النموذج النهائي، تمت مقارنة الحسابات مع نتائج امتحان الدولة الموحدة لخريجي المدارس الثانوية والمتقدمين.
كان من المفترض أن يكون النموذج النهائي قادرًا على ذلكالتعرف بشكل موثوق على ما إذا كان طالب قوي أو ضعيف قد كتب منشورًا معينًا على شبكة اجتماعية ، أو بعبارة أخرى ، يميز الموضوعات وفقًا لأدائه الأكاديمي. بعد فترة من التدريب ، تمكن النموذج من تمييز الرسائل المكتوبة من قبل الطلاب ذوي درجات PISA العالية أو المنخفضة (المستويات 5-6 والمستويات 0-1) بدقة 93.7٪. فيما يتعلق بإمكانية المقارنة بين اختبار PISA والاستخدام ، على الرغم من اختلاف الاختبارين ، فقد أظهر البحث أن أداء الطالب في هذين الاختبارين مرتبط بشكل كبير ببعضهما البعض.
اتضح أن "الأداء الأكاديمي المتوقع وثيقعلى صلة بنتائج الامتحان ، يقول سميرنوف. معامل الارتباط بين 0.49 و 0.6. وفي حالة الجامعات ، عند مقارنة الأداء الأكاديمي المتوقع ودرجات المتقدمين في برنامج USE (المعلومات المتوفرة في الدراسة الحالية ، مراقبة جودة القبول الجامعي) ، أظهرت النتائج أيضًا علاقة قوية. معامل الارتباط هو 0.83 ، وهو أعلى بكثير من المدرسة الثانوية ، لأن مزيد من البيانات. "
نتائج
سلط سميرنوف الضوء على ميزات النص المشتركةالمشاركات فيما يتعلق بتقدم مؤلفيها. تم العثور على استخدام الكلمات الرئيسية (-0.08) والرموز التعبيرية (-0.06) وعلامات التعجب (-0.04) ارتباطًا سلبيًا بالأداء الأكاديمي. من ناحية أخرى ، يرتبط استخدام الأحرف اللاتينية ومتوسط طول الرسالة والكلمة وحجم المفردات والإنتروبيا في نصوص المستخدم بشكل إيجابي مع الأداء الأكاديمي (من 0.07 إلى 0.16 على التوالي).
كما تم التأكيد على أن الطلاب ذوي مستويات التحصيل المختلفة لديهم مفردات مختلفة.
تم استخدام الطلاب ذوي الأداء العالي:
- كلمات انجليزية؛
- الكلمات الأدبية (برادبري ، فهرنهايت ، أورويل ، هكسلي ، فولكنر ، نابوكوف ، برودسكي ، كامو ، مان) ؛
- مفاهيم القراءة (قراءة ، نشر ، كتاب ، مجلد) ؛
- المصطلحات والأسماء المتعلقة بالفيزياء (الكون ، الكم ، النظرية ، أينشتاين ، نيوتن ، هوكينغ) ؛
- كلمات متعلقة بعمليات التفكير (تفكير ، حفظ).
استخدم الطلاب ذوو الدرجات المنخفضة الكلمات ذات الدرجاتالأخطاء ، أسماء ألعاب الكمبيوتر الشائعة ، المفاهيم المتعلقة بالخدمة العسكرية (الجيش ، القسم ، إلخ) ، مصطلحات الأبراج (برج الحمل ، القوس) والكلمات المتعلقة بالقيادة وحوادث السيارات (الاصطدام ، شرطة المرور ، العجلات ، الضبط).
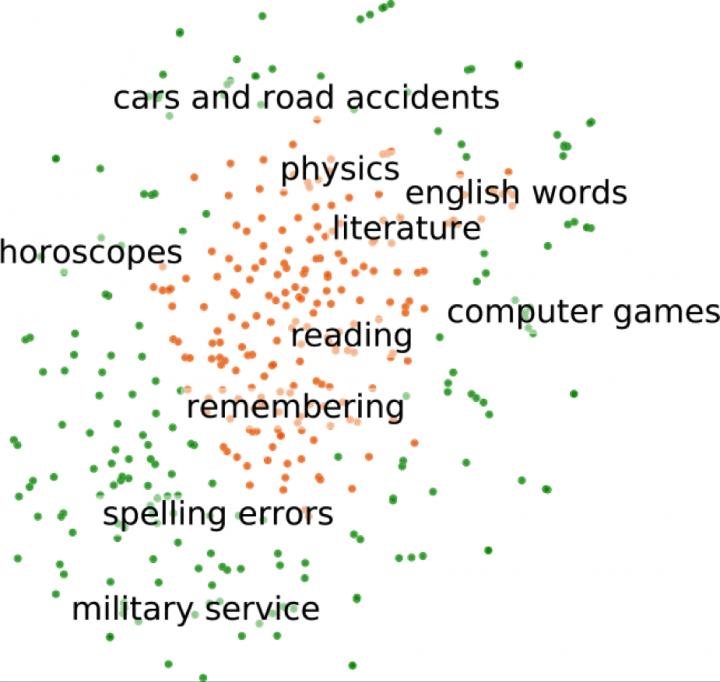 المجموعات المواضيعية: تمثل الكلمات ذات الدرجات الأعلى والأدنى من مجموعة بيانات التدريب
قام سميرنوف بحساب المعاملات لجميع الـ 2.5 مليونكلمات نموذج المتجه وقدمتها لمزيد من الدراسة. ومن المثير للاهتمام أنه حتى الكلمات النادرة في مجموعة بيانات التدريب يمكنها التنبؤ بالأداء الأكاديمي. على سبيل المثال، حتى إذا لم يظهر الاسم "Newt" (كما هو الحال في شخصية Harry Potter Newt Scamander) مطلقًا في مجموعة بيانات التدريب، فيمكن للنموذج تعيين تصنيف أعلى للرسائل التي تحتوي عليه. سيحدث هذا إذا علم النموذج أن الكلمات من سلسلة الرواية يستخدمها طلاب متفوقون، ومن خلال التعلم غير الخاضع للرقابة، يفهم النموذج "بشكل حدسي" أن اسم "نيوت" يقع ضمن هذه الفئة.
اقرأ أيضا
انتهت المهمة السنوية في القطب الشمالي والبيانات مخيبة للآمال. ما الذي ينتظر البشرية؟
شاهد سيارة هامر الجديدة تتغلب على العقبات على الطريق وتتحرك مثل السلطعون
في اليوم الثالث من المرض ، يفقد معظم مرضى COVID-19 حاسة الشم لديهم وغالبًا ما يعانون من سيلان الأنف