Всяка дума в анализа има собствена оценка. Дискусия на научни и културни теми, използване на английски език
Изследването е подкрепено с грант от Руската научна фондация.
Използвано изследване на Смирновпредставителна извадка от данни от надлъжно кохортно панелно проучване на HSE „Образователни и кариерни траектории“ (TrEC). Проучването проследява кариерното развитие на 4400 студенти от 42 региона на Русия от университети, участващи в програмата PISA (Програма за международно оценяване на студентите). Данните от проучването също така включват данни за VK акаунти на студенти (3483 студенти участници се съгласиха да предоставят тази информация).
„Тъй като такива данни, комбинирани с цифровиследите са трудни за получаване, почти никога не се използват “, обяснява Смирнов. Междувременно такъв набор от данни позволява да се разработи стабилен модел, който може да се приложи към други параметри. И резултатите могат да бъдат екстраполирани на всички останали ученици - ученици от гимназията и гимназията.
Като пример за обучение използвахмесъобщения от публични страници „ВКонтакте“ - общо 130 575 съобщения от 2468 души, преминали теста PISA през 2012 г. Тестът позволи на изследователя да оцени академичните способности на ученика, както и способността му да демонстрира знанията си на практика. Проучването включва само публично достъпни съобщения от ВКонтакте от договорени участници.
По време на проучването е извършено неконтролирано машинно обучение с векторно представяне на думи в пост-корпуса на VKontakte (общо 1,9 милиарда думи, с 2,5 милиона уникални думи).
„Представихме всяка публикация като 300-измернавектори чрез осредняване на векторните представяния на всички съставни думи “, обяснява Смирнов. „Тези изгледи на публикации бяха използвани за обучение на модел на линейна регресия за предсказване на рейтингите на авторите на публикации в PISA.“
Чрез „предсказание“ изследователятне означава предсказване на бъдещето, а корелация между изчислените резултати и действителните резултати, получени от учениците на изпита PISA, както и техните резултати от Единния държавен изпит (които са публично достъпни в интернет в обобщен вид – т.е. това са средни резултати в училище). На предварителния етап моделът се научи да прогнозира данните от PISA. В окончателния модел изчисленията бяха сравнени с резултатите от Единния държавен изпит на зрелостници и кандидати.
Окончателният модел трябваше да моженадеждно да разпознаят дали силен или слаб студент е написал конкретна публикация в социална мрежа или, с други думи, разграничава предметите в съответствие с академичните си резултати. След период на обучение моделът успя да различи съобщения, написани от ученици с високи или ниски PISA резултати (нива 5-6 и нива 0-1) с точност 93,7%. По отношение на съпоставимостта на PISA и USE, въпреки че двата теста се различават, изследванията показват, че резултатите на учениците по двата теста силно корелират помежду си.
Оказа се, че „прогнозираното академично представяне е тясносвързани с резултатите от изпита, "- казва Смирнов. „Коефициентът на корелация е между 0,49 и 0,6. И в случая с университетите, когато се сравняват прогнозните академични резултати и USE резултати (налична информация в текущото проучване, Мониторинг на качеството на приема в университет), резултатите също показват силна връзка. Коефициентът на корелация е 0,83, което е значително по-високо, отколкото за средното училище, тъй като повече данни. "
Резултати
Смирнов подчерта общи черти на текстапубликации във връзка с напредъка на техните автори. Установено е, че използването на заглавни думи (-0.08), емотикони (-0.06) и възклицания (-0.04) отрицателно корелира с академичните постижения. От друга страна, използването на латински символи, средната дължина на съобщението и думата, размерът на речника и ентропията на текстовете на потребителите са положително свързани с академичните постижения (съответно от 0,07 до 0,16).
Потвърдено е също, че учениците с различни нива на постижения имат различен речников запас.
Използвани студенти с висока ефективност
- Английски думи;
- Думи, свързани с литературата (Брадбъри, Фаренхайт, Оруел, Хъксли, Фокнър, Набоков, Бродски, Камю, Ман);
- Концепции за четене (четене, публикуване, книга, том);
- Термини и имена, свързани с физиката (Вселена, квант, теория, Айнщайн, Нютон, Хокинг);
- Думи, свързани с мисловни процеси (мислене, запаметяване).
Учениците с ниски резултати са използвали думи сгрешки, имена на популярни компютърни игри, понятия, свързани с военна служба (армия, клетва и др.), термини за хороскоп (Овен, Стрелец) и думи, свързани с шофиране и автомобилни инциденти (сблъсък, пътна полиция, колела, настройка).
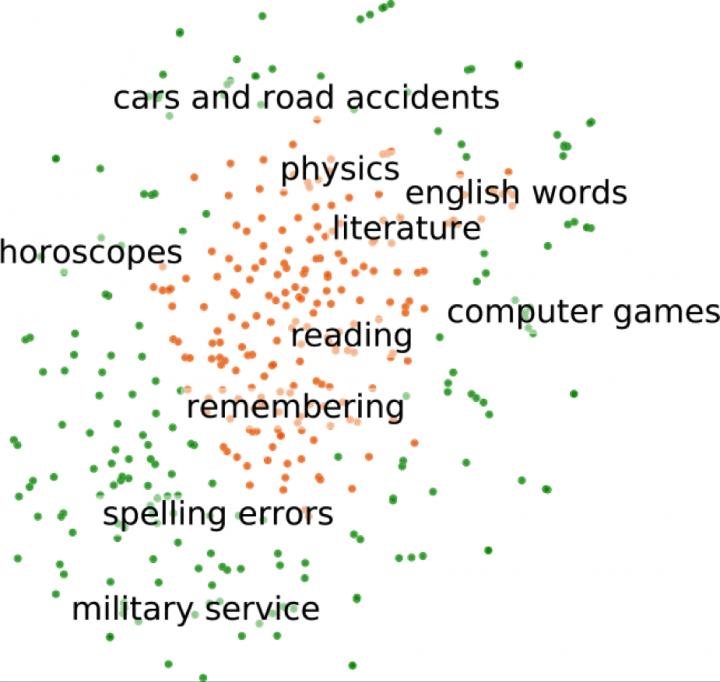 Тематични клъстери: Представяне на думите с най-висок и най-нисък резултат от набора от данни за обучение
Смирнов изчисли коефициентите за всичките 2,5 милионадуми на векторния модел и ги предостави за по-нататъшно проучване. Интересното е, че дори думи, които са рядкост в набора от данни за обучение, могат да предскажат академичното представяне. Например, дори ако името „Нют“ (като героя на Хари Потър Нют Скамандър) никога не се появява в данните за обучението, моделът може да присвои по-висока оценка на съобщенията, които го съдържат. Това ще се случи, ако моделът научи, че думите от поредицата романи се използват от ученици с високи постижения и чрез неконтролирано обучение моделът "интуитивно" разбира, че името "Нют" попада в тази категория.
Прочетете също
Годишната мисия в Арктика приключи и данните са разочароващи. Какво очаква човечеството?
Гледайте как новият Hummer преодолява препятствията по пътя, движейки се като рак
На 3-ти ден от заболяването повечето пациенти с COVID-19 губят обонянието си и често страдат от хрема