I en datadrevet verden skabes centre, der kan opbevare billigt, hurtigt og effektivt
DNA-lagringssystemlyder som science fiction. Men sådanne løsninger er allerede blevet implementeret. Sandt nok, indtil videre hovedsageligt til forskningsformål og til opbevaring af arkivdata, der ikke skal bruges ofte. Den vigtigste begrænsning for at arbejde med DNA er vanskeligheden med hurtig parallel adgang til et stort antal filer og læse- og skrivefejl.
Et internationalt team af forskere har udviklet sigteknologi, der kan fjerne eksisterende mangler. En af forfatterne til undersøgelsen, publiceret i tidsskriftet Nature, er overbevist om, at ved at bruge den foreslåede løsning inden for 5-10 år, vil fuldgyldige datacentre baseret på DNA blive en realitet.
DNA som datalagringssystem
Ideen om at bruge DNA-strenge til at lagre datadiskuteret i årtier. Tilbage i 1988 kodede Harvard-forskere og kunstner Joe Davies et 5 x 7-pixel billede af en gammel germansk rune (35 bit information i alt) til DNA inkluderet i en E. coli-bakterie. Men dette eksempel var blot en demonstration af fremtidige muligheder: Teknologien var for dyr og kompliceret.
Teknisk set er lagring af data i DNA blevet muligt,da Harvard-forskere i 2011 udviklede en teknologi til kontrolleret DNA-syntese. Yderligere forskning på dette område har i høj grad reduceret omkostningerne og øget hastigheden af at skabe syntetisk DNA, der indeholder de ønskede DNA-sekvenser.
At gemme information i DNA i stedet for det sædvanlige 0og 1, som bruges til at kode data, kan baseparrene "adenin - thymin" og "cytosin - guanin" bruges. I laboratoriet kombineres baserne i en bestemt rækkefølge for at danne syntetiske DNA-strenge.
Fordele ved DNA
Lagring af data i DNA har mange fordele.For eksempel fylder en DNA-fil ikke meget: På grund af molekylets høje tæthed er hvert nukleotid, svarende til to bits, omkring 1 nm³. Og en exabyte af data (1.000.000 TB) lagret som DNA kan passe i din håndflade. DNA er også ekstremt stabilt - opdagelsen af en bevaret genetisk kode i fossiler af gamle mikroorganismer og dyr er et godt eksempel på dette. Og desuden kræver denne teknologi ikke væsentlige energiomkostninger.
Problemet er, at hvis der er spørgsmålDa eksisterende løsninger fungerer godt nok til at skrive data (selvom de forbliver relativt dyre), begynder der at opstå problemer med læsning. PCR random access-metoden, der i øjeblikket anvendes til læsning, er tilbøjelig til et stort antal fejl. Systemer kan kun læse én fil ad gangen, og kvaliteten af dataene bliver alvorligt forringet ved hver læsning.
Læseprocessen fungerer som følger:Hver datafil i DNA indeholder en sekvens, der binder til en specifik primer. Ved hjælp af polymerasekædereaktion (PCR) starter forskere processen med at syntetisere millioner af kopier af det ønskede fragment.
Samme princip virker f.eks.test for coronavirus: under påvirkning af en bestemt syntetisk primer starter en kædereaktion, og selv en lille mængde virus-DNA bliver sporbar. Problemet er, at læsning af flere separate filer kræver, at flere primere virker på samme tid, og det fører til mange fejl i kopieringsprocessen og ødelæggelsen af det originale DNA.
Skalerbar teknologi
Et internationalt hold af forskere foreslårmetoden, de mener vil overvinde disse begrænsninger, er varmefikseret PCR. Forskere har skabt mikrokapsler af proteiner og polymerer, der fungerer som separate DNA-filer. Hver sådan kapsel er forbundet med én datafil. Derudover er de designet på en sådan måde, at når en flerhed af mikrokapsler opvarmes til temperaturer over 50 °C, er hver af disse kapsler forseglet.
Dette gør det muligt for PCR-processen at læseforekomme uafhængigt i hver kapsel, hvilket efterlader meget lidt plads til fejl. Når temperaturen normaliseres, forbliver den originale fil knyttet til kapslen, og de kopierede filer forlader den. Dette forhindrer, at de originale data og DNA bliver beskadiget.
Genetikere brugte deres nye tilgang tilsamtidig læsning af 25 filer gemt i det splittede DNA. Resultaterne var positive og uventede. I gennemsnit er aflæsningstabet med termiske kapsler 0,3 % efter tre aflæsninger, sammenlignet med 35 % med den nuværende metode.
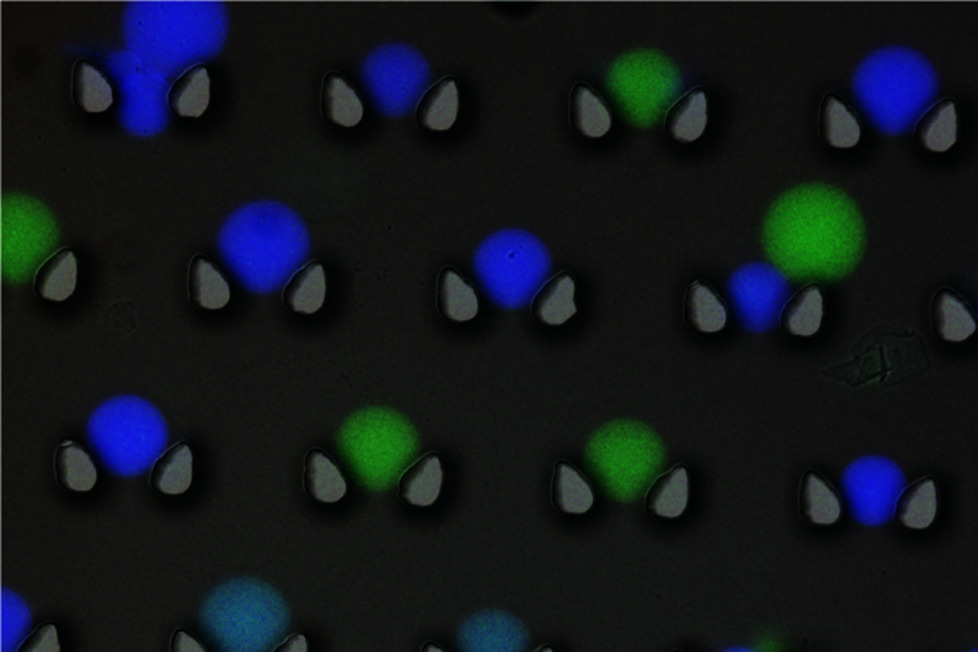 Mikrokapsler farvet med fluorescerende etiketter. Billede: Tom de Greef
Den anden "innovation" - malet med specieltagget katalog. Hver fil er tildelt en fluorescerende etiket, og hver kapsel er tildelt en anden farve. En speciel enhed kan derefter genkende farver og adskille dem fra hinanden for at gøre det nemmere at sortere og søge information i et stort lager.
Forfatterne af teknologien er overbevist om, at disse innovationernok til at skabe et fuldgyldigt DNA-baseret datacenter. ”I den ene del af bygningen vil nye filer blive kodet ved hjælp af DNA-syntese. Den anden vil indeholde store felter af kapsler, hver med en separat fil. Robotarmen vil tage kapslen ud, læse dens indhold og placere den tilbage,” siger en af forfatterne til undersøgelsen. Pointen er lille: at vente, indtil omkostningerne ved DNA-syntese er reduceret endnu mere, og for dette ene årti er nok, er forskerne sikre på.
Læs mere:
Kunstig intelligens har fundet fire Nazca geoglyffer - kæmpe tegninger i ørkenen
Fraværet af "klumpet" i universet blev forklaret med ultralette partikler af mørkt stof
Omkring en milliard år, en dag på Jorden varede 19 timer: forskere forklarede hvorfor
På forsiden: Billede af Freepik