Hvert ord i analysen har sin egen vurdering.
Undersøgelsen blev støttet af et tilskud fra Russian Science Foundation.
Smirnovs undersøgelse brugtet repræsentativt udsnit af data fra HSE longitudinelle kohortepanelundersøgelsen "Educational and Career Trajectories" (TrEC). Undersøgelsen sporer karriereudviklingen for 4.400 studerende fra 42 regioner i Rusland fra universiteter, der deltager i PISA-programmet (Program for International Student Assessment). Undersøgelsesdataene omfattede også data om studerendes VK-konti (3.483 studerende accepterede at give disse oplysninger).
”Siden sådanne data kombineret med digitalspor er vanskelige at få, de bruges næsten aldrig, ”forklarer Smirnov. I mellemtiden tillader et sådant datasæt en robust model, der kan anvendes på andre parametre. Og resultaterne kan ekstrapoleres til alle andre gymnasieelever og gymnasieelever.
Som en træningsprøve brugte vibeskeder fra offentlige sider "VKontakte" - i alt 130.575 beskeder fra 2.468 personer, der bestod PISA-testen i 2012. Testen tillod forskeren at vurdere den studerendes akademiske evne såvel som hans evne til at demonstrere sin viden i praksis. Undersøgelsen omfattede kun offentligt tilgængelige VKontakte-meddelelser fra aftalte deltagere.
Under undersøgelsen blev der udført uovervåget maskinlæring med vektorrepræsentation af ord i VKontakte post-corpus (1,9 milliarder ord i alt, med 2,5 millioner unikke ord).
”Vi har præsenteret hvert indlæg i form af et 300-dimensioneltvektor ved at beregne et gennemsnit af vektorrepræsentationen af alle dets ord, ”forklarer Smirnov. "Disse postvisninger blev brugt til at træne en lineær regressionsmodel til at forudsige klassificeringerne af PISA-forfatterne."
Ved "forudsigelse" forskerenbetyder ikke at forudsige fremtiden, men en sammenhæng mellem de beregnede resultater og de faktiske scores opnået af studerende på PISA-eksamenen, såvel som deres Unified State Examination-resultater (som er offentligt tilgængelige på internettet i aggregeret form – dvs. disse er gennemsnitlige score i skolen). På det indledende stadium lærte modellen at forudsige PISA-data. I den endelige model blev beregningerne sammenlignet med resultaterne af Unified State Examen for gymnasieuddannede og -ansøgere.
Den endelige model skulle være i stand til atpålideligt genkende, om en stærk eller svag studerende skrev et specifikt indlæg på et socialt netværk eller med andre ord differentiere emner efter deres akademiske præstationer. Efter en træningsperiode var modellen i stand til at skelne meddelelser skrevet af studerende med høje eller lave PISA-score (niveau 5-6 og niveau 0-1) med en nøjagtighed på 93,7%. Med hensyn til sammenligneligheden af PISA og USE, selvom de to tests er forskellige, har forskning vist, at de studerendes præstationer på disse to tests er stærkt korreleret med hinanden.
Det viste sig, at ”forudsagt akademisk præstation er tætforbundet med resultaterne af eksamen, ”siger Smirnov. ”Korrelationskoefficienten er mellem 0,49 og 0,6. Og i tilfældet med universiteter, når forudsagte akademiske præstationer og USE-ansøgerscore blev sammenlignet (information tilgængelig i den aktuelle undersøgelse, Monitoring the quality of university admissions), viste resultaterne også et stærkt forhold. Korrelationskoefficienten er 0,83, hvilket er signifikant højere end for gymnasiet, fordi flere data. "
Resultater
Smirnov fremhævede almindelige tekstfunktionerstillinger i forhold til deres forfatteres fremskridt. Brugen af hovedord (-0.08), humørikoner (-0.06) og udråb (-0.04) viste sig at være negativt korreleret med akademisk præstation. På den anden side er brugen af latinske tegn, gennemsnitlig meddelelses- og ordlængde, ordforrådsstørrelse og entropi af brugertekster positivt korreleret med akademisk præstation (henholdsvis fra 0,07 til 0,16).
Det er også blevet bekræftet, at elever med forskellige præstationsniveauer har forskelligt ordforråd.
Brugte studerende med høj præstation:
- Engelske ord;
- Litterære ord (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Læsekoncepter (læs, udgiv, bog, bind);
- Termer og navne relateret til fysik (Univers, kvante, teori, Einstein, Newton, Hawking);
- Ord relateret til tankeprocesser (tænkning, memorisering).
Studerende med lave score brugte ord medfejl, navne på populære computerspil, begreber relateret til militærtjeneste (hær, ed osv.), horoskopudtryk (Vædderen, Skytten) og ord relateret til kørsel og bilulykker (kollision, trafikpoliti, hjul, tuning).
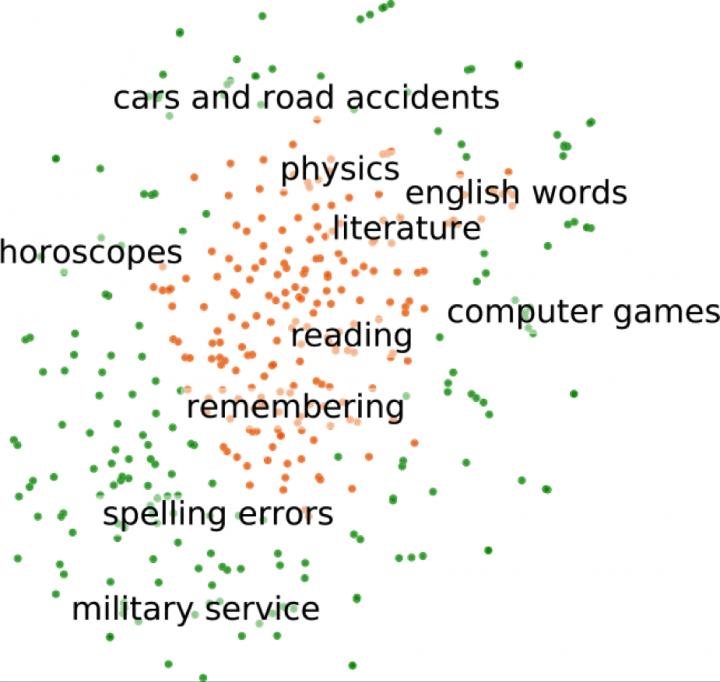 Tematiske klynger: Repræsenterer de højeste og laveste pointord fra træningsdatasættet
Smirnov beregnede koefficienterne for alle 2,5 mioord fra vektormodellen og gav dem til yderligere undersøgelse. Interessant nok kan selv ord, der er sjældne i træningsdatasættet, forudsige akademisk præstation. For eksempel, selvom navnet "Newt" (som Harry Potter-karakteren Newt Scamander) aldrig optræder i træningsdataene, kan modellen tildele en højere vurdering til beskeder, der indeholder det. Det vil ske, hvis modellen erfarer, at ord fra romanserien bliver brugt af højtpræsterende elever, og gennem uovervåget læring forstår modellen "intuitivt" at navnet "Newt" falder ind under denne kategori.
Læs også
Den årlige mission i Arktis er afsluttet, og dataene er skuffende. Hvad venter menneskeheden?
Se den nye Hummer overvinde forhindringer på vejen, bevæge sig som en krabbe
På sygdom 3 mister de fleste COVID-19 patienter deres lugtesans og lider ofte af en løbet næse