Jedes Wort in der Analyse hat seine eigene Bewertung. Diskussion wissenschaftlicher und kultureller Themen, Verwendung der englischen Sprache
Die Studie wurde durch ein Stipendium der Russian Science Foundation unterstützt.
Smirnovs Studie verwendeteine repräsentative Datenauswahl aus der HSE-Längsschnitt-Kohortenpanelstudie „Educational and Career Trajectories“ (TrEC). Die Studie verfolgt die Karriereentwicklung von 4.400 Studierenden aus 42 Regionen Russlands von Universitäten, die am PISA-Programm (Program for International Student Assessment) teilnehmen. Zu den Studiendaten gehörten auch Daten zu den VK-Konten der Studierenden (3.483 studentische Teilnehmer erklärten sich bereit, diese Angaben zu machen).
„Da solche Daten mit digitalen kombiniertSpuren sind schwer zu bekommen, sie werden fast nie verwendet “, erklärt Smirnov. In der Zwischenzeit kann mit einem solchen Datensatz ein robustes Modell entwickelt werden, das auf andere Parameter angewendet werden kann. Und die Ergebnisse können auf alle anderen Schüler hochgerechnet werden - Schüler und Schüler.
Als Trainingsbeispiel haben wir verwendetNachrichten von öffentlichen VKontakte-Seiten - insgesamt 130.575 Nachrichten von 2.468 Personen, die den PISA-Test 2012 bestanden haben. Der Test ermöglichte es dem Forscher, die akademischen Fähigkeiten des Studenten sowie seine Fähigkeit, sein Wissen in der Praxis zu demonstrieren, zu bewerten. Die Studie umfasste nur öffentlich zugängliche VKontakte-Nachrichten von vereinbarten Teilnehmern.
Während der Studie wurde unbeaufsichtigtes maschinelles Lernen mit Vektordarstellung von Wörtern im VKontakte-Postkorpus durchgeführt (insgesamt 1,9 Milliarden Wörter, davon 2,5 Millionen eindeutige Wörter).
„Wir haben jeden Beitrag als 300-dimensional dargestelltVektor durch Mittelung der Vektordarstellungen aller seiner konstituierenden Wörter “, erklärt Smirnov. "Diese Post-Ansichten wurden verwendet, um ein lineares Regressionsmodell zu trainieren, um die Bewertungen der PISA-Post-Autoren vorherzusagen."
Durch „Vorhersage“ der Forscherbedeutet nicht, die Zukunft vorherzusagen, sondern eine Korrelation zwischen den berechneten Ergebnissen und den tatsächlichen Ergebnissen, die die Schüler bei der PISA-Prüfung erzielt haben, sowie ihren Ergebnissen beim Einheitlichen Staatsexamen (die im Internet in aggregierter Form öffentlich verfügbar sind – d. h. diese sind es). Durchschnittsnoten in der Schule). Im Vorfeld lernte das Modell, PISA-Daten vorherzusagen. Im endgültigen Modell wurden die Berechnungen mit den Ergebnissen der Einheitlichen Staatsprüfung von Abiturienten und Bewerbern verglichen.
Das endgültige Modell sollte es könnenErkennen Sie zuverlässig, ob ein starker oder schwacher Schüler einen bestimmten Beitrag in einem sozialen Netzwerk verfasst hat, oder unterscheiden Sie die Fächer mit anderen Worten nach ihrer akademischen Leistung. Nach einer Einarbeitungszeit konnte das Modell Nachrichten von Schülern mit hohen oder niedrigen PISA-Werten (Stufen 5-6 und Stufen 0-1) mit einer Genauigkeit von 93,7% unterscheiden. In Bezug auf die Vergleichbarkeit von PISA und USE haben Untersuchungen gezeigt, dass die Leistung der Schüler bei diesen beiden Tests in hohem Maße miteinander korreliert, obwohl sich die beiden Tests unterscheiden.
Es stellte sich heraus, dass „die vorhergesagten akademischen Leistungen eng sindverbunden mit den Ergebnissen der Prüfung "- sagt Smirnov. „Der Korrelationskoeffizient liegt zwischen 0,49 und 0,6. Und im Fall von Universitäten zeigten die Ergebnisse beim Vergleich der prognostizierten akademischen Leistung und der USE-Werte (Informationen in der aktuellen Studie, Überwachung der Qualität der Hochschulzulassungen) ebenfalls eine starke Beziehung. Der Korrelationskoeffizient beträgt 0,83, was deutlich höher ist als für die High School, weil mehr Daten. "
Ergebnisse
Smirnov hob allgemeine Textmerkmale hervorBeiträge in Bezug auf den Fortschritt ihrer Autoren. Die Verwendung von Stichwörtern (-0,08), Emoticons (-0,06) und Ausrufen (-0,04) korrelierte negativ mit der akademischen Leistung. Andererseits korrelieren die Verwendung lateinischer Zeichen, die durchschnittliche Nachrichten- und Wortlänge, die Vokabulargröße und die Entropie von Benutzertexten positiv mit der akademischen Leistung (von 0,07 bis 0,16).
Es wurde auch bestätigt, dass Schüler mit unterschiedlichen Leistungsniveaus über einen unterschiedlichen Wortschatz verfügen.
Leistungsstarke Schüler verwendet:
- Englische Wörter;
- Literaturbezogene Wörter (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Lesekonzepte (lesen, veröffentlichen, buchen, Band);
- Begriffe und Namen in Bezug auf Physik (Universum, Quantum, Theorie, Einstein, Newton, Hawking);
- Wörter, die sich auf Denkprozesse beziehen (Denken, Auswendiglernen).
Schüler mit niedrigen Punktzahlen verwendeten Wörter mitFehler, Namen beliebter Computerspiele, Konzepte im Zusammenhang mit dem Militärdienst (Armee, Eid usw.), Horoskopbegriffe (Widder, Schütze) und Wörter im Zusammenhang mit Fahren und Autounfällen (Kollision, Verkehrspolizei, Räder, Tuning).
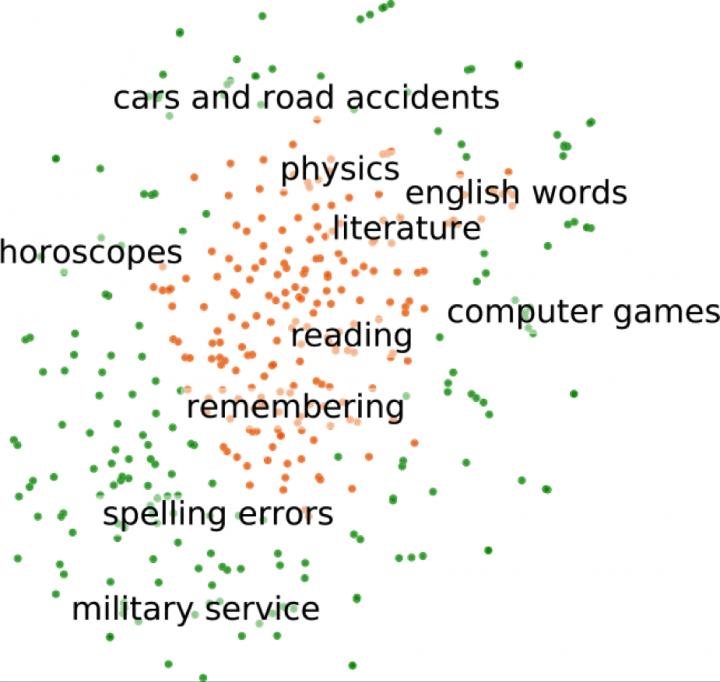 Thematische Cluster: Darstellung der Wörter mit der höchsten und niedrigsten Punktzahl aus dem Trainingsdatensatz
Smirnov berechnete die Koeffizienten für alle 2,5 MillionenWörter des Vektormodells und stellte sie für weitere Untersuchungen bereit. Interessanterweise können selbst Wörter, die im Trainingsdatensatz selten vorkommen, die akademische Leistung vorhersagen. Selbst wenn beispielsweise der Name „Newt“ (wie in der Harry-Potter-Figur Newt Scamander) nie im Trainingsdatensatz erscheint, kann das Modell Nachrichten, die ihn enthalten, eine höhere Bewertung zuweisen. Dies geschieht, wenn das Modell erfährt, dass Wörter aus der Romanreihe von leistungsstarken Schülern verwendet werden, und durch unbeaufsichtigtes Lernen „intuitiv“ versteht, dass der Name „Newt“ in diese Kategorie fällt.
Lesen Sie auch
Die jährliche Mission in der Arktis ist beendet und die Daten sind enttäuschend. Was erwartet die Menschheit?
Beobachten Sie, wie der neue Hummer Hindernisse auf der Straße überwindet und sich wie eine Krabbe bewegt
Am dritten Krankheitstag verlieren die meisten COVID-19-Patienten ihren Geruchssinn und leiden häufig an einer laufenden Nase