Zufälliger Veranstaltungsraum
1946 schlug der amerikanische Statistiker John Tukey den Namen BIT vor
Stellen Sie sich einen Raum mit zufälligen Ereignissen vordie besteht aus dem Werfen einer falschen Münze, auf deren beiden Seiten sich ein Adler befindet. Wann fällt ein Adler? Es ist klar, dass immer. Wir wissen das im Voraus, weil unser Raum so angeordnet ist. Das Fallen eines Adlers ist ein verlässliches Ereignis, das heißt, seine Wahrscheinlichkeit ist gleich 1. Geben wir viele Informationen, wenn wir über einen gestürzten Adler sprechen? Nein. Die Menge an Informationen in einer solchen Nachricht wird als 0 betrachtet.
Werfen wir nun die faire Münze:Auf der einen Seite sind es Köpfe, auf der anderen Zahl, wie es sein sollte. Das Landen von Kopf oder Zahl wird zwei verschiedene Ereignisse sein, die unseren Raum für zufällige Ereignisse ausmachen. Wenn wir das Ergebnis eines Wurfs melden, handelt es sich tatsächlich um neue Informationen. Wenn Köpfe fallen gelassen werden, melden wir 0, und wenn Zahlen 1 sind. Um diese Informationen zu melden, benötigen wir nur 1 Bit.
Was hat sich geändert?In unserem Veranstaltungsraum ist Unsicherheit aufgetaucht. Wir haben jemandem etwas davon zu erzählen, der nicht selbst eine Münze wirft und das Ergebnis des Wurfs nicht sieht. Aber um unsere Botschaft richtig zu verstehen, muss er genau wissen, was wir tun und was die Nullen und Einsen bedeuten.Unsere Event Spaces müssen übereinstimmen, und der Dekodierungsprozess dient ausschließlich dazu, das Wurfergebnis wiederherzustellen.Wenn der Ereignisraum von Sender und Empfänger nicht übereinstimmt oder keine Möglichkeit zur eindeutigen Decodierung der Nachricht besteht, bleiben die Informationen im Kommunikationskanal nur Rauschen.
Wenn Sie zwei unabhängig voneinander und gleichzeitig werfenMünzen, dann gibt es vier verschiedene gleichwahrscheinliche Ergebnisse: Kopf-Kopf, Kopf-Zahl, Zahl-Kopf und Zahl-Zahl. Um Informationen zu übertragen, benötigen wir 2 Bits und unsere Nachrichten lauten wie folgt: 00, 01, 10 und 11. Es gibt doppelt so viele Informationen. Dies geschah, weil die Unsicherheit zunahm. Wenn wir versuchen, das Ergebnis eines solchen Paarwurfs zu erraten, ist die Wahrscheinlichkeit, dass wir falsch liegen, doppelt so hoch.
Je größer die Unsicherheit des Ereignisraums ist, desto mehr Informationen enthält die Nachricht über seinen Zustand.
Machen wir unseren Veranstaltungsraum etwas komplizierter.Bisher waren alle eingetretenen Ereignisse gleich wahrscheinlich. Aber in realen Räumen haben nicht alle Ereignisse die gleiche Wahrscheinlichkeit. Nehmen wir an, die Wahrscheinlichkeit, dass die Krähe, die wir sehen, schwarz ist, liegt nahe bei 1. Die Wahrscheinlichkeit, dass der erste Passant, den wir auf der Straße treffen, ein Mann ist, beträgt etwa 0,5. Aber auf den Straßen Moskaus einem Krokodil zu begegnen, ist fast unmöglich. Intuitiv verstehen wir, dass ein Bericht über ein Treffen mit einem Krokodil einen viel größeren Informationswert hat als über eine schwarze Krähe.Je geringer die Wahrscheinlichkeit eines Ereignisses ist, desto mehr Informationen werden in der Nachricht über ein solches Ereignis angezeigt.
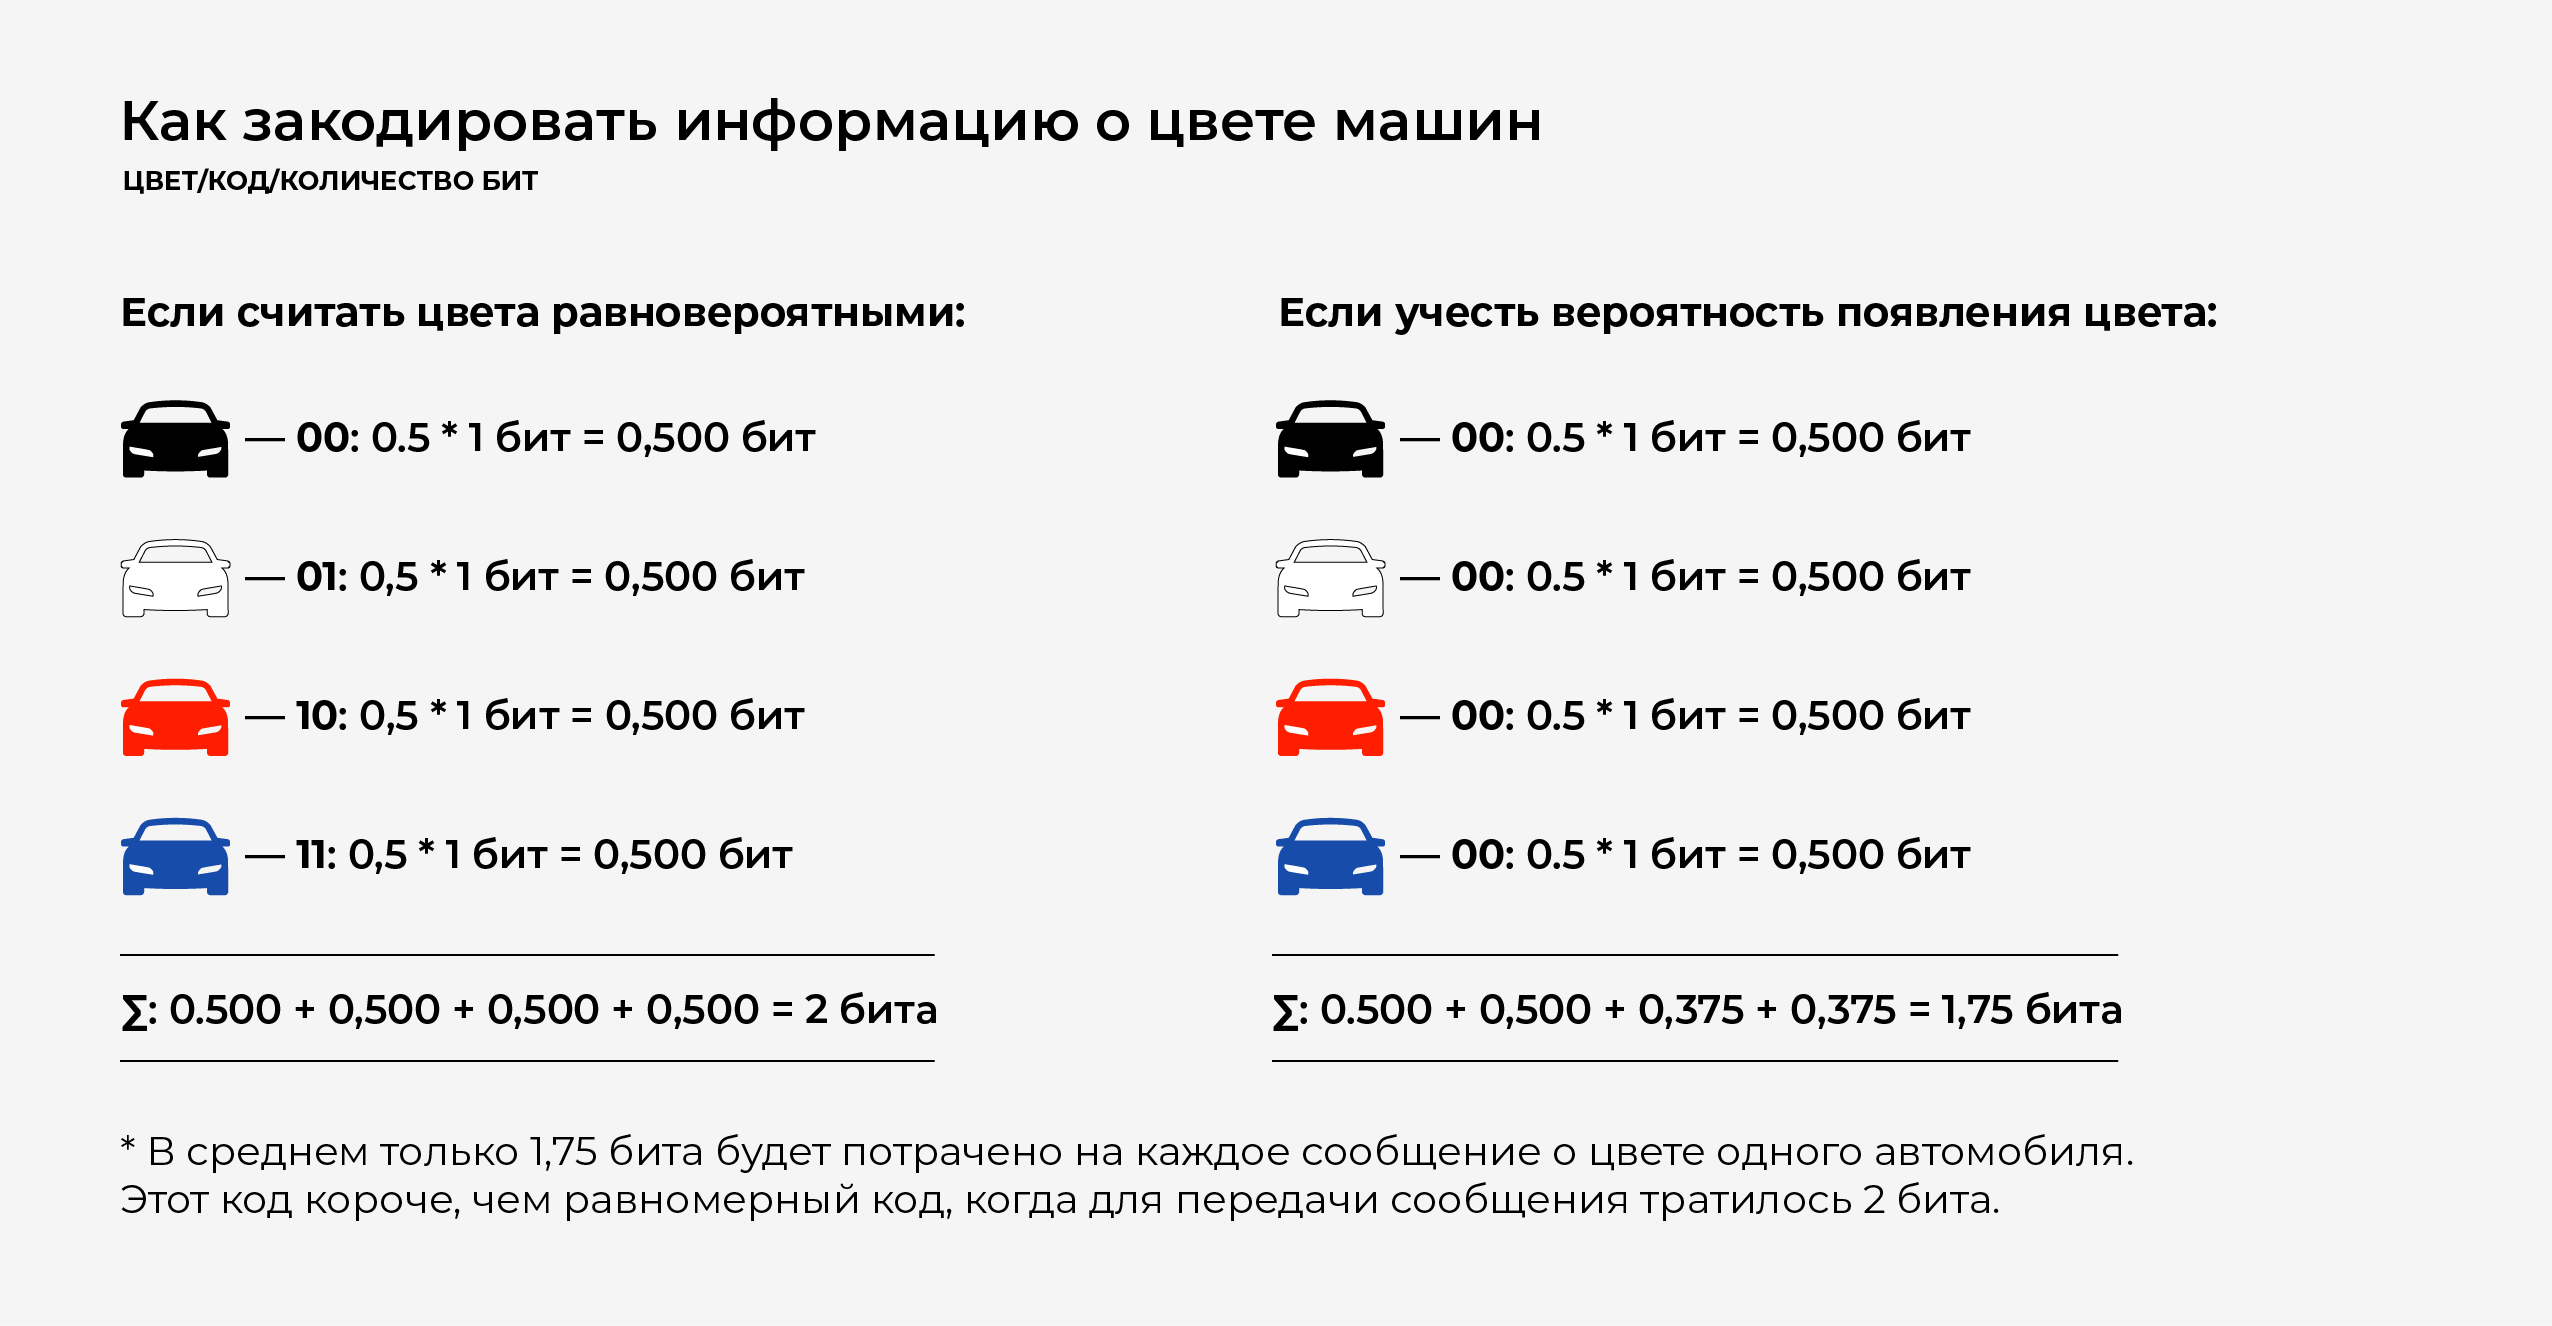
Lassen Sie den Veranstaltungsraum nicht so exotisch sein. Wir stehen einfach am Fenster und schauen auf die vorbeifahrenden Autos. Vierfarbige Autos ziehen vorbei, über die wir berichten müssen. Dazu kodieren wir die Farben: Schwarz - 00, Weiß - 01, Rot - 10, Blau - 11. Um genau zu berichten, welches Auto gefahren ist, müssen wir nur 2 Bits Informationen übertragen.
Aber die Autos beobachtend,Wir stellen fest, dass die Farbe der Autos ungleichmäßig verteilt ist: Schwarz - 50% (jede Sekunde), Weiß - 25% (jedes Viertel), Rot und Blau - 12,5% (jeder Achtel). Dann können Sie die übermittelten Informationen optimieren.
Die meisten Autos sind also schwarzBezeichnen wir Schwarz mit 0 als kürzesten Code und lassen Sie den Code aller anderen bei 1 beginnen. Von der verbleibenden Hälfte weiß Weiß 10 und die restlichen Farben beginnen bei 11. Schließlich bezeichnen wir Rot mit 110 und Blau mit 111.
Wenn wir nun Informationen über die Farbe des Autos weitergeben, können wir es enger kodieren.
Shannon Entropie
Unsere Veranstaltungsfläche bestehe aus nverschiedene Veranstaltungen. Beim Werfen einer Münze mit zwei Köpfen gibt es genau ein solches Ereignis, beim Werfen einer fairen Münze gibt es genau 2, beim Werfen von zwei Münzen oder beim Beobachten von Autos gibt es genau 4. Jedes Ereignis hat eine Wahrscheinlichkeit seines Eintretens. Beim Werfen einer Münze mit zwei Köpfen gibt es ein Ereignis (herausfallende Köpfe) und seine Wahrscheinlichkeit ist p1 = 1. Beim Werfen einer fairen Münze gibt es zwei Ereignisse, sie sind gleich wahrscheinlich und die Wahrscheinlichkeit beträgt jeweils 0,5: p1 = 0,5, p2 = 0,5. Beim Werfen zweier fairer Münzen gibt es vier Ereignisse, die alle gleich wahrscheinlich sind und deren Wahrscheinlichkeit jeweils 0,25 beträgt: p1 = 0,25, p2 = 0,25, p3 = 0,25, p4 = 0,25. Bei der Beobachtung von Autos gibt es vier Ereignisse mit unterschiedlichen Wahrscheinlichkeiten: Schwarz – 0,5, Weiß – 0,25, Rot – 0,125, Blau – 0,125: p1 = 0,5, p2 = 0,25, p3 = 0,125, p4 = 0,125.
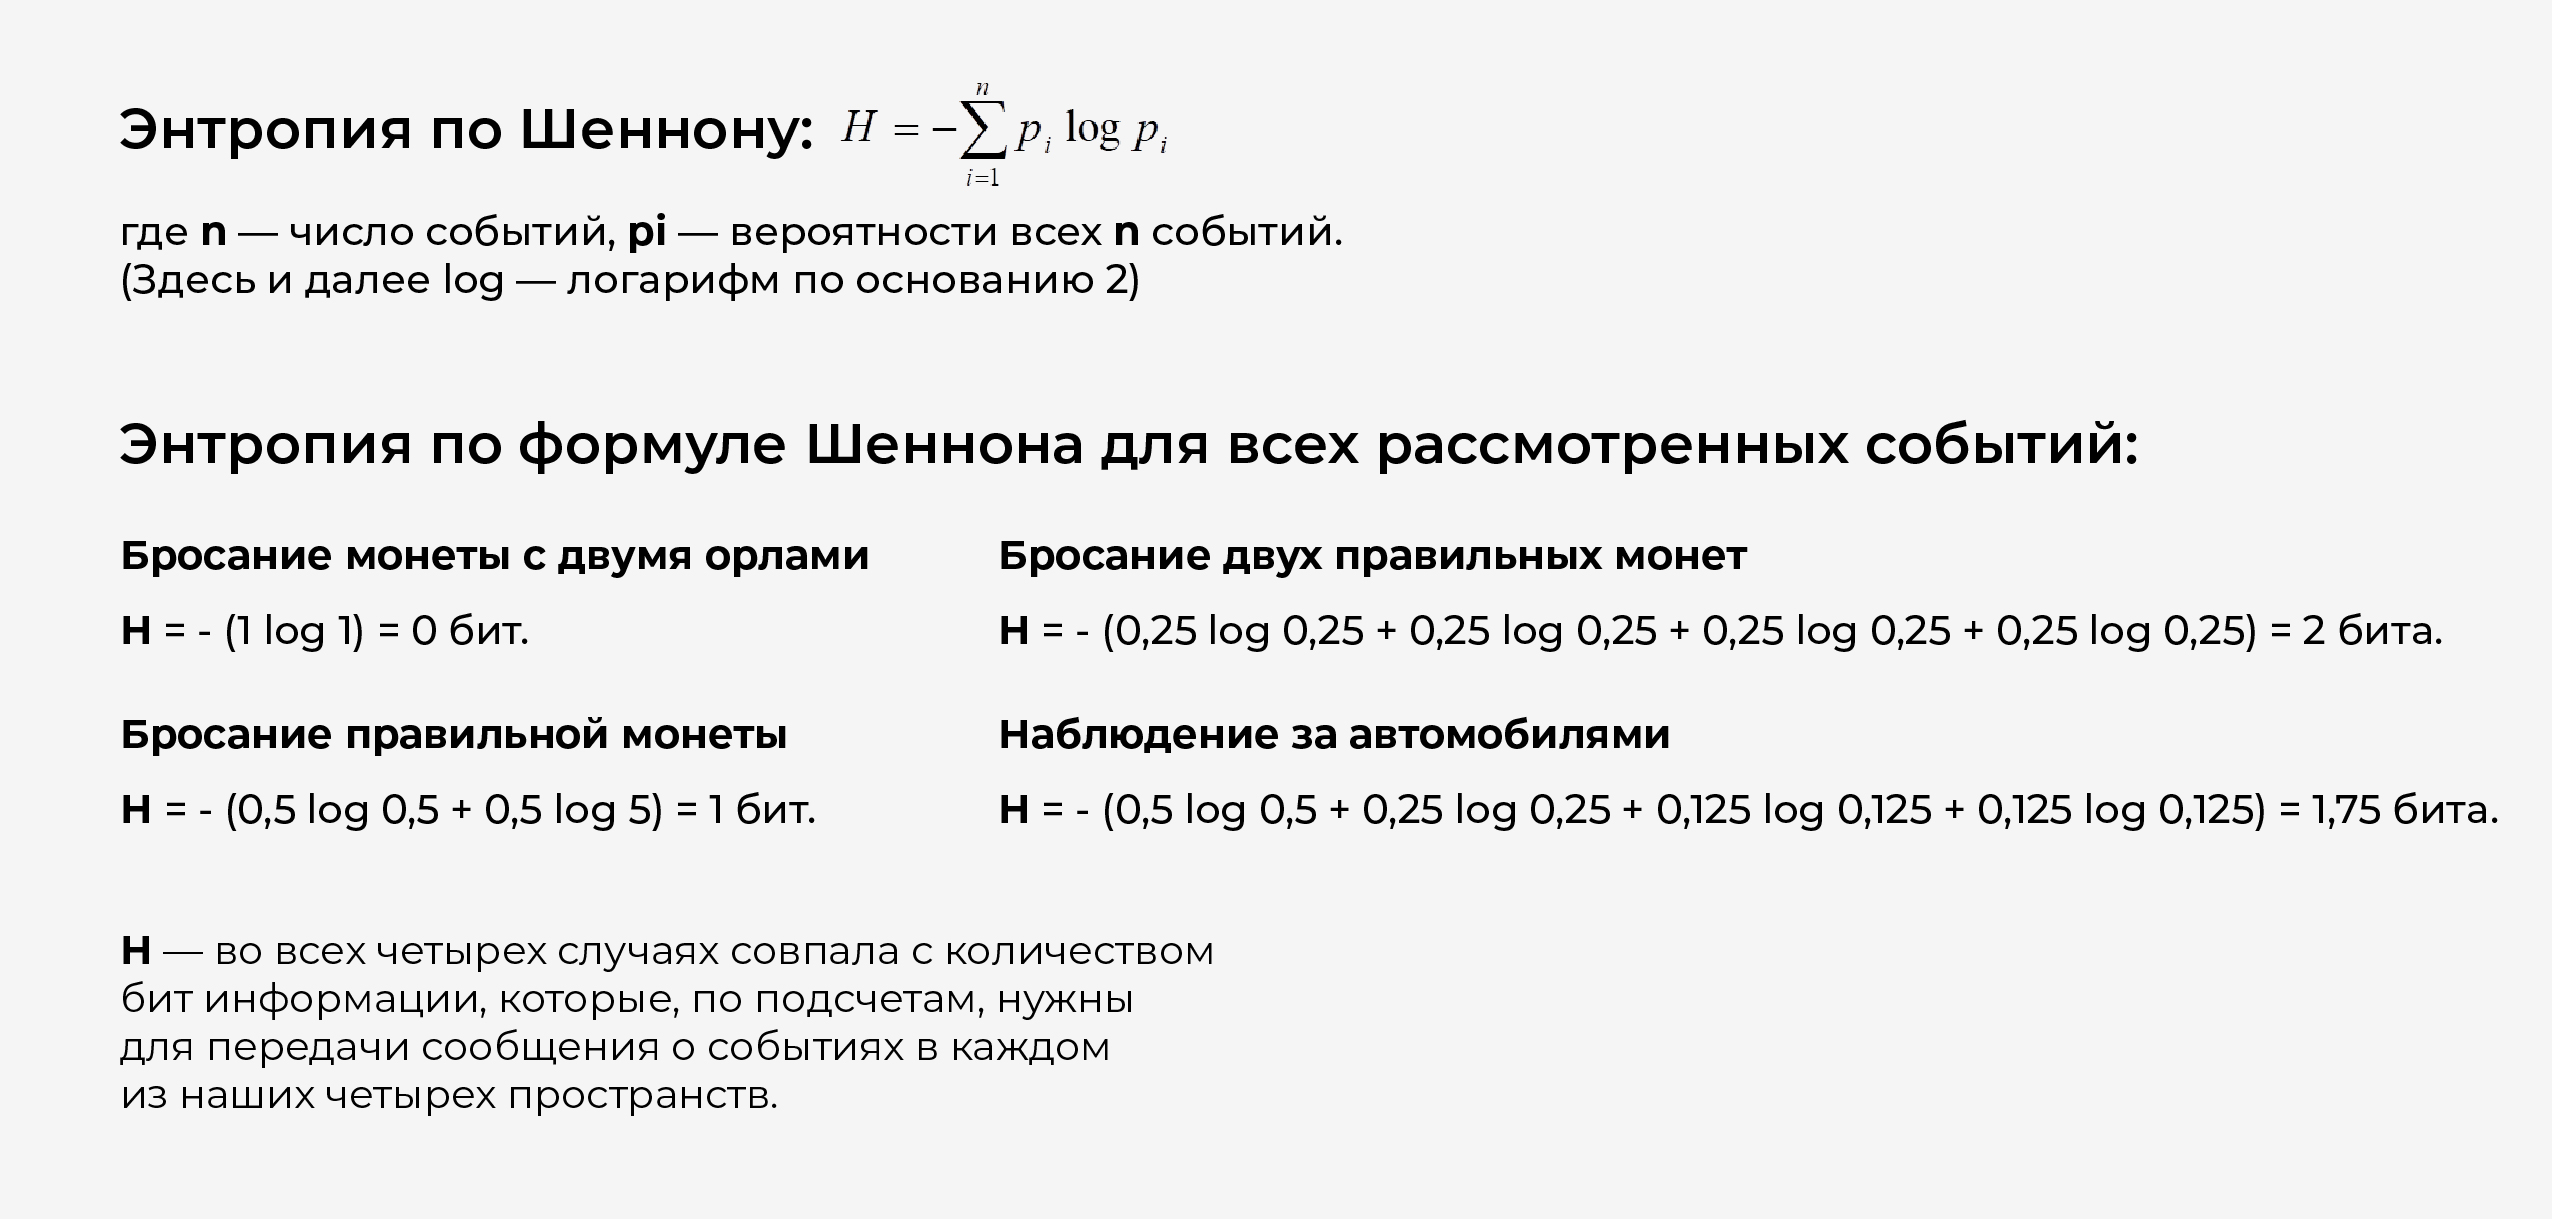
Das ist kein Zufall.Shannon wählte die Entropie (ein Maß für die Unsicherheit im Veranstaltungsraum), so dass drei Bedingungen erfüllt waren:
- 1Die Entropie eines zuverlässigen Ereignisses, dessen Wahrscheinlichkeit 1 ist, ist gleich 0.
- Die Entropie zweier unabhängiger Ereignisse entspricht der Summe der Entropien dieser Ereignisse.
- Die Entropie ist maximal, wenn alle Ereignisse gleich wahrscheinlich sind.
Alle diese Anforderungen stimmen voll und ganz mit unseren übereinVorstellungen über die Unsicherheit des Veranstaltungsraums. Wenn es nur ein Ereignis gibt (das erste Beispiel), besteht keine Unsicherheit. Wenn die Ereignisse unabhängig sind – die Unsicherheit der Summe ist gleich der Summe der Unsicherheiten – addieren sie sich einfach (das Beispiel des Werfens zweier Münzen). Und schließlich: Wenn alle Ereignisse gleich wahrscheinlich sind, ist der Grad der Unsicherheit des Systems maximal. Da beim Werfen von zwei Münzen alle vier Ereignisse gleich wahrscheinlich sind und die Entropie 2 beträgt, ist sie größer als bei Autos, bei denen es ebenfalls vier Ereignisse gibt, diese aber unterschiedliche Wahrscheinlichkeiten haben – in diesem Fall beträgt die Entropie 1,75.
Die Größe H spielt in der Informationstheorie als Maß für Information, Auswahl und Unsicherheit eine zentrale Rolle.
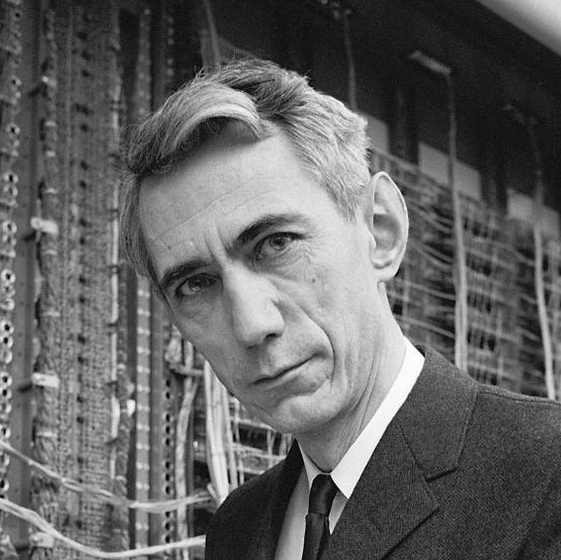
Claude Shannon
Claude Elwood Shannon- US-amerikanischer Ingenieur, Kryptoanalytiker undMathematiker. Gilt als „Vater des Informationszeitalters“. Begründer der Informationstheorie, die in modernen High-Tech-Kommunikationssystemen Anwendung gefunden hat. Bereitstellung grundlegender Konzepte, Ideen und ihrer mathematischen Formulierungen, die derzeit die Grundlage für moderne Kommunikationstechnologien bilden.
1948 vorgeschlagen, das Wort "Bit" zu verwendenum die kleinste Informationseinheit anzuzeigen. Er zeigte auch, dass die von ihm eingegebene Entropie der Unsicherheit der Informationen in der übermittelten Nachricht entspricht. Shannons Artikel "Mathematische Kommunikationstheorie" und "Kommunikationstheorie in geheimen Systemen" gelten als grundlegend für die Informationstheorie und Kryptographie.
Während des Zweiten Weltkriegs arbeitete Shannon in den Bell Laboratories an der Entwicklung kryptografischer Systeme, die ihm später dabei halfen, fehlerkorrigierende Codierungsmethoden zu entdecken.
Shannon leistete einen wichtigen Beitrag zur Theorie probabilistischer Schemata, Spieltheorie, Automatentheorie und Theorie des Steuersystems - Bereiche der Wissenschaft, die Teil des Begriffs der Kybernetik sind.
Codierung
Und geworfene Münzen und vorbeifahrende Autos sind es nichtsind den Zahlen 0 und 1 ähnlich. Um Ereignisse in Leerzeichen zu melden, müssen Sie sich eine Möglichkeit vorstellen, diese Ereignisse zu beschreiben. Diese Beschreibung wird als Codierung bezeichnet.
Nachrichten können auf unendlich viele verschiedene Arten kodiert werden. Aber Shannon zeigte, dass der kürzeste Code nicht kleiner als die Entropie sein kann.
Deshalb ist die Entropie einer Nachricht ein MaßInformationen in der Nachricht. Da in allen betrachteten Fällen die Anzahl der Bits bei der Kodierung gleich der Entropie ist, bedeutet dies, dass die Kodierung optimal war. Kurz gesagt, es ist nicht mehr möglich, Nachrichten über Ereignisse in unseren Räumen zu verschlüsseln.
Bei optimaler Codierung können Sie nicht verlieren oderein einzelnes übertragenes Bit in der Nachricht verzerren. Wenn auch nur ein Bit verloren geht, werden die Informationen verfälscht. Aber nicht alle echten Kommunikationskanäle bieten eine hundertprozentige Sicherheit, dass alle Teile der Nachricht den Empfänger unverfälscht erreichen.
Um dieses Problem zu beheben, müssen Sie Folgendes tunDer Code ist nicht optimal, aber redundant. Übermitteln Sie beispielsweise zusammen mit der Nachricht ihre Prüfsumme – einen speziell berechneten Wert, der bei der Konvertierung des Nachrichtencodes erhalten wird und der durch Neuberechnung beim Empfang der Nachricht überprüft werden kann. Wenn die übermittelte Prüfsumme mit der berechneten übereinstimmt, ist die Wahrscheinlichkeit, dass die Übertragung fehlerfrei war, recht hoch. Und wenn die Prüfsumme nicht übereinstimmt, muss eine erneute Übertragung angefordert werden. In etwa funktionieren die meisten Kommunikationskanäle heute, beispielsweise bei der Übertragung von Informationspaketen über das Internet.
Nachrichten in natürlicher Sprache
Betrachten Sie den Veranstaltungsraum, der bestehtaus Beiträgen in natürlicher Sprache. Dies ist ein Sonderfall, aber einer der wichtigsten. Die Ereignisse hier sind die übertragenen Zeichen (Buchstaben eines festen Alphabets). Diese Zeichen werden in der Sprache mit unterschiedlichen Wahrscheinlichkeiten gefunden.
Das Symbol mit der höchsten Frequenz (d. Hist meistens in allen in Russisch geschriebenen Texten ein Leerzeichen: von tausend Zeichen wird ein durchschnittliches Leerzeichen 175 Mal gefunden. Das zweite in der Häufigkeit ist das Symbol "o" - 90, gefolgt von anderen Vokalen: "e" (oder "e" - wir unterscheiden sie nicht) - 72, "a" - 62 und i - 62 und nur weiter der erste Konsonant "t" - 53. Und das seltenste "f" - dieses Symbol wird nur zweimal pro tausend Zeichen gefunden.
Wir werden das 31-stellige Alphabet des Russischen verwendenSprache (es unterscheidet sich nicht zwischen "e" und "e" sowie "ъ" und "ь"). Wenn alle Buchstaben in der Sprache mit der gleichen Wahrscheinlichkeit angetroffen wurden, wäre die Entropie pro Symbol H = 5 Bits. Wenn wir jedoch die tatsächlichen Häufigkeiten der Symbole berücksichtigen, ist die Entropie geringer: H = 4,35 Bits. (Dies ist fast zweimal so viel wie bei der herkömmlichen Codierung, wenn ein Zeichen als Byte übertragen wird - 8 Bit).
Die Entropie des Zeichens in der Sprache ist jedoch noch geringer. Die Wahrscheinlichkeit des Auftretens des nächsten Zeichens ist in allen Texten nicht vollständig durch die durchschnittliche Häufigkeit des Zeichens vorgegeben. Welches Zeichen folgt, hängt von den bereits übertragenen Zeichen ab. Zum Beispiel kann im modernen Russisch das Symbol "ъ" nicht dem Konsonantensymbol folgen. Nach zwei aufeinanderfolgenden Vokalen "e" folgt der dritte Vokal "e" äußerst selten, es sei denn im Wort "langhalsig". Das nächste Zeichen ist also gewissermaßen vorbestimmt. Wenn wir diese Vorbestimmtheit des nächsten Symbols berücksichtigen, ist die Unsicherheit (das heißt die Information) des nächsten Symbols sogar weniger als 4,35. Nach einigen Schätzungen ist das folgende Symbol in Russisch durch die Struktur der Sprache um mehr als 50% vorgegeben, dh bei optimaler Kodierung können alle Informationen übertragen werden, indem die Hälfte der Buchstaben aus der Nachricht gelöscht wird.
Eine andere Sache ist, dass nicht jeder Brief sicher gelöscht werden kann. Hochfrequentes "o" (und allgemein Vokale) zum Beispiel ist leicht zu streichen, aber seltenes "f" oder "e" ist ziemlich problematisch.
Die natürliche Sprache, in der wir miteinander kommunizieren, ist hochredundant und daher zuverlässig; wenn wir etwas falsch verstanden haben, ist das kein Problem, die Informationen werden trotzdem übermittelt.
Aber bis Shannon das Maß der Informationen einführte, konnten wir nicht verstehen, dass die Sprache überflüssig ist und in welchem Umfang wir Nachrichten komprimieren können (und warum Textdateien vom Archivierer so gut komprimiert werden).
Redundanz in natürlicher Sprache
Im Artikel "Wie wir vorpsimanie tektkt"(Der Name hört sich genau so an!) Ein Fragment von Ivan Turgenevs Roman "Noble Nest" wurde genommen und einer Transformation unterzogen: 34% der Buchstaben, jedoch keine zufälligen, wurden aus dem Fragment gelöscht. Die ersten und letzten Buchstaben in Wörtern waren übriggeblieben, nur Vokale wurden gelöscht und nicht alle. Das Ziel bestand nicht nur darin, die Möglichkeit zu erhalten, alle Informationen über den konvertierten Text wiederherzustellen, sondern auch sicherzustellen, dass die Person, die diesen Text liest, keine besonderen Schwierigkeiten aufgrund fehlender Buchstaben hatte.

Warum ist es relativ einfach, dies fehlerhaft zu lesen?Text? Es enthält tatsächlich die notwendigen Informationen, um ganze Wörter zu rekonstruieren. Ein russischer Muttersprachler verfügt über eine bestimmte Reihe von Ereignissen (Wörter und ganze Sätze), die er zur Erkennung verwendet. Darüber hinaus stehen dem Sprecher auch standardisierte Sprachstrukturen zur Verfügung, die ihm bei der Informationsgewinnung helfen. Zum Beispiel,"Sie ist blae blee"- kann mit hoher Wahrscheinlichkeit gelesen werden als"Sie war empfindlicher.". Aber separat genommen"Sie ist mehr bla", sondern wird wiederhergestellt als"Sie war weißer". Denn in der alltäglichen Kommunikation beschäftigen wir unsBei Kanälen, in denen es Rauschen und Interferenzen gibt, sind wir recht gut darin, Informationen wiederherzustellen, aber nur das, was wir bereits im Voraus kennen. Zum Beispiel der Satz"Ihre Gesichtszüge sind nicht im geringsten angenehm, htya nmngo rspkhli und spritzen"liest sich bis auf das letzte Wort gut"Splash" - "sammelte sich". Dieses Wort kommt im modernen Lexikon nicht vor. Beim schnellen Lesen eines Wortes"Spritzen"liest sich eher wie „zusammengeklebt“; wenn es langsam ist, verblüfft es einfach.
Signaldigitalisierung
Klang oder akustische Schwingungen sind Sinus. Dies ist beispielsweise auf dem Bildschirm des Sound-Editors zu sehen. Um den Klang genau zu vermitteln, benötigen Sie unendlich viele Werte - die gesamte Sinuswelle. Dies ist bei einer analogen Verbindung möglich. Er singt - Sie hören zu, der Kontakt wird nicht unterbrochen, solange das Lied dauert.
Bei der digitalen Kommunikation über einen Kanal können wir nur eine endliche Anzahl von Werten übertragen. Bedeutet das, dass der Ton nicht genau wiedergegeben werden kann? Es stellt sich heraus, dass dies nicht der Fall ist.
Unterschiedliche Klänge sind eine unterschiedlich modulierte Sinuswelle.Wir übertragen nur diskrete Werte (Frequenzen und Amplituden), und die Sinuswelle selbst muss nicht gesendet werden - das empfangende Gerät kann sie erzeugen.Es erzeugt eine Sinuskurve und wird dieser überlagertModulation, die aus über einen Kommunikationskanal übertragenen Werten erstellt wird. Es gibt genaue Prinzipien, nach denen diskrete Werte übertragen werden müssen, damit der Ton am Eingang des Kommunikationskanals mit dem Ton am Ausgang übereinstimmt, wobei diese Werte einer Standard-Sinuskurve überlagert werden (das ist der Satz von Kotelnikov). um).
Satz von Kotelnikov (in der englischsprachigen Literatur - der Nyquist - Shannon-Satz, der Lesesatz)- eine grundsätzliche Aussage im Bereich DigitalSignalverarbeitung, die kontinuierliche und diskrete Signale verbindet und besagt, dass „jede Funktion F(t), bestehend aus Frequenzen von 0 bis f1, kontinuierlich mit beliebiger Genauigkeit übertragen werden kann, indem Zahlen verwendet werden, die über 1/(2*f1) Sekunden aufeinander folgen.“
Anti-Interferenz-Codierung Hamming-Codes
Wenn auf einem unzuverlässigen Kanal übertragenDer verschlüsselte Text von Ivan Turgenev führt, wenn auch mit einigen Fehlern, zu einem recht aussagekräftigen Text. Wenn wir jedoch alles bis zu einem gewissen Grad übertragen müssen, ist die Aufgabe nicht gelöst: Wir wissen nicht, welche Bits falsch sind, da der Fehler zufällig ist. Auch die Prüfsumme spart nicht immer.
Deshalb heute bei der Datenübertragung weiterNetzwerke neigen nicht so sehr zu einer optimalen Codierung, bei der die maximale Informationsmenge in den Kanal geschoben werden kann, sondern zu einer solchen Codierung (offensichtlich redundant), bei der Fehler behoben werden können - genau wie beim Lesen der Wörter in Ivan Turgenevs Fragment.
Es gibt spezielle Fehlerkorrekturcodes, mit denen Sie Informationen nach einem Fehler wiederherstellen können. Einer davon ist der Hamming-Code.Nehmen wir an, unsere gesamte Sprache besteht aus drei Wörtern:111000, 001110, 100011. Sowohl die Quelle der Nachricht als auch der Empfänger kennen diese Wörter. Und wir wissen, dass in einem Kommunikationskanal Fehler auftreten, aber bei der Übertragung eines Wortes wird nicht mehr als ein Bit der Information verzerrt.
Nehmen wir an, wir übergeben zuerst das Wort 111000. Als Ergebnis kann nicht mehr als ein Fehler (wir haben den Fehler identifiziert) zu einem der Wörter werden:
1) 111000,011.000, 101000, 110000, 111100, 111010, 111001.
Bei der Übertragung des Wortes 001110 kann eines der folgenden Wörter abgerufen werden:
2) 001110,101110, 011110, 000110, 001010, 001100, 001111.
Für 100011 können wir schließlich an der Rezeption erhalten:
3) 100011,000011, 110011, 101011, 100111, 100001, 100010.
Beachten Sie, dass alle drei Listen nicht paarweise sind.sich schneiden. Mit anderen Worten, wenn am anderen Ende des Kommunikationskanals ein Wort aus der Liste 1 erscheint, weiß der Empfänger mit Sicherheit, dass das Wort 111000 an ihn übertragen wurde, und wenn ein Wort aus der Liste 2 erscheint, erscheint das Wort 001110 und aus der Liste 3 das Wort 100011. Sie sagen, dass unser Code einen Fehler behoben hat.
Die Korrektur erfolgte aufgrund zweier Faktoren.Erstens kennt der Empfänger das gesamte "Wörterbuch"der Ereignisraum des Nachrichtenempfängers stimmt mit dem Raum desjenigen überein, der die Nachricht übertragen hat. Wenn der Code nur mit einem Fehler übertragen wurde, wurde ein Wort ausgegeben, das nicht im Wörterbuch enthalten war.
Zweitens wurden die Wörter im Wörterbuch auf besondere Weise ausgewählt.Selbst wenn ein Fehler auftrat, konnte der Empfänger dies nicht tunein Wort mit einem anderen verwechseln. Wenn das Wörterbuch beispielsweise aus den Wörtern „Tochter“, „Punkt“, „Beule“ besteht und das Ergebnis bei der Übertragung „Vochka“ lautete, wäre der Empfänger, der weiß, dass ein solches Wort nicht existiert, nicht dazu in der Lage Korrigieren Sie den Fehler – jedes der drei Wörter kann sich als richtig erweisen. Wenn das Wörterbuch „Punkt“, „Daw“ und „Zweig“ enthält und wir wissen, dass nicht mehr als ein Fehler erlaubt ist, dann ist „Vochka“ definitiv ein „Punkt“ und kein „Daw“. Bei fehlerkorrigierenden Codes werden Wörter genau so gewählt, dass sie auch nach einem Fehler „erkennbar“ sind. Der einzige Unterschied besteht darin, dass der Code „Alphabet“ nur aus zwei Buchstaben besteht – Null und Eins.
Die Redundanz einer solchen Kodierung ist sehr groß und die Anzahl der Wörter, die wir auf diese Weise vermitteln können, ist relativ klein.Wir müssen jedes Wort aus dem Wörterbuch ausschließen,die im Fehlerfall mit der gesamten Liste der übertragenen Wörter übereinstimmen kann (z. B. können die Wörter „Tochter“ und „Punkt“ nicht im Wörterbuch enthalten sein). Doch eine genaue Nachrichtenübermittlung ist so wichtig, dass große Anstrengungen in die Erforschung fehlerresistenter Codes gesteckt werden.
Sensation
Konzepte der Entropie (oder Unsicherheit undUnvorhersehbarkeit) der Nachricht und Redundanz (oder Vorbestimmung und Vorhersagbarkeit) entsprechen ganz natürlich unseren intuitiven Vorstellungen vom Informationsmaßstab. Je unberechenbarer die Nachricht ist (je größer ihre Entropie, weil die Wahrscheinlichkeit geringer ist), desto mehr Informationen trägt sie. Eine Sensation (zum Beispiel ein Treffen mit einem Krokodil auf Tverskaya) ist ein seltenes Ereignis, dessen Vorhersagbarkeit sehr gering ist und daher der Informationswert hoch ist. Informationen werden oft als Nachrichten bezeichnet - Berichte über Ereignisse, die soeben aufgetreten sind und von denen wir noch nichts wissen. Aber wenn sie uns vom zweiten und dritten Mal von den gleichen Wörtern erzählen, wird die Redundanz der Nachricht groß sein, ihre Unvorhersehbarkeit wird auf null sinken, und wir werden einfach nicht zuhören und vom Sprecher mit den Worten "Ich weiß, ich weiß" winken. Deshalb versuchen die Medien so sehr, die Ersten zu sein. Diese Entsprechung zum intuitiven Gefühl der Neuheit, die zu wirklich unerwarteten Nachrichten führt, spielte eine wichtige Rolle in der Tatsache, dass der Artikel von Shannon, der nicht für den allgemeinen Leser gedacht war, zu einer Sensation wurde, die von der Presse als universeller Schlüssel zum Wissen der Natur angenommen wurde. - von Linguisten und Literaturkritikern bis hin zu Biologen.
AberShannon Informationskonzept - strenge mathematische Theorieund seine Anwendung außerhalb der Kommunikationstheorie ist sehr unzuverlässig. In der Kommunikationstheorie selbst spielt sie jedoch eine zentrale Rolle.
Semantische Informationen
Shannon, der das Konzept der Entropie als Maß einführtInformationen erhielten die Möglichkeit, mit Informationen zu arbeiten – zunächst, um diese zu messen und Eigenschaften wie Kanalkapazität oder optimale Kodierung zu bewerten. Aber die Hauptannahme, die es Shannon ermöglichte, erfolgreich mit Informationen zu operieren, war die Annahme, dass die Erzeugung von Informationen ein zufälliger Prozess ist, der erfolgreich wahrscheinlichkeitstheoretisch beschrieben werden kann.Wenn der Prozess nicht zufällig ist, das heißt, er gehorcht den Gesetzen (außerdem ist es nicht immer klar, wie es in natürlicher Sprache geschieht), dann ist die Argumentation von Shannon für ihn nicht anwendbar.Nichts, was Shannon sagt, hat etwas damit zu tun, dass die Informationen aussagekräftig sind.
Während wir über Buchstaben (oder Buchstaben des Alphabets) sprechen,Wir können gut über zufällige Ereignisse argumentieren, aber sobald wir zu den Wörtern der Sprache kommen, wird sich die Situation dramatisch ändern. Sprache ist ein Prozess, der speziell organisiert ist, und hier ist die Struktur der Nachricht nicht weniger wichtig als die Zeichen, mit denen sie übertragen wird.
Noch vor Kurzem schien es, als ob wir nichts tun könnten.getan, um der Aussagekraft des Textes zumindest irgendwie näher zu kommen, aber in den letzten Jahren begann sich die Situation zu ändern. Und dies hängt vor allem mit dem Einsatz künstlicher neuronaler Netze für die Aufgaben der maschinellen Übersetzung, der automatischen Zusammenfassung von Texten, der Extraktion von Informationen aus Texten und der Erstellung von Berichten in natürlicher Sprache zusammen. Bei all diesen Aufgaben geht es um die Transformation, Kodierung und Dekodierung sinnvoller Informationen, die in natürlicher Sprache enthalten sind. Und nach und nach entsteht eine Vorstellung über den Informationsverlust bei solchen Transformationen und damit über den Umfang sinnvoller Informationen. Aber heute ist die Klarheit und Genauigkeit, die Shannons Informationstheorie bietet, bei diesen schwierigen Problemen noch nicht verfügbar.