Κάθε λέξη στην ανάλυση έχει τη δική της βαθμολογία. Συζήτηση επιστημονικών και πολιτιστικών θεμάτων, χρήση Αγγλικών
Η μελέτη υποστηρίχθηκε από επιχορήγηση από το Ρωσικό Ίδρυμα Επιστημών.
Χρησιμοποιήθηκε η μελέτη του Smirnovένα αντιπροσωπευτικό δείγμα δεδομένων από τη μελέτη διαχρονικής ομάδας κοόρτης HSE «Εκπαιδευτικές και Επαγγελματικές Διαδρομές» (TrEC). Η μελέτη παρακολουθεί την εξέλιξη της σταδιοδρομίας 4.400 φοιτητών από 42 περιοχές της Ρωσίας από πανεπιστήμια που συμμετέχουν στο πρόγραμμα PISA (Πρόγραμμα Διεθνούς Αξιολόγησης Φοιτητών). Τα δεδομένα της μελέτης περιελάμβαναν επίσης δεδομένα για τους λογαριασμούς VK των μαθητών (3.483 συμμετέχοντες φοιτητές συμφώνησαν να παράσχουν αυτές τις πληροφορίες).
«Δεδομένου ότι τέτοια δεδομένα, σε συνδυασμό με ψηφιακάΤα ίχνη είναι δύσκολο να ληφθούν, σχεδόν ποτέ δεν χρησιμοποιούνται », εξηγεί ο Smirnov. Εν τω μεταξύ, ένα τέτοιο σύνολο δεδομένων επιτρέπει την ανάπτυξη ενός ισχυρού μοντέλου που μπορεί να εφαρμοστεί σε άλλες παραμέτρους. Και τα αποτελέσματα μπορούν να επεκταθούν σε όλους τους άλλους μαθητές - μαθητές γυμνασίου και γυμνασίου.
Ως δείγμα εκπαίδευσης, χρησιμοποιήσαμεμηνύματα από δημόσιες σελίδες VKontakte - συνολικά 130.575 μηνύματα από 2.468 άτομα που πέρασαν το τεστ PISA το 2012. Το τεστ επέτρεψε στον ερευνητή να αξιολογήσει την ακαδημαϊκή ικανότητα του μαθητή, καθώς και την ικανότητά του να αποδείξει τις γνώσεις του στην πράξη. Η μελέτη περιελάμβανε μόνο δημόσια διαθέσιμα μηνύματα VKontakte από συμφωνημένους συμμετέχοντες.
Κατά τη διάρκεια της μελέτης, πραγματοποιήθηκε μη εποπτευόμενη μηχανική εκμάθηση με διανυσματική αναπαράσταση λέξεων στο VKontakte post-corpus (1,9 δισεκατομμύρια λέξεις συνολικά, με 2,5 εκατομμύρια μοναδικές λέξεις).
«Έχουμε παρουσιάσει κάθε ανάρτηση ως 300 διαστάσεωνδιάνυσμα με μέσο όρο τις διανυσματικές παραστάσεις όλων των συστατικών λέξεων », εξηγεί ο Smirnov. "Αυτές οι αναλυτικές προβολές χρησιμοποιήθηκαν για να εκπαιδεύσουν ένα μοντέλο γραμμικής παλινδρόμησης για να προβλέψουν τις βαθμολογίες των συγγραφέων του PISA."
Με «πρόβλεψη» ο ερευνητήςδεν σημαίνει πρόβλεψη του μέλλοντος, αλλά μια συσχέτιση μεταξύ των υπολογιζόμενων αποτελεσμάτων και των πραγματικών βαθμολογιών που έλαβαν οι μαθητές στις εξετάσεις PISA, καθώς και των αποτελεσμάτων τους Ενιαίας Πολιτικής Εξέτασης (τα οποία είναι δημόσια διαθέσιμα στο Διαδίκτυο σε συγκεντρωτική μορφή—δηλ. μέσος όρος βαθμολογίας στο σχολείο). Στο προκαταρκτικό στάδιο, το μοντέλο έμαθε να προβλέπει δεδομένα PISA. Στο τελικό μοντέλο, οι υπολογισμοί συγκρίθηκαν με τα αποτελέσματα της Ενιαίας Κρατικής Εξέτασης αποφοίτων Λυκείου και υποψηφίων.
Предполагалось, что окончательная модель сможет αναγνωρίστε αξιόπιστα εάν ένας ισχυρός ή αδύναμος μαθητής έγραψε μια συγκεκριμένη ανάρτηση σε ένα κοινωνικό δίκτυο ή, με άλλα λόγια, διαφοροποίησε τα θέματα ανάλογα με την ακαδημαϊκή τους απόδοση. Μετά από μια περίοδο εκπαίδευσης, το μοντέλο μπόρεσε να διακρίνει τα μηνύματα που γράφτηκαν από μαθητές με υψηλές ή χαμηλές βαθμολογίες PISA (επίπεδα 5-6 και επίπεδα 0-1) με ακρίβεια 93,7%. Όσον αφορά τη συγκρισιμότητα των PISA και USE, αν και οι δύο εξετάσεις διαφέρουν, η έρευνα έδειξε ότι η απόδοση των μαθητών σε αυτές τις δύο εξετάσεις συσχετίζεται σε μεγάλο βαθμό μεταξύ τους.
Αποδείχθηκε ότι «η προβλεπόμενη ακαδημαϊκή απόδοση είναι στενήσυνδέεται με τα αποτελέσματα των εξετάσεων, "- λέει ο Σμύρνοφ. «Ο συντελεστής συσχέτισης κυμαίνεται μεταξύ 0,49 και 0,6. Και στην περίπτωση των πανεπιστημίων, όταν συγκρίθηκαν οι προβλεπόμενες ακαδημαϊκές επιδόσεις και οι βαθμολογίες USE (διαθέσιμες πληροφορίες στην τρέχουσα μελέτη, Παρακολούθηση της ποιότητας των εισαγωγών πανεπιστημίων), τα αποτελέσματα έδειξαν επίσης μια ισχυρή σχέση. Ο συντελεστής συσχέτισης είναι 0,83, που είναι σημαντικά υψηλότερος από ό, τι για το γυμνάσιο, επειδή περισσότερα δεδομένα. "
Αποτελέσματα
Ο Smirnov επισήμανε κοινά χαρακτηριστικά κειμένουδημοσιεύσεις σε σχέση με την πρόοδο των συγγραφέων τους. Η χρήση των λέξεων-κλειδιών (-0.08), emoticons (-0.06) και θαυμαστικών (-0.04) βρέθηκε να συσχετίζεται αρνητικά με την ακαδημαϊκή απόδοση. Από την άλλη πλευρά, η χρήση λατινικών χαρακτήρων, το μέσο μήκος του μηνύματος και της λέξης, το μέγεθος του λεξιλογίου και η εντροπία των κειμένων χρήστη συσχετίζονται θετικά με την ακαδημαϊκή απόδοση (από 0,07 έως 0,16, αντίστοιχα).
Έχει επίσης επιβεβαιωθεί ότι οι μαθητές με διαφορετικά επίπεδα επίδοσης έχουν διαφορετικό λεξιλόγιο.
Οι μαθητές υψηλής απόδοσης χρησιμοποίησαν:
- Αγγλικές λέξεις;
- Λέξεις που σχετίζονται με τη λογοτεχνία (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Έννοιες ανάγνωσης (ανάγνωση, δημοσίευση, βιβλίο, τόμος) ·
- Όροι και ονόματα που σχετίζονται με τη φυσική (Σύμπαν, κβαντική, θεωρία, Einstein, Newton, Hawking).
- Λέξεις που σχετίζονται με τις διαδικασίες σκέψης (σκέψη, απομνημόνευση).
Οι μαθητές με χαμηλές βαθμολογίες χρησιμοποίησαν λέξεις μελάθη, ονόματα δημοφιλών ηλεκτρονικών παιχνιδιών, έννοιες που σχετίζονται με στρατιωτική θητεία (στρατός, όρκος κ.λπ.), όροι ωροσκοπίου (Κριός, Τοξότης) και λέξεις που σχετίζονται με την οδήγηση και τα τροχαία ατυχήματα (σύγκρουση, τροχαία, τροχοί, συντονισμός).
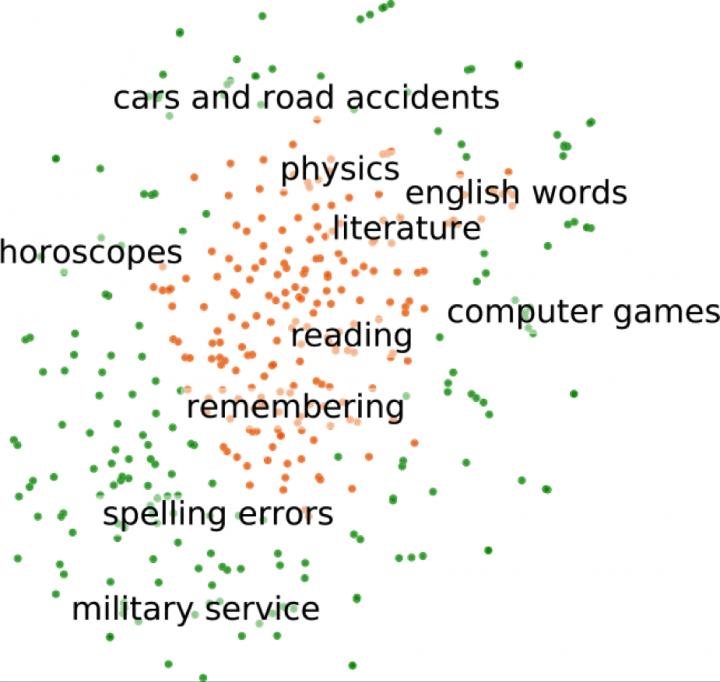 Θεματικές συστάδες: Αναπαριστώντας τις λέξεις με την υψηλότερη και τη χαμηλότερη βαθμολογία από το σύνολο δεδομένων εκπαίδευσης
Ο Smirnov υπολόγισε τους συντελεστές και για τα 2,5 εκατομμύριαλέξεις του διανυσματικού μοντέλου και τις παρείχε για περαιτέρω μελέτη. Είναι ενδιαφέρον ότι ακόμη και λέξεις που είναι σπάνιες στο σύνολο δεδομένων εκπαίδευσης μπορούν να προβλέψουν την ακαδημαϊκή επίδοση. Για παράδειγμα, ακόμα κι αν το όνομα "Newt" (όπως ο χαρακτήρας του Χάρι Πότερ, Newt Scamander) δεν εμφανίζεται ποτέ στα δεδομένα εκπαίδευσης, το μοντέλο μπορεί να εκχωρήσει υψηλότερη βαθμολογία σε μηνύματα που το περιέχουν. Αυτό θα συμβεί εάν το μοντέλο μάθει ότι λέξεις από τη σειρά μυθιστορημάτων χρησιμοποιούνται από μαθητές υψηλών επιδόσεων και μέσω της μάθησης χωρίς επίβλεψη, το μοντέλο κατανοήσει "διαισθητικά" ότι το όνομα "Newt" ανήκει σε αυτήν την κατηγορία.
Διαβάστε επίσης
Η ετήσια αποστολή στην Αρκτική έληξε και τα δεδομένα είναι απογοητευτικά. Τι περιμένει την ανθρωπότητα;
Παρακολουθήστε το νέο Hummer να ξεπερνά τα εμπόδια στο δρόμο, να κινείται σαν καβούρι
Την 3η ημέρα της ασθένειας, οι περισσότεροι ασθενείς με COVID-19 χάνουν την αίσθηση της όσφρησης και συχνά υποφέρουν από ρινική καταρροή