Cada palabra del análisis tiene su propia calificación. Discusión de temas científicos y culturales, uso del inglés.
El estudio fue apoyado por una subvención de la Russian Science Foundation.
El estudio de Smirnov utilizóuna muestra representativa de datos del estudio de panel de cohorte longitudinal de HSE “Trayectorias educativas y profesionales” (TrEC). El estudio rastrea el desarrollo profesional de 4.400 estudiantes de 42 regiones de Rusia de universidades que participan en el programa PISA (Programa para la Evaluación Internacional de Estudiantes). Los datos del estudio también incluyeron datos sobre las cuentas VK de los estudiantes (3.483 estudiantes participantes aceptaron proporcionar esta información).
“Dado que esos datos, combinados conlas huellas son difíciles de obtener, casi nunca se utilizan ”, explica Smirnov. Mientras tanto, este conjunto de datos permite desarrollar un modelo robusto que se puede aplicar a otros parámetros. Y los resultados se pueden extrapolar a todos los demás estudiantes: estudiantes de secundaria y de secundaria.
Como muestra de entrenamiento, usamosMensajes de páginas públicas de VKontakte: un total de 130.575 mensajes de 2.468 personas que aprobaron la prueba PISA en 2012. La prueba permitió al investigador evaluar la capacidad académica del estudiante, así como su capacidad para demostrar sus conocimientos en la práctica. El estudio incluyó solo mensajes VKontakte disponibles públicamente de los participantes acordados.
Durante el estudio, se realizó aprendizaje automático no supervisado con representación vectorial de palabras en el corpus posterior de VKontakte (1,9 mil millones de palabras en total, con 2,5 millones de palabras únicas).
“Hemos presentado cada publicación como unavector al promediar las representaciones vectoriales de todas sus palabras constituyentes ”, explica Smirnov. "Estas vistas de publicaciones se utilizaron para entrenar un modelo de regresión lineal para predecir las calificaciones de los autores de publicaciones de PISA".
Por "predicción" el investigadorno significa predecir el futuro, sino una correlación entre los resultados calculados y las puntuaciones reales obtenidas por los estudiantes en el examen PISA, así como los resultados del Examen Estatal Unificado (que están disponibles públicamente en Internet en forma agregada, es decir, son puntuaciones medias en la escuela). En la etapa preliminar, el modelo aprendió a predecir los datos de PISA. En el modelo final, los cálculos se compararon con los resultados del Examen Estatal Unificado de graduados y solicitantes de secundaria.
Se suponía que el modelo final podíareconocer de manera confiable si un estudiante fuerte o débil escribió un post específico en una red social, o, en otras palabras, diferenciar las materias según su desempeño académico. Después de un período de formación, el modelo fue capaz de distinguir los mensajes escritos por estudiantes con puntuaciones PISA altas o bajas (niveles 5-6 y niveles 0-1) con una precisión del 93,7%. Con respecto a la comparabilidad de PISA y USE, aunque las dos pruebas difieren, la investigación ha demostrado que el desempeño de los estudiantes en las dos pruebas se correlaciona fuertemente entre sí.
Resultó que "el rendimiento académico previsto está estrechamenteconectado con los resultados del examen ", - dice Smirnov. “El coeficiente de correlación está entre 0,49 y 0,6. Y en el caso de las universidades, cuando se compararon el rendimiento académico previsto y los puntajes de USE (información disponible en el estudio actual, Monitoreo de la calidad de las admisiones universitarias), los resultados también mostraron una fuerte relación. El coeficiente de correlación es 0.83, que es significativamente más alto que para la escuela secundaria, porque más datos ".
Resultados
Smirnov destacó las características comunes del textopublicaciones en relación con el progreso de sus autores. Se encontró que el uso de palabras clave (-0,08), emoticonos (-0,06) y exclamaciones (-0,04) se correlaciona negativamente con el rendimiento académico. Por otro lado, el uso de caracteres latinos, la longitud promedio de mensaje y palabra, el tamaño del vocabulario y la entropía de los textos de usuario se correlacionan positivamente con el rendimiento académico (de 0.07 a 0.16, respectivamente).
También se ha confirmado que los estudiantes con diferentes niveles de rendimiento tienen un vocabulario diferente.
Los estudiantes de alto rendimiento utilizaron:
- Palabras inglesas;
- Palabras relacionadas con la literatura (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Lectura de conceptos (leer, publicar, libro, volumen);
- Términos y nombres relacionados con la física (Universo, cuántica, teoría, Einstein, Newton, Hawking);
- Palabras relacionadas con procesos de pensamiento (pensamiento, memorización).
Los estudiantes con puntajes bajos usaron palabras conerrores, nombres de juegos de computadora populares, conceptos relacionados con el servicio militar (ejército, juramento, etc.), términos del horóscopo (Aries, Sagitario) y palabras relacionadas con la conducción y accidentes automovilísticos (colisión, policía de tránsito, ruedas, tuning)
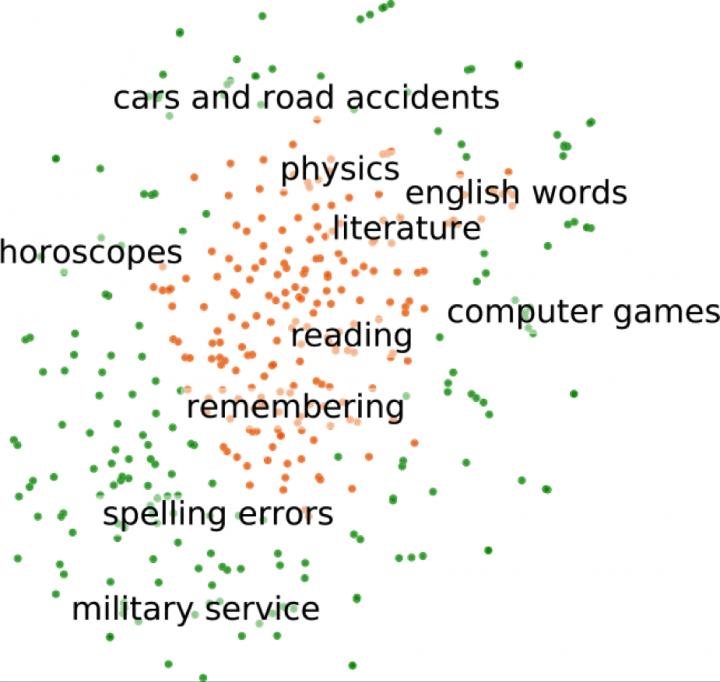 Clústeres temáticos: Representan las palabras de puntuación más alta y más baja del conjunto de datos de entrenamiento
Smirnov calculó los coeficientes para los 2,5 millones.palabras del modelo vectorial y las proporcioné para su posterior estudio. Curiosamente, incluso las palabras que son raras en el conjunto de datos de formación pueden predecir el rendimiento académico. Por ejemplo, incluso si el nombre "Newt" (como el personaje de Harry Potter Newt Scamander) nunca aparece en los datos de entrenamiento, el modelo puede asignar una calificación más alta a los mensajes que lo contienen. Esto sucederá si el modelo aprende que las palabras de una serie de novelas son utilizadas por estudiantes de alto rendimiento y, mediante el aprendizaje no supervisado, el modelo entiende "intuitivamente" que el nombre "Newt" entra en esta categoría.
Leer también
La misión anual en el Ártico ha finalizado y los datos son decepcionantes. ¿Qué le espera a la humanidad?
Observa cómo el nuevo Hummer supera obstáculos en la carretera, moviéndose como un cangrejo
En el día 3 de la enfermedad, la mayoría de los pacientes con COVID-19 pierden el sentido del olfato y a menudo sufren de secreción nasal.