Jokaisella analyysin sanalla on oma arvosanansa. Keskustelua tieteellisistä ja kulttuurisista aiheista, englannin kielen käyttö
Tutkimusta tuki Venäjän tiedesäätiön apuraha.
Smirnovin tutkimus käytettyedustava otos HSE:n pitkittäiskohorttipaneelitutkimuksen "Educational and Career Trajectories" (TrEC) tiedoista. Tutkimuksessa seurataan 4 400 opiskelijan urakehitystä 42 Venäjän alueelta PISA-ohjelmaan (Program for International Student Assessment) osallistuvista yliopistoista. Tutkimusaineistossa oli myös tietoja opiskelijoiden VK-tileistä (3 483 opiskelijaa suostui antamaan nämä tiedot).
”Koska tällainen data yhdistettynä digitaaliseenjälkiä on vaikea saada, niitä ei melkein koskaan käytetä ”, Smirnov selittää. Samaan aikaan tällainen tietojoukko mahdollistaa vankan mallin kehittämisen, jota voidaan soveltaa muihin parametreihin. Ja tulokset voidaan ekstrapoloida kaikille muille opiskelijoille - lukiolaisille ja lukiolaisille.
Harjoittelunäytteenä käytimmeviestit julkisilta "VKontakte" -sivuilta - yhteensä 130 575 viestiä 2468 PISA-testin läpäisseeltä ihmiseltä vuonna 2012. Testin avulla tutkija pystyi arvioimaan opiskelijan akateemista kykyä sekä kykyä osoittaa tietojaan käytännössä. Tutkimus sisälsi vain julkisesti saatavilla olevat VKontakte-viestit sovituilta osallistujilta.
Tutkimuksen aikana VKontakten postkorpuksessa suoritettiin valvomatonta koneoppimista sanojen vektoriesityksen kanssa (yhteensä 1,9 miljardia sanaa, 2,5 miljoonaa yksilöllistä sanaa).
”Olemme esittäneet jokaisen viestin 300-ulotteisenavektori keskittämällä kaikkien sen sisältämien sanojen vektoriesitykset ”, Smirnov selittää. "Näitä postinäkymiä käytettiin lineaarisen regressiomallin kouluttamiseen PISA-kirjoittajien arvioiden ennustamiseksi."
"Ennustamalla" tutkijaei tarkoita tulevaisuuden ennustamista, vaan korrelaatiota laskettujen tulosten ja opiskelijoiden PISA-kokeesta saamien todellisten tulosten sekä Unified State Exam -tulosten välillä (jotka ovat julkisesti saatavilla Internetissä aggregoidussa muodossa – eli nämä ovat keskimääräiset pisteet koulussa). Esivaiheessa malli oppi ennustamaan PISA-tietoja. Lopullisessa mallissa laskelmia verrattiin lukion valmistuneiden ja hakijoiden yhtenäisen valtiontutkinnon tuloksiin.
Lopullisen mallin piti pystyätunnista luotettavasti, kirjoittaako vahva vai heikko opiskelija tietyn viestin sosiaaliseen verkostoon, tai toisin sanoen erottele oppiaineet akateemisen suorituksensa mukaisesti. Koulutusjakson jälkeen malli pystyi erottamaan viestit, jotka kirjoittivat opiskelijat, joilla oli korkea tai matala PISA-pisteet (tasot 5-6 ja 0-1) tarkkuudella 93,7%. PISA: n ja USE: n vertailukelpoisuuden suhteen, vaikka nämä kaksi testiä eroavat toisistaan, tutkimus on osoittanut, että opiskelijoiden suoritukset näissä kahdessa testissä korreloivat voimakkaasti toistensa kanssa.
Kävi ilmi, että "ennustettu akateeminen suorituskyky on tiiviistiliittyy kokeen tuloksiin ”, Smirnov kertoo. ”Korrelaatiokerroin on välillä 0,49–0,6. Ja yliopistojen tapauksessa, kun ennustettua akateemista suorituskykyä ja USE-pisteitä verrattiin (tiedot ovat saatavilla tässä tutkimuksessa, Yliopistoon pääsyn laadun seuranta), tulokset osoittivat myös vahvan suhteen. Korrelaatiokerroin on 0,83, mikä on huomattavasti korkeampi kuin lukiossa, koska lisää tietoja. "
Tulokset
Smirnov korosti yhteisiä tekstiominaisuuksiakirjoittajien edistymistä. Avainsanojen (-0,08), hymiöiden (-0,06) ja huutomerkkien (-0,04) käytön havaittiin korreloivan negatiivisesti akateemisen suorituksen kanssa. Toisaalta latinankielisten merkkien käyttö, viestin ja sanan keskimääräinen pituus, sanastokoko ja käyttäjätekstien entropia korreloivat positiivisesti akateemisen suorituksen kanssa (vastaavasti 0,07 - 0,16).
On myös vahvistettu, että eri saavutustasoilla olevilla oppilailla on erilainen sanavarasto.
Tehokkaat opiskelijat käyttivät:
- Englanninkielisiä sanoja;
- Kirjallisuuden sanat (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Käsitteiden lukeminen (lue, julkaise, kirja, nide);
- Fysiikkaan liittyvät termit ja nimet (maailmankaikkeus, kvantti, teoria, Einstein, Newton, Hawking);
- Ajatusprosesseihin liittyvät sanat (ajattelu, muistaminen).
Pienillä pisteillä opiskelijat käyttivät sanojavirheet, suosittujen tietokonepelien nimet, asepalvelukseen liittyvät käsitteet (armeija, vala jne.), horoskooppitermit (Oinas, Jousimies) ja ajo- ja auto-onnettomuuksiin liittyvät sanat (törmäys, liikennepoliisi, pyörät, viritys).
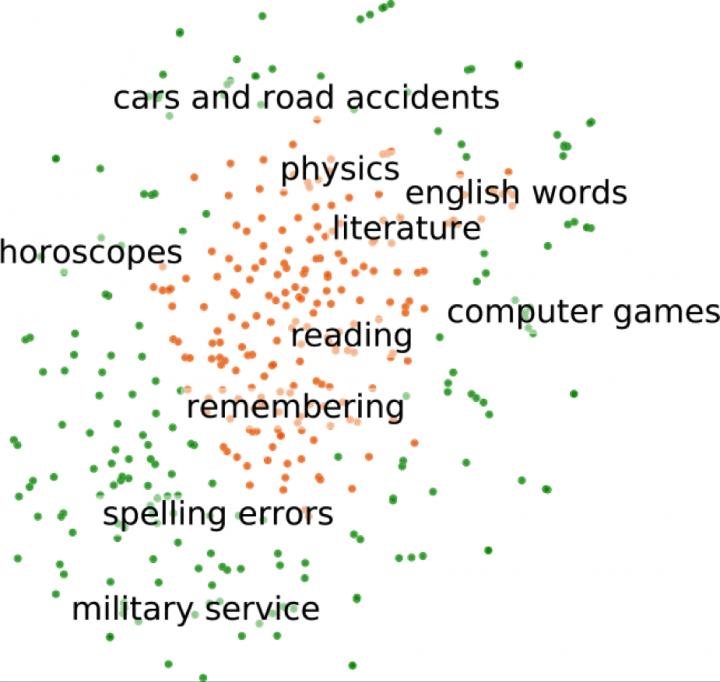 Temaattiset klusterit: Edustavat korkeimpia ja matalimpia pisteitä sanoja koulutuksen tietojoukosta
Smirnov laski kertoimet kaikille 2,5 miljoonallevektorimallin sanoja ja toimitti ne jatkotutkimusta varten. Mielenkiintoista on, että jopa sanat, jotka ovat harvinaisia harjoitustietojoukossa, voivat ennustaa akateemista suorituskykyä. Esimerkiksi vaikka nimeä "Newt" (kuten Harry Potter -hahmossa Newt Scamander) ei koskaan esiinny harjoitustietojoukossa, malli voi antaa korkeamman arvosanan sen sisältäville viesteille. Näin tapahtuu, jos malli oppii, että korkean suorituskyvyn oppilaat käyttävät romaanisarjan sanoja, ja ohjaamattoman oppimisen kautta malli "intuitiivisesti" ymmärtää, että nimi "Newt" kuuluu tähän kategoriaan.
Lue myös
Arktisen alueen vuosittainen tehtävä on päättynyt ja tiedot ovat pettymyksiä. Mikä ihmiskuntaa odottaa?
Katsele uutta Hummeria voittamalla tiellä olevat esteet liikkuen kuin rapu
Sairauspäivänä 3 useimmat COVID-19-potilaat menettävät hajuaistunsa ja kärsivät usein nenästä