Chaque mot de l’analyse a sa propre note.
L'étude a été financée par une subvention de la Russian Science Foundation.
L'étude de Smirnov utiliséeun échantillon représentatif de données de l’étude par panel de cohorte longitudinale HSE « Trajectoires éducatives et professionnelles » (TrEC). L'étude suit l'évolution de carrière de 4 400 étudiants de 42 régions de Russie issus d'universités participant au programme PISA (Program for International Student Assessment). Les données de l'étude comprenaient également des données sur les comptes VK des étudiants (3 483 étudiants participants ont accepté de fournir ces informations).
«Étant donné que ces données, associées au numériqueles traces sont difficiles à obtenir, elles ne sont quasiment jamais utilisées », explique Smirnov. Pendant ce temps, un tel ensemble de données permet de développer un modèle robuste qui peut être appliqué à d'autres paramètres. Et les résultats peuvent être extrapolés à tous les autres élèves - lycéens et lycéens.
Comme échantillon de formation, nous avons utilisémessages des pages publiques «VKontakte» - un total de 130 575 messages de 2 468 personnes ayant réussi le test PISA en 2012. Le test a permis au chercheur d'évaluer la capacité académique de l'étudiant, ainsi que sa capacité à démontrer ses connaissances dans la pratique. L'étude comprenait uniquement des messages VKontakte accessibles au public provenant de participants convenus.
Au cours de l'étude, un apprentissage automatique non supervisé avec représentation vectorielle des mots a été réalisé dans le post-corpus VKontakte (1,9 milliard de mots au total, avec 2,5 millions de mots uniques).
«Nous avons présenté chaque article sous la forme d'unvecteurs en faisant la moyenne des représentations vectorielles de tous ses mots constitutifs », explique Smirnov. "Ces vues de publication ont été utilisées pour former un modèle de régression linéaire pour prédire les notes des auteurs des publications PISA.
Par « prédiction » le chercheurne signifie pas prédire l'avenir, mais une corrélation entre les résultats calculés et les scores réels obtenus par les étudiants à l'examen PISA, ainsi que leurs résultats à l'examen d'État unifié (qui sont accessibles au public sur Internet sous forme agrégée - c'est-à-dire qu'ils sont notes moyennes à l'école). Au stade préliminaire, le modèle a appris à prédire les données PISA. Dans le modèle final, les calculs ont été comparés aux résultats de l'examen d'État unifié des diplômés et candidats du secondaire.
Le modèle final était censé pouvoirreconnaître de manière fiable si un élève fort ou faible a écrit un article spécifique sur un réseau social ou, en d'autres termes, différencier les sujets en fonction de leurs résultats scolaires. Après une période de formation, le modèle a été en mesure de distinguer les messages rédigés par des élèves ayant des scores PISA élevés ou faibles (niveaux 5-6 et niveaux 0-1) avec une précision de 93,7%. En ce qui concerne la comparabilité de PISA et USE, bien que les deux tests diffèrent, la recherche a montré que les performances des élèves à ces deux tests sont fortement corrélées entre elles.
Il s'est avéré que «les performances scolaires prévues sont étroitementlié aux résultats de l'examen », - dit Smirnov. «Le coefficient de corrélation est compris entre 0,49 et 0,6. Et dans le cas des universités, lorsque les performances académiques projetées et les scores USE ont été comparés (informations disponibles dans la présente étude, Suivi de la qualité des admissions universitaires), les résultats ont également montré une forte relation. Le coefficient de corrélation est de 0,83, ce qui est nettement plus élevé que pour le secondaire, car plus de données. "
Résultats
Smirnov a mis en évidence les fonctionnalités de texte communesposts en relation avec les progrès de leurs auteurs. Il a été constaté que l'utilisation de mots-clés (-0,08), d'émoticônes (-0,06) et d'exclamations (-0,04) était en corrélation négative avec le rendement scolaire. En revanche, l'utilisation de caractères latins, la longueur moyenne du message et des mots, la taille du vocabulaire et l'entropie des textes des utilisateurs sont positivement corrélées aux performances académiques (de 0,07 à 0,16, respectivement).
Il a également été confirmé que les étudiants ayant des niveaux de réussite différents ont un vocabulaire différent.
Les élèves très performants ont utilisé:
- Mots anglais;
- Mots liés à la littérature (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Concepts de lecture (lire, publier, livre, volume);
- Termes et noms liés à la physique (Univers, quantique, théorie, Einstein, Newton, Hawking);
- Mots liés aux processus de pensée (réflexion, mémorisation).
Les élèves ayant de faibles scores utilisaient des mots avecerreurs, noms de jeux informatiques populaires, concepts liés au service militaire (armée, serment, etc.), termes d'horoscope (Bélier, Sagittaire) et mots liés à la conduite et aux accidents de voiture (collision, police de la circulation, roues, réglage).
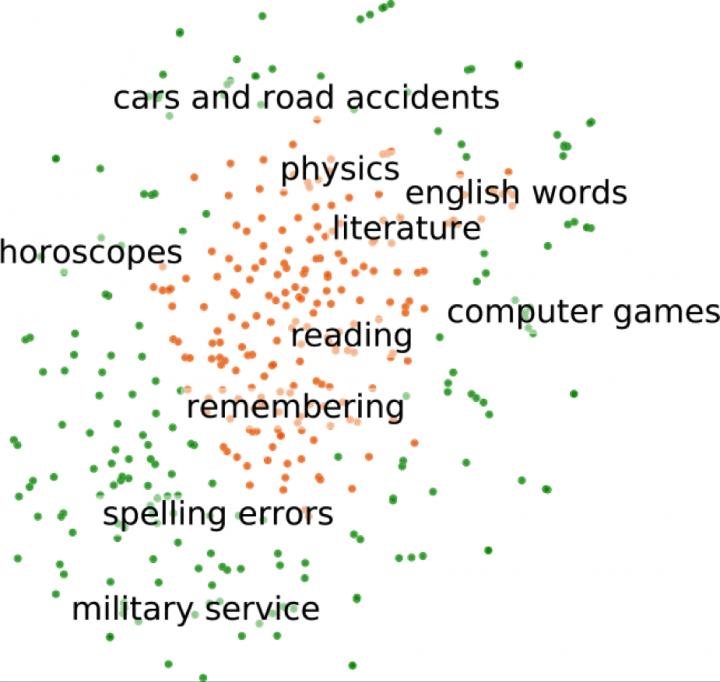 Groupes thématiques: représentant les mots ayant obtenu le score le plus élevé et le moins élevé de l'ensemble de données d'entraînement
Smirnov a calculé les coefficients pour l'ensemble des 2,5 millionsmots du modèle vectoriel et les a fournis pour une étude plus approfondie. Il est intéressant de noter que même les mots rares dans l’ensemble des données de formation peuvent prédire les performances académiques. Par exemple, même si le nom « Newt » (comme le personnage de Harry Potter Newt Scamander) n'apparaît jamais dans les données d'entraînement, le modèle peut attribuer une note plus élevée aux messages qui le contiennent. Cela se produira si le modèle apprend que les mots de la série de romans sont utilisés par des étudiants très performants et que, grâce à un apprentissage non supervisé, le modèle comprend « intuitivement » que le nom « Newt » entre dans cette catégorie.
Lisez aussi
La mission annuelle dans l'Arctique est terminée et les données sont décevantes. Qu'est-ce qui attend l'humanité?
Regardez le nouveau Hummer surmonter les obstacles sur la route, se déplaçant comme un crabe
Au jour 3 de la maladie, la plupart des patients atteints de COVID-19 perdent leur odorat et souffrent souvent d'un nez qui coule