Svaka riječ u analizi ima svoju ocjenu. Rasprava o znanstvenim i kulturnim temama, korištenje engleskog jezika
Studija je podržana bespovratnom pomoći Ruske zaklade za znanost.
Korištena studija Smirnovareprezentativan uzorak podataka iz HSE longitudinalne kohortne panel studije “Educational and Career Trajectories” (TrEC). Studija prati razvoj karijere 4400 studenata iz 42 regije Rusije sa sveučilišta koja sudjeluju u programu PISA (Program za međunarodno ocjenjivanje učenika). Podaci istraživanja također su uključivali podatke o VK računima studenata (3483 studenta su pristala dati ovu informaciju).
„Od takvih podataka, u kombinaciji s digitalnimdo tragova je teško doći, gotovo se nikad ne koriste ”, objašnjava Smirnov. U međuvremenu, takav skup podataka omogućuje razvoj robusnog modela koji se može primijeniti na druge parametre. A rezultati se mogu ekstrapolirati na sve ostale učenike - srednjoškolce i srednjoškolce.
Kao uzorak treninga koristili smoporuke s javnih stranica VKontakte - ukupno 130.575 poruka od 2.468 osoba koje su prošle 2012 PISA test. Test je omogućio istraživaču da procijeni akademsku sposobnost studenta, kao i njegovu sposobnost da pokaže svoje znanje u praksi. Studija je obuhvatila samo javno dostupne poruke VKontaktea od dogovorenih sudionika.
Tijekom studije provedeno je nenadzirano strojno učenje s vektorskim predstavljanjem riječi u post-korpusu VKontakte (ukupno 1,9 milijardi riječi, s 2,5 milijuna jedinstvenih riječi).
“Predstavili smo svaki post kao 300-dimenzionalnivektori usrednjavanjem vektorskih prikaza svih njegovih sastavnih riječi “, objašnjava Smirnov. "Ovi su prikazi korišteni za obuku modela linearne regresije za predviđanje ocjena autora PISA posta."
"Predviđanjem" istraživačne znači predviđanje budućnosti, već korelaciju između izračunatih rezultata i stvarnih rezultata koje su učenici dobili na PISA ispitu, kao i njihovih rezultata Jedinstvenog državnog ispita (koji su javno dostupni na internetu u agregiranom obliku – tj. prosječne ocjene u školi). U preliminarnoj fazi model je naučio predviđati PISA podatke. U konačnom modelu izračuni su uspoređeni s rezultatima Jedinstvenog državnog ispita maturanata i kandidata.
Konačni model trebao je moćipouzdano prepoznati je li jak ili slab student napisao određeni post na društvenoj mreži ili, drugim riječima, razlikuje predmete u skladu s njihovim akademskim uspjehom. Nakon razdoblja treninga, model je mogao razlikovati poruke učenika napisane s visokim ili niskim PISA rezultatima (razine 5-6 i razine 0-1) s točnošću od 93,7%. Što se tiče usporedivosti PISA i USE, iako se dva testa razlikuju, istraživanje je pokazalo da su uspješnost učenika na ova dva testa u velikoj međusobnoj korelaciji.
Pokazalo se da su „predviđeni akademski uspjesi uskopovezano s rezultatima ispita ”, kaže Smirnov. „Koeficijent korelacije je između 0,49 i 0,6. A u slučaju sveučilišta, kada su se uspoređivali predviđeni akademski uspjeh i USE rezultati (podaci dostupni u trenutnoj studiji, Praćenje kvalitete upisa u sveučilišta), rezultati su također pokazali snažnu povezanost. Koeficijent korelacije je 0,83, što je znatno više nego u srednjoj školi, jer više podataka. "
Rezultati
Smirnov je istaknuo uobičajene tekstualne značajkeobjave u odnosu na napredak njihovih autora. Utvrđeno je da uporaba glavnih riječi (-0,08), emotikona (-0,06) i uzvika (-0,04) negativno korelira s akademskim uspjehom. S druge strane, upotreba latiničnih znakova, prosječna duljina poruke i riječi, veličina rječnika i entropija korisničkih tekstova pozitivno su povezani s akademskim uspjehom (od 0,07 do 0,16).
Također je potvrđeno da učenici s različitim razinama postignuća imaju različit vokabular.
Učenici s visokim učinkom koristili su:
- Engleske riječi;
- Književne riječi (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Pojmovi čitanja (čitanje, objavljivanje, knjiga, svezak);
- Pojmovi i nazivi povezani s fizikom (Svemir, kvantum, teorija, Einstein, Newton, Hawking);
- Riječi povezane s misaonim procesima (razmišljanje, pamćenje).
Studenti s niskim ocjenama koristili su riječi spogreške, nazivi popularnih računalnih igara, pojmovi vezani uz vojnu službu (vojska, zakletva itd.), pojmovi horoskopa (Ovan, Strijelac) i riječi povezane s vožnjom i automobilskim nesrećama (sudar, prometna policija, kotači, ugađanje).
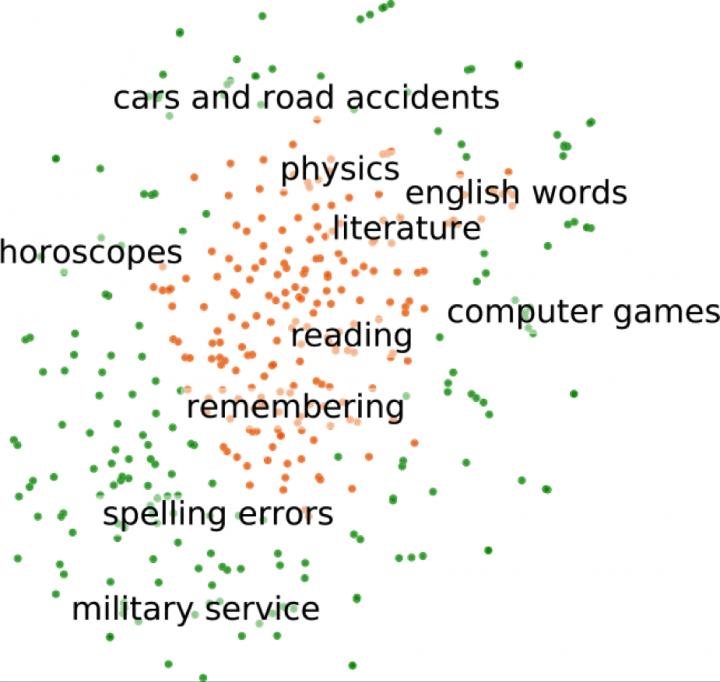 Tematski klasteri: predstavljanje riječi s najvišim i najnižim bodovima iz skupa podataka o treningu
Smirnov je izračunao koeficijente za svih 2,5 milijunariječi vektorskog modela i dali ih za daljnje proučavanje. Zanimljivo je da čak i riječi koje su rijetke u skupu podataka o obuci mogu predvidjeti akademski uspjeh. Na primjer, čak i ako se ime "Newt" (kao u Harry Potter liku Newt Scamander) nikada ne pojavi u skupu podataka za obuku, model može dodijeliti višu ocjenu porukama koje ga sadrže. To će se dogoditi ako model nauči da riječi iz serijala romana koriste učenici s visokim uspjehom, a kroz učenje bez nadzora model "intuitivno" shvati da ime "Newt" spada u ovu kategoriju.
Pročitajte i
Završila je godišnja misija na Arktiku i podaci su razočaravajući. Što čeka čovječanstvo?
Gledajte kako novi Hummer svladava prepreke na cesti, krećući se poput rakova
Na 3. dan bolesti, većina bolesnika s COVID-19 gubi smrad i često pate od curenja iz nosa