Az elemzésben szereplő minden egyes szónak saját besorolása van. Tudományos és kulturális témák megbeszélése, angol nyelvhasználat
A tanulmányt az Orosz Tudományos Alapítvány támogatásával támogatták.
Smirnov tanulmánya használtreprezentatív minta a HSE longitudinális kohorszpanel vizsgálatából, az „Educational and Career Trajectories” (TrEC). A tanulmány Oroszország 42 régiójából 4400 diák karrierfejlesztését követi nyomon, a PISA (Nemzetközi Diákértékelési Program) programban részt vevő egyetemekről. A vizsgálati adatok a hallgatók VK-fiókjaira vonatkozó adatokat is tartalmazták (3483 hallgató vállalta ezt az információt).
„Mivel az ilyen adatok, digitálisan kombinálvaa nyomokat nehéz megszerezni, szinte soha nem használják őket ”- magyarázza Szmirnov. Eközben egy ilyen adatkészlet lehetővé teszi egy robusztus modell kifejlesztését, amely más paraméterekre is alkalmazható. Az eredmények pedig extrapolálhatók az összes többi diákra - középiskolás és középiskolás diákokra.
Képzési mintaként használtuküzenetek a "VKontakte" nyilvános oldalakról - összesen 130 575 üzenet 2448 embertől, akik 2012-ben letették a PISA tesztet. A teszt lehetővé tette a kutató számára, hogy felmérje a hallgató akadémiai képességeit, valamint képességét arra, hogy tudását a gyakorlatban bemutassa. A tanulmány csak nyilvánosan elérhető VKontakte üzeneteket tartalmazott a megbeszélt résztvevőktől.
A vizsgálat során a VKontakte utókorpuszban felügyelet nélküli gépi tanulást végeztek a szavak vektoros ábrázolásával (összesen 1,9 milliárd szó, 2,5 millió egyedi szóval).
„Minden bejegyzést 300 dimenzióként mutattunk bevektort az összes alkotó szó vektorábrázolásának átlagolásával ”- magyarázza Szmirnov. "Ezeket a bejegyzés nézeteket egy lineáris regressziós modell képzésére használták, hogy megjósolják a PISA bejegyzés szerzőinek minősítését."
A "jóslattal" a kutatónem a jövő előrejelzését jelenti, hanem a számított eredmények és a hallgatók által a PISA-vizsgán elért tényleges pontszámok, valamint az egységes államvizsga-eredmények (amelyek összesített formában nyilvánosan elérhetők az interneten – azaz ezek a átlagos pontszámok az iskolában). Az előzetes szakaszban a modell megtanulta előre jelezni a PISA-adatokat. A végső modellben a számításokat az érettségizettek és a jelentkezők Egységes Államvizsga eredményeivel vetették össze.
Állítólag a végleges modell képes volt rámegbízhatóan ismerje fel, hogy egy erős vagy gyenge hallgató adott-e bejegyzést a közösségi hálózaton, vagy más szavakkal megkülönbözteti a tantárgyakat tanulmányi teljesítményüknek megfelelően. Képzési időszak után a modell képes volt megkülönböztetni azokat az üzeneteket, amelyeket olyan hallgatók írtak, akik magas vagy alacsony PISA pontszámot (5-6. Szint és 0-1. Szint) értek el, 93,7% -os pontossággal. A PISA és az USE összehasonlíthatóságát tekintve, bár a két teszt különbözik egymástól, a kutatások kimutatták, hogy a két teszt hallgatói teljesítménye szoros összefüggésben van egymással.
Kiderült, hogy „az előrejelzett tanulmányi teljesítmény szorosan összefüggkapcsolódik a vizsga eredményeihez "- mondja Smirnov. „A korrelációs együttható 0,49 és 0,6 között van. Az egyetemek esetében pedig, amikor összehasonlították az előrejelzett tanulmányi teljesítményt és az USE pontszámokat (a jelenlegi tanulmányban elérhető információk, Az egyetemi felvételi minőségének figyelemmel kísérése), az eredmények szintén szoros kapcsolatot mutattak. A korrelációs együttható 0,83, ami lényegesen magasabb, mint a középiskoláké, mert további adatok. "
Eredmények
Szmirnov kiemelte a közös szöveges jellemzőketbejegyzéseik szerzőik előrehaladásával kapcsolatban. A címszavak (-0,08), a hangulatjelek (-0,06) és a felkiáltások (-0,04) használata negatívan korrelál a tanulmányi teljesítménnyel. Másrészt a latin karakterek használata, az átlagos üzenet- és szóhossz, a szókincs mérete és a felhasználói szövegek entrópiája pozitívan korrelál a tanulmányi teljesítményrel (0,07-től 0,16-ig).
Az is bebizonyosodott, hogy a különböző teljesítményszintű diákok eltérő szókinccsel rendelkeznek.
Nagy teljesítményű hallgatók használták:
- Angol szavak;
- Irodalommal kapcsolatos szavak (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Fogalmak olvasása (olvasás, publikálás, könyv, kötet);
- A fizikával kapcsolatos kifejezések és nevek (Világegyetem, kvantum, elmélet, Einstein, Newton, Hawking);
- A gondolkodási folyamatokkal (gondolkodás, memorizálás) kapcsolatos szavak.
Az alacsony pontszámmal rendelkező diákok szavakat használtakhibák, népszerű számítógépes játékok megnevezései, katonai szolgálattal kapcsolatos fogalmak (hadsereg, eskü stb.), horoszkóp kifejezések (Kos, Nyilas), valamint a vezetéshez és autóbalesetekhez kapcsolódó szavak (ütközés, közlekedési rendőrök, kerekek, tuning).
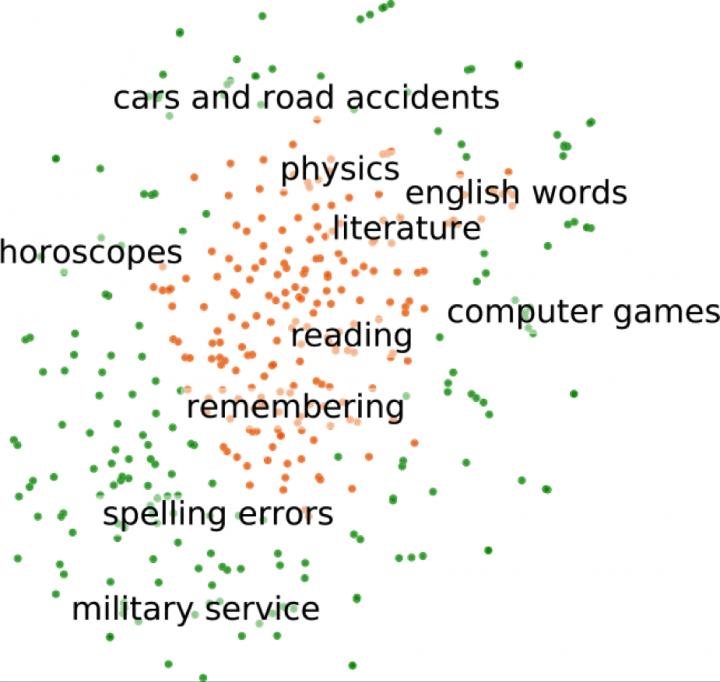 Tematikus klaszterek: A képzési adatkészlet legmagasabb és legalacsonyabb pontszámú szavainak ábrázolása
Szmirnov mind a 2,5 millióra kiszámította az együtthatókata vektormodell szavait, és biztosította őket további tanulmányozáshoz. Érdekes módon még a képzési adathalmazban ritkán előforduló szavak is megjósolhatják a tanulmányi teljesítményt. Például még akkor is, ha a "Newt" név (mint a Harry Potter karakter, Newt Scamander) soha nem jelenik meg a képzési adatokban, a modell magasabb minősítést rendelhet az azt tartalmazó üzenetekhez. Ez akkor fog megtörténni, ha a modell megtudja, hogy a regénysorozat szavait jól teljesítő tanulók használják, és a felügyelet nélküli tanulás révén a modell „intuitív módon” megérti, hogy a „Newt” név ebbe a kategóriába tartozik.
Olvassa el
Az Északi-sarkvidéken folytatott éves misszió befejeződött, és az adatok kiábrándítóak. Mi vár az emberiségre?
Nézze meg, hogy az új Hummer rákszerűen halad-e az úton lévő akadályokon
A betegség 3. napján a legtöbb COVID-19 beteg elveszíti szaglásérzetét, és gyakran orrfolyástól szenved