Ogni parola nell'analisi ha la propria valutazione. Discussione di argomenti scientifici e culturali, uso della lingua inglese
Lo studio è stato sostenuto da una sovvenzione della Russian Science Foundation.
Lo studio di Smirnov utilizzatoun campione rappresentativo di dati provenienti dallo studio di coorte longitudinale HSE “Traiettorie educative e di carriera” (TrEC). Lo studio traccia lo sviluppo della carriera di 4.400 studenti provenienti da 42 regioni della Russia provenienti da università che partecipano al programma PISA (Programma per la valutazione internazionale degli studenti). I dati dello studio includevano anche dati sui conti VK degli studenti (3.483 studenti partecipanti hanno accettato di fornire queste informazioni).
“Poiché tali dati, combinati con il digitalele tracce sono difficili da ottenere, non vengono quasi mai utilizzate ”, spiega Smirnov. Nel frattempo, un tale set di dati consente di sviluppare un modello robusto che può essere applicato ad altri parametri. E i risultati possono essere estrapolati a tutti gli altri studenti: studenti delle scuole superiori e delle scuole superiori.
Come esempio di formazione, abbiamo utilizzatomessaggi da pagine VKontakte pubbliche - per un totale di 130.575 messaggi da 2.468 persone che hanno superato il test PISA nel 2012. Il test ha permesso al ricercatore di valutare le capacità accademiche dello studente, così come la sua capacità di dimostrare le sue conoscenze nella pratica. Lo studio includeva solo messaggi VKontakte pubblicamente disponibili da partecipanti concordati.
Durante lo studio, nel post-corpus di VKontakte è stato eseguito l'apprendimento automatico non supervisionato con rappresentazione vettoriale delle parole (1,9 miliardi di parole in totale, con 2,5 milioni di parole univoche).
“Abbiamo presentato ogni post come un 300-dimensionalevettore calcolando la media delle rappresentazioni vettoriali di tutte le sue parole costituenti ", spiega Smirnov. "Queste visualizzazioni dei post sono state utilizzate per addestrare un modello di regressione lineare per prevedere le valutazioni degli autori dei post PISA".
Per "previsione" il ricercatorenon significa predire il futuro, ma una correlazione tra i risultati calcolati e i punteggi effettivi ottenuti dagli studenti all'esame PISA, nonché i risultati dell'Esame di Stato Unificato (che sono pubblicamente disponibili su Internet in forma aggregata, ovvero sono punteggi medi a scuola). Nella fase preliminare, il modello ha imparato a prevedere i dati PISA. Nel modello finale, i calcoli sono stati confrontati con i risultati dell'Esame di Stato Unificato dei diplomati e dei candidati.
Il modello finale avrebbe dovuto essere in grado di farloriconoscere in modo affidabile se uno studente forte o debole ha scritto un post specifico su un social network o, in altre parole, differenziare le materie in base al rendimento scolastico. Dopo un periodo di formazione, il modello è stato in grado di distinguere tra messaggi scritti da studenti che hanno ottenuto punteggi PISA alti o bassi (livelli 5-6 e livelli 0-1) con una precisione del 93,7%. Per quanto riguarda la comparabilità di PISA e USE, sebbene i due test differiscano, la ricerca ha dimostrato che le prestazioni degli studenti in questi due test sono altamente correlate tra loro.
Si è scoperto che “il rendimento scolastico previsto è molto vicinocollegato ai risultati dell'esame ", afferma Smirnov. “Il coefficiente di correlazione è compreso tra 0,49 e 0,6. E nel caso delle università, quando sono stati confrontati il rendimento accademico previsto e i punteggi USE (informazioni disponibili nello studio corrente, Monitoraggio della qualità delle ammissioni all'università), i risultati hanno mostrato anche una forte relazione. Il coefficiente di correlazione è 0,83, che è significativamente più alto rispetto al liceo, perché più dati. "
Risultati
Smirnov ha evidenziato caratteristiche di testo comunipost in relazione ai progressi dei loro autori. È stato riscontrato che l'uso di lemmi (-0,08), emoticon (-0,06) ed esclamazioni (-0,04) è correlato negativamente con il rendimento scolastico. D'altra parte, l'uso di caratteri latini, la lunghezza media del messaggio e della parola, la dimensione del vocabolario e l'entropia dei testi degli utenti sono positivamente correlati con il rendimento scolastico (da 0,07 a 0,16, rispettivamente).
stato inoltre confermato che gli studenti con livelli di rendimento diversi hanno un vocabolario diverso.
Studenti ad alto rendimento utilizzati:
- Parole inglesi;
- Parole legate alla letteratura (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Concetti di lettura (leggere, pubblicare, libro, volume);
- Termini e nomi relativi alla fisica (Universo, quantum, theory, Einstein, Newton, Hawking);
- Parole relative ai processi di pensiero (pensiero, memorizzazione).
Gli studenti con punteggi bassi usavano parole conerrori, nomi di popolari giochi per computer, concetti relativi al servizio militare (esercito, giuramento, ecc.), termini dell'oroscopo (Ariete, Sagittario) e parole relative alla guida e agli incidenti automobilistici (collisione, polizia stradale, ruote, tuning).
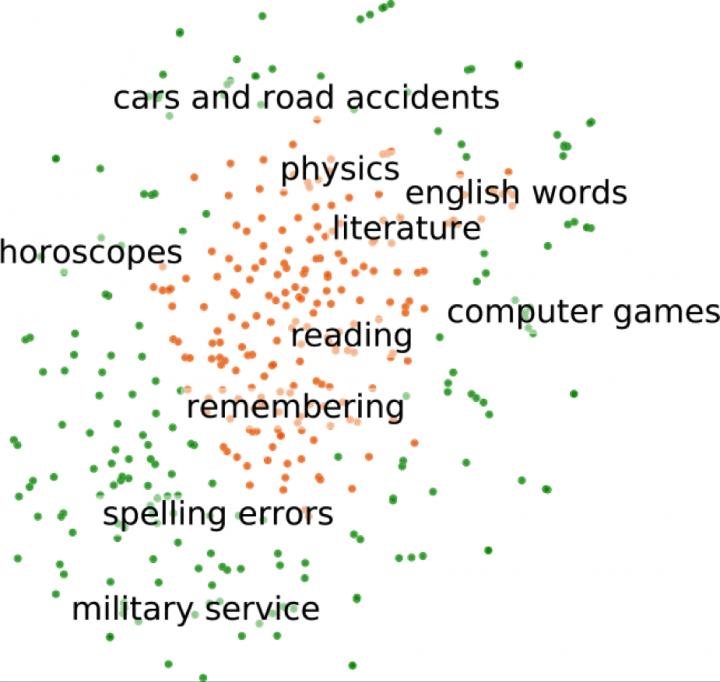 Cluster tematici: rappresentano le parole con il punteggio più alto e più basso dal set di dati di addestramento
Smirnov ha calcolato i coefficienti per tutti i 2,5 milioniparole del modello vettoriale e le ho fornite per ulteriori studi. È interessante notare che anche le parole rare nell’insieme dei dati di formazione possono predire il rendimento scolastico. Ad esempio, anche se il nome "Newt" (come nel personaggio di Harry Potter Newt Scamandro) non appare mai nel set di dati di addestramento, il modello può assegnare una valutazione più alta ai messaggi che lo contengono. Ciò accadrà se il modello apprende che le parole della serie di romanzi sono usate da studenti con ottimi risultati e, attraverso l'apprendimento non supervisionato, il modello capisce "intuitivamente" che il nome "Newt" rientra in questa categoria.
Leggi anche
La missione annuale nell'Artico è terminata ei dati sono deludenti. Cosa attende l'umanità?
Guarda il nuovo Hummer superare gli ostacoli sulla strada, muovendosi come un granchio
Al terzo giorno di malattia, la maggior parte dei pazienti COVID-19 perde il senso dell'olfatto e spesso soffre di naso che cola