データ主導の世界では、安価、迅速、効率的に保管できるセンターの構築
DNA保存システムサイエンスフィクションのように聞こえます。しかし、そのような解決策はすでに実装されています。確かに、これまでのところ主に研究目的と、頻繁に使用する必要のないアーカイブ データの保存に使用されています。 DNA を扱う際の主な制限は、多数のファイルへの高速並列アクセスと読み取りおよび書き込みエラーが難しいことです。
国際的な研究者チームが開発した既存の欠点を解消する技術。 Nature 誌に掲載されたこの研究の著者の 1 人は、提案されたソリューションを使用すれば 5 ~ 10 年以内に DNA に基づく本格的なデータセンターが現実になると確信しています。
データストレージシステムとしての DNA
DNA鎖を使用してデータを保存するというアイデア何十年も議論されてきました。 1988 年に遡ると、ハーバード大学の研究者でアーティストのジョー デイビスは、古代ゲルマンのルーン文字の 5 × 7 ピクセルの画像 (合計 35 ビットの情報) を大腸菌に含まれる DNA にエンコードしました。しかし、この例は将来の可能性を示すものにすぎませんでした。テクノロジーは高価で複雑すぎました。
技術的にはDNAにデータを保存することが可能になりましたが、2011 年にハーバード大学の研究者が制御された DNA 合成技術を開発したとき。この分野でのさらなる研究により、コストが大幅に削減され、目的の DNA 配列を含む合成 DNA の作成速度が向上しました。
通常の0ではなくDNAに情報を保存するにはデータのエンコードに使用される 1 と 1 では、「アデニン - チミン」および「シトシン - グアニン」の塩基対を使用できます。研究室では、塩基が特定の順序で結合されて DNA の合成鎖が形成されます。
DNA の利点
DNA にデータを保存すると、多くの利点があります。たとえば、DNA ファイルはそれほどスペースを必要としません。分子の密度が高いため、各ヌクレオチドは 2 ビットに相当し、約 1 nm3 です。また、DNA として保存されるエクサバイトのデータ (1,000,000 TB) は手のひらに収まります。 DNA も非常に安定しています。古代の微生物や動物の化石からの保存された遺伝暗号の発見は、その代表的な例です。さらに、このテクノロジーは多大なエネルギーコストを必要としません。
問題は、質問がある場合、既存のソリューションはデータの書き込みには十分に機能するため (依然として比較的高価ですが)、読み取りに関して問題が発生し始めます。現在読み取りに使用されている PCR ランダム アクセス方式は、多数のエラーが発生する傾向があります。システムは一度に 1 つのファイルしか読み取ることができず、データの品質は読み取りのたびに大幅に低下します。
読み取りプロセスは次のように動作します。DNA 内の各データ ファイルには、特定のプライマーに結合する配列が含まれています。研究者は、ポリメラーゼ連鎖反応 (PCR) を使用して、目的のフラグメントの数百万コピーを合成するプロセスを開始します。
同じ原理が機能します。たとえば、コロナウイルスの検査: 特定の合成プライマーの影響下で連鎖反応が始まり、少量のウイルス DNA でも検出可能になります。問題は、複数の別々のファイルを読み取るには複数のプライマーを同時に機能させる必要があり、これによりコピープロセスで多くのエラーが発生し、元の DNA が破壊されることです。
スケーラブルなテクノロジー
国際研究者チームが提案これらの制限を克服できると彼らが信じている方法は、熱固定 PCR です。科学者たちは、DNA の別個のファイルとして機能するタンパク質とポリマーのマイクロカプセルを作成しました。このような各カプセルは 1 つのデータ ファイルに関連付けられます。さらに、複数のマイクロカプセルを 50 °C 以上の温度に加熱すると、各カプセルが密封されるように設計されています。
これにより、PCR プロセスで次の情報を読み取ることができます。各カプセルで独立して発生するため、エラーの余地はほとんどありません。温度が正常化すると、元のファイルはカプセルに接続されたままになり、コピーされたファイルはカプセルから離れます。これにより、元のデータと DNA が破損するのを防ぎます。
遺伝学者は新しいアプローチを使用して、スプリット DNA に保存されている 25 個のファイルを同時に読み取ります。結果は肯定的かつ予想外でした。平均して、サーマル カプセルの場合、3 回の読み取り後の読み取り損失は 0.3% ですが、現在の方法では 35% です。
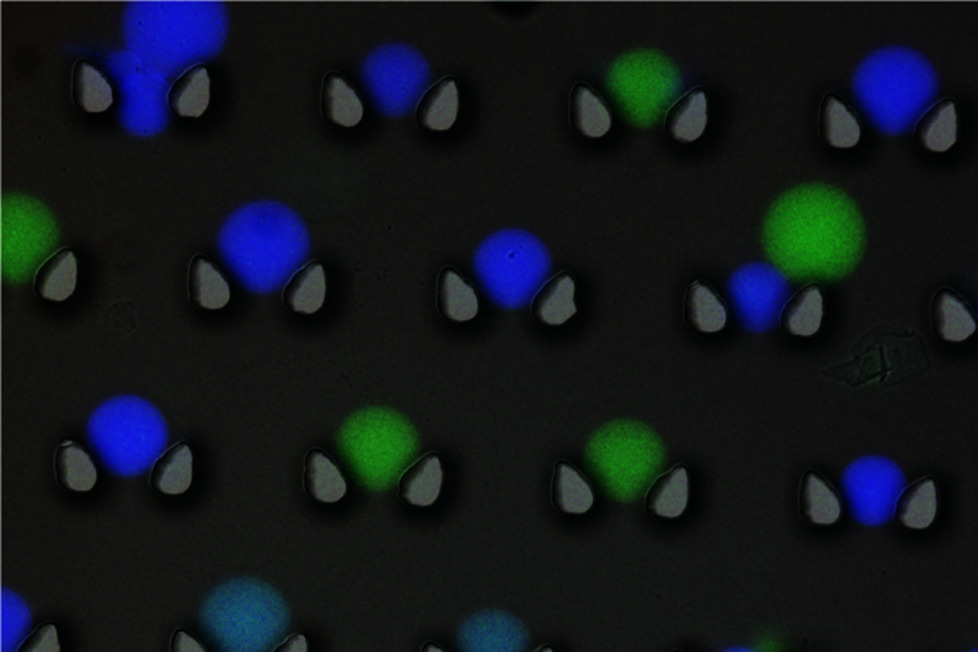 蛍光標識で染色されたマイクロカプセル。画像: トム・デ・グリーフ
2つ目の「イノベーション」 - 特殊塗装タグ付きカタログ。各ファイルには蛍光ラベルが割り当てられ、各カプセルには異なる色が割り当てられます。特別なデバイスが色を認識し、色を互いに分離できるため、大規模なリポジトリ内の情報の並べ替えや検索が容易になります。
このテクノロジーの作者は、これらのイノベーションが実現できると確信しています。本格的な DNA ベースのデータセンターを構築するには十分です。 「建物の一部では、新しいファイルが DNA 合成を使用してエンコードされます。もう 1 つは、カプセルの大きなフィールドを含み、それぞれに個別のファイルが含まれます。ロボットアームがカプセルを取り出し、中身を読んで元に戻します」と研究著者の一人は述べています。重要なのは、DNA合成のコストがさらに削減されるまで待つこと、そしてこの10年間で十分である、と科学者たちは確信している。
続きを読む:
人工知能がナスカの地上絵を4つ発見 - 砂漠に巨大な絵が描かれている
宇宙に「塊」が存在しないことは暗黒物質の超軽量粒子によって説明される
約10億年、地球上の1日は19時間だった:研究者がその理由を説明
表紙: Freepik による画像