分析内の各単語には独自の評価があります。科学的および文化的トピックについてのディスカッション、英語の使用
この研究は、ロシア科学財団からの助成金によって支援されました。
スミルノフの研究で使用されたHSE縦断コホートパネル研究「教育とキャリアの軌跡」(TrEC)からのデータの代表的なサンプル。この研究は、ロシアの42地域からPISA(留学生評価プログラム)プログラムに参加している大学に所属する4,400人の学生のキャリア形成を追跡している。研究データには、学生の VK アカウントに関するデータも含まれていました (3,483 人の学生参加者がこの情報を提供することに同意しました)。
「そのようなデータは、デジタルと組み合わせてトレースを取得するのは困難で、ほとんど使用されません」とSmirnov氏は説明します。一方、このようなデータセットを使用すると、他のパラメータに適用できる堅牢なモデルを開発できます。そして、結果は他のすべての学生、つまり高校生と高校生に外挿することができます。
トレーニングサンプルとして、VKontakteの公開ページからのメッセージ-2012年にPISAテストに合格した2,468人からの合計130,575件のメッセージ。このテストにより、研究者は学生の学力と、実際に彼の知識を示す能力を評価することができました。この調査には、合意された参加者からの公開されているVKontakteメッセージのみが含まれていました。
研究中、単語のベクトル表現による教師なし機械学習が VKontakte ポストコーパス (合計 19 億単語、250 万の一意の単語) で実行されました。
「各投稿を300次元で表示しましたすべての構成単語のベクトル表現を平均することによってベクトルを作成します」とSmirnov氏は説明します。 「これらの投稿ビューは、線形回帰モデルをトレーニングして、PISA投稿者の評価を予測するために使用されました。」
研究者による「予測」によりこれは、将来を予測することを意味するのではなく、計算結果と、PISA 試験で学生が取得した実際のスコア、および統一州試験の結果 (集計形式でインターネット上で公開されています) との相関関係を意味します。学校の平均点)。準備段階で、モデルは PISA データを予測する方法を学習しました。最終モデルでは、計算が高校卒業生と志願者の統一国家試験の結果と比較されました。
最終的なモデルはできるはずだった強い学生と弱い学生がソーシャルネットワークに特定の投稿を書いたかどうかを確実に認識します。つまり、学業成績に応じて科目を区別します。一定期間のトレーニングの後、モデルは、PISAスコアが高いまたは低い(レベル5〜6およびレベル0〜1)学生によって書かれたメッセージを93.7%の精度で区別することができました。 PISAとUSEの比較可能性に関しては、2つのテストは異なりますが、調査によると、これら2つのテストでの学生のパフォーマンスは互いに高度に相関していることがわかっています。
「予測される学業成績は密接に試験の結果に関連している」とスミルノフは言う。 「相関係数は0.49から0.6の間です。また、大学の場合、予測された学業成績とUSE申請者のスコアを比較すると(現在の研究で入手可能な情報、大学入学の質の監視)、結果も強い関係を示しました。相関係数は0.83で、高校よりもかなり高いです。より多くのデータ。」
結果
スミルノフは一般的なテキスト機能を強調しました著者の進捗状況に関連する投稿。見出し語(-0.08)、絵文字(-0.06)、および感嘆符(-0.04)の使用は、学業成績と負の相関関係があることがわかりました。一方、ラテン文字の使用、平均メッセージと単語の長さ、語彙のサイズ、およびユーザーテキストのエントロピーは、学業成績と正の相関があります(それぞれ0.07から0.16)。
また、学習到達度が異なると、語彙力も異なることが確認されています。
使用した高性能の学生:
- 英単語;
- 文学に関連する言葉(ブラッドベリー、ファーレンハイト、オーウェル、ハクスリー、フォークナー、ナボコフ、ブロドスキー、カムス、マン);
- 読書の概念(読む、出版する、本、巻);
- 物理学に関連する用語と名前(宇宙、量子、理論、アインシュタイン、ニュートン、ホーキング);
- 思考過程(思考、暗記)に関連する言葉。
スコアの低い学生は、間違い、人気のあるコンピューターゲームの名前、軍事サービスに関連する概念(軍隊、誓約など)、ホロスコープの用語(Aries、Sagittarius)、運転や自動車の事故に関連する言葉(衝突、交通警察、車輪、チューニング)。
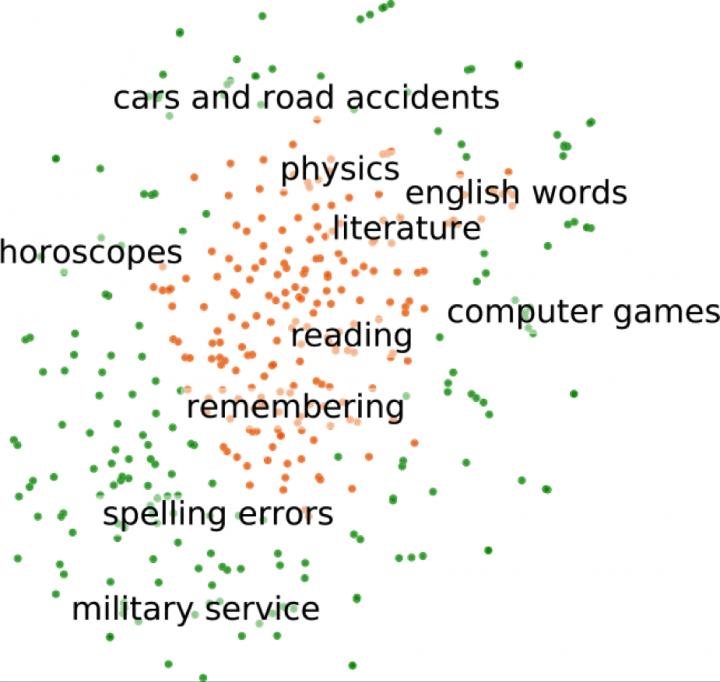 テーマ別クラスター:トレーニングデータセットからの最高スコアと最低スコアの単語を表す
スミルノフは 250 万個すべての係数を計算しましたベクトルモデルの単語を抽出し、さらなる研究のために提供しました。興味深いことに、トレーニング データセットではまれな単語であっても、学業成績を予測できる可能性があります。たとえば、「ニュート」という名前 (ハリー ポッターのキャラクター、ニュート スキャマンダーのように) がトレーニング データ セットにまったく表示されない場合でも、モデルはその名前を含むメッセージに高い評価を割り当てることができます。これは、モデルが小説シリーズの単語が成績優秀な生徒によって使用されていることを学習し、教師なし学習を通じて「ニュート」という名前がこのカテゴリに分類されることを「直観的に」理解した場合に起こります。
また読む
北極圏での毎年恒例の任務は終了し、データは期待外れです。人類を待っているのは何ですか?
新しいハマーがカニのように動き、道路上の障害物を克服するのを見てください
病気の3日目、ほとんどのCOVID-19患者は嗅覚を失い、そしてしばしば鼻水に苦しむ