분석의 각 단어에는 자체 등급이 있습니다. 과학 및 문화 주제에 대한 토론, 영어 사용
이 연구는 러시아 과학 재단의 보조금으로 지원되었습니다.
Smirnov의 연구가 사용되었습니다.HSE 종단적 코호트 패널 연구 "교육 및 직업 궤적"(TrEC)의 대표적인 데이터 샘플입니다. 이 연구는 PISA(국제 학생 평가 프로그램) 프로그램에 참여하는 대학의 러시아 42개 지역 학생 4,400명의 경력 개발을 추적합니다. 연구 데이터에는 학생들의 VK 계정에 대한 데이터도 포함되어 있습니다(3,483명의 학생 참가자가 이 정보 제공에 동의했습니다).
“이러한 데이터와 디지털흔적은 얻기 어렵고 거의 사용되지 않습니다.”라고 Smirnov는 설명합니다. 한편, 이러한 데이터 세트를 사용하면 다른 매개 변수에 적용 할 수있는 강력한 모델을 개발할 수 있습니다. 그리고 그 결과는 다른 모든 고등학생과 고등학생에게 추정 할 수 있습니다.
훈련 샘플로 우리는공개 페이지 "VKontakte"의 메시지-2012 년 PISA 테스트를 통과 한 2,468 명의 사용자가 보낸 총 130,575 개의 메시지. 이 시험을 통해 연구원은 학생의 학업 능력과 실제 지식을 입증 할 수있는 능력을 평가할 수있었습니다. 이 연구에는 합의 된 참가자로부터 공개적으로 사용 가능한 VKontakte 메시지 만 포함되었습니다.
연구 중에 단어의 벡터 표현을 사용한 비지도 기계 학습이 VKontakte 사후 코퍼스(총 19억 단어, 250만 개의 고유 단어)에서 수행되었습니다.
“우리는 각 게시물을 300 차원의벡터를 구성하는 모든 단어의 벡터 표현을 평균화하여 벡터라고 Smirnov는 설명합니다. "이러한 포스트 뷰는 PISA 포스트 작성자의 등급을 예측하기 위해 선형 회귀 모델을 훈련하는 데 사용되었습니다."
연구원은 "예측"을 통해은 미래를 예측하는 것을 의미하는 것이 아니라 계산된 결과와 학생이 PISA 시험에서 얻은 실제 점수 및 통합 상태 시험 결과(집합 형식으로 인터넷에 공개적으로 제공됨) 간의 상관 관계입니다. 평균 점수 학교에서). 예비 단계에서 모델은 PISA 데이터를 예측하는 방법을 학습했습니다. 최종 모델에서는 계산 결과를 고등학교 졸업생 및 지원자의 통합 국가 시험 결과와 비교했습니다.
최종 모델은강하거나 약한 학생이 소셜 네트워크에 특정 게시물을 올렸는지 확실하게 인식하거나, 즉 학업 성과에 따라 과목을 구분합니다. 일정 기간 훈련 후이 모델은 PISA 점수가 높거나 낮은 (레벨 5-6 및 레벨 0-1) 학생이 작성한 메시지를 93.7 %의 정확도로 구분할 수있었습니다. PISA와 USE의 비교 가능성과 관련하여 두 테스트가 다르지만 연구 결과에 따르면이 두 테스트에 대한 학생의 성과는 서로 높은 상관 관계가 있습니다.
“예상 학업 성적은시험 결과와 관련이 있습니다. "라고 Smirnov는 말합니다. “상관 계수는 0.49에서 0.6 사이입니다. 그리고 대학의 경우 예상 학업 성적과 USE 점수를 비교했을 때 (현재 연구에서 사용 가능한 정보, 대학 입학의 질 모니터링) 결과도 강한 관계를 보여주었습니다. 상관 계수는 0.83으로 고등학교보다 유의하게 높습니다. 더 많은 데이터. "
결과
Smirnov는 일반적인 텍스트 기능을 강조했습니다.저자의 진행 상황과 관련된 게시물. 표제어 (-0.08), 이모티콘 (-0.06), 느낌표 (-0.04)의 사용은 학업 성과와 부정적 상관 관계가있는 것으로 나타났습니다. 반면 라틴 문자 사용, 평균 메시지 및 단어 길이, 어휘 크기 및 사용자 텍스트의 엔트로피는 학업 성과 (각각 0.07에서 0.16까지)와 양의 상관 관계가 있습니다.
성취 수준이 다른 학생들은 어휘도 다른 것으로 확인되었습니다.
고성과 학생들은 다음을 사용했습니다.
- 영어 단어;
- 문학 단어 (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- 읽기 개념 (읽기, 출판, 책, 권)
- 물리학과 관련된 용어 및 이름 (우주, 양자, 이론, Einstein, Newton, Hawking);
- 사고 과정과 관련된 단어 (사고, 암기).
점수가 낮은 학생들은실수, 인기있는 컴퓨터 게임의 이름, 군 복무 관련 개념 (육군, 선서 등), 운세 용어 (양자리, 궁수 자리) 및 운전 및 교통 사고 관련 단어 (충돌, 교통 경찰, 바퀴, 튜닝).
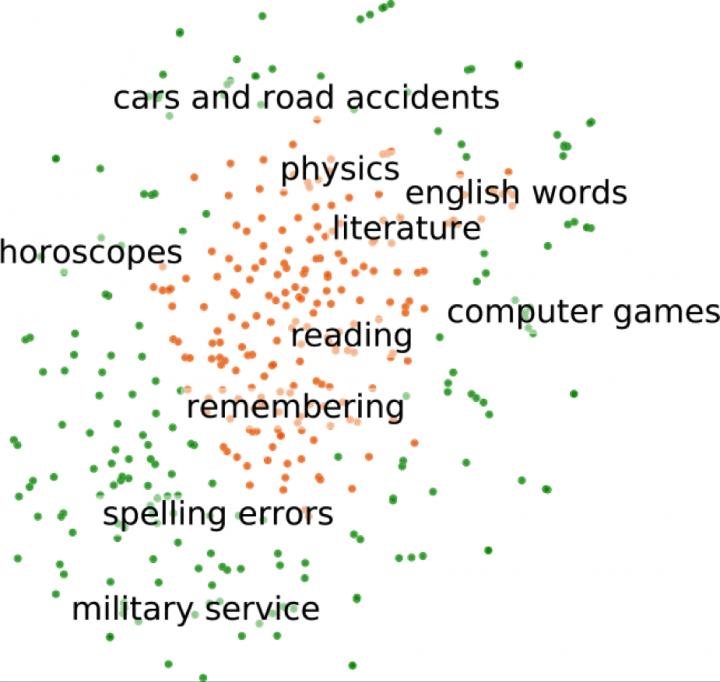 주제별 클러스터 : 학습 데이터 세트에서 가장 높은 점수와 가장 낮은 점수를받은 단어를 나타냅니다.
Smirnov는 250만 개 모두에 대한 계수를 계산했습니다.벡터 모델의 단어를 추가 연구를 위해 제공했습니다. 흥미롭게도 훈련 데이터 세트에서 보기 드문 단어라도 학업 성취도를 예측할 수 있습니다. 예를 들어, "Newt"라는 이름(해리 포터 캐릭터 Newt Scamander에서처럼)이 훈련 데이터 세트에 전혀 나타나지 않더라도 모델은 이를 포함하는 메시지에 더 높은 등급을 할당할 수 있습니다. 이는 모델이 성취도가 높은 학생들이 소설 시리즈의 단어를 사용한다는 것을 학습하고 비지도 학습을 통해 모델이 "Newt"라는 이름이 이 범주에 속한다는 것을 "직관적으로" 이해하는 경우 발생합니다.
읽어보기
북극에서의 연간 임무가 종료되었고 데이터는 실망 스럽습니다. 무엇이 인류를 기다리고 있습니까?
새로운 Hummer가 도로의 장애물을 극복하고 게처럼 움직이는 모습을 지켜보세요.
질병의 3 일차에, 대부분의 COVID-19 환자는 후각을 잃고 종종 콧물로 고통받습니다.