생성적 적대 신경망과 그 단점
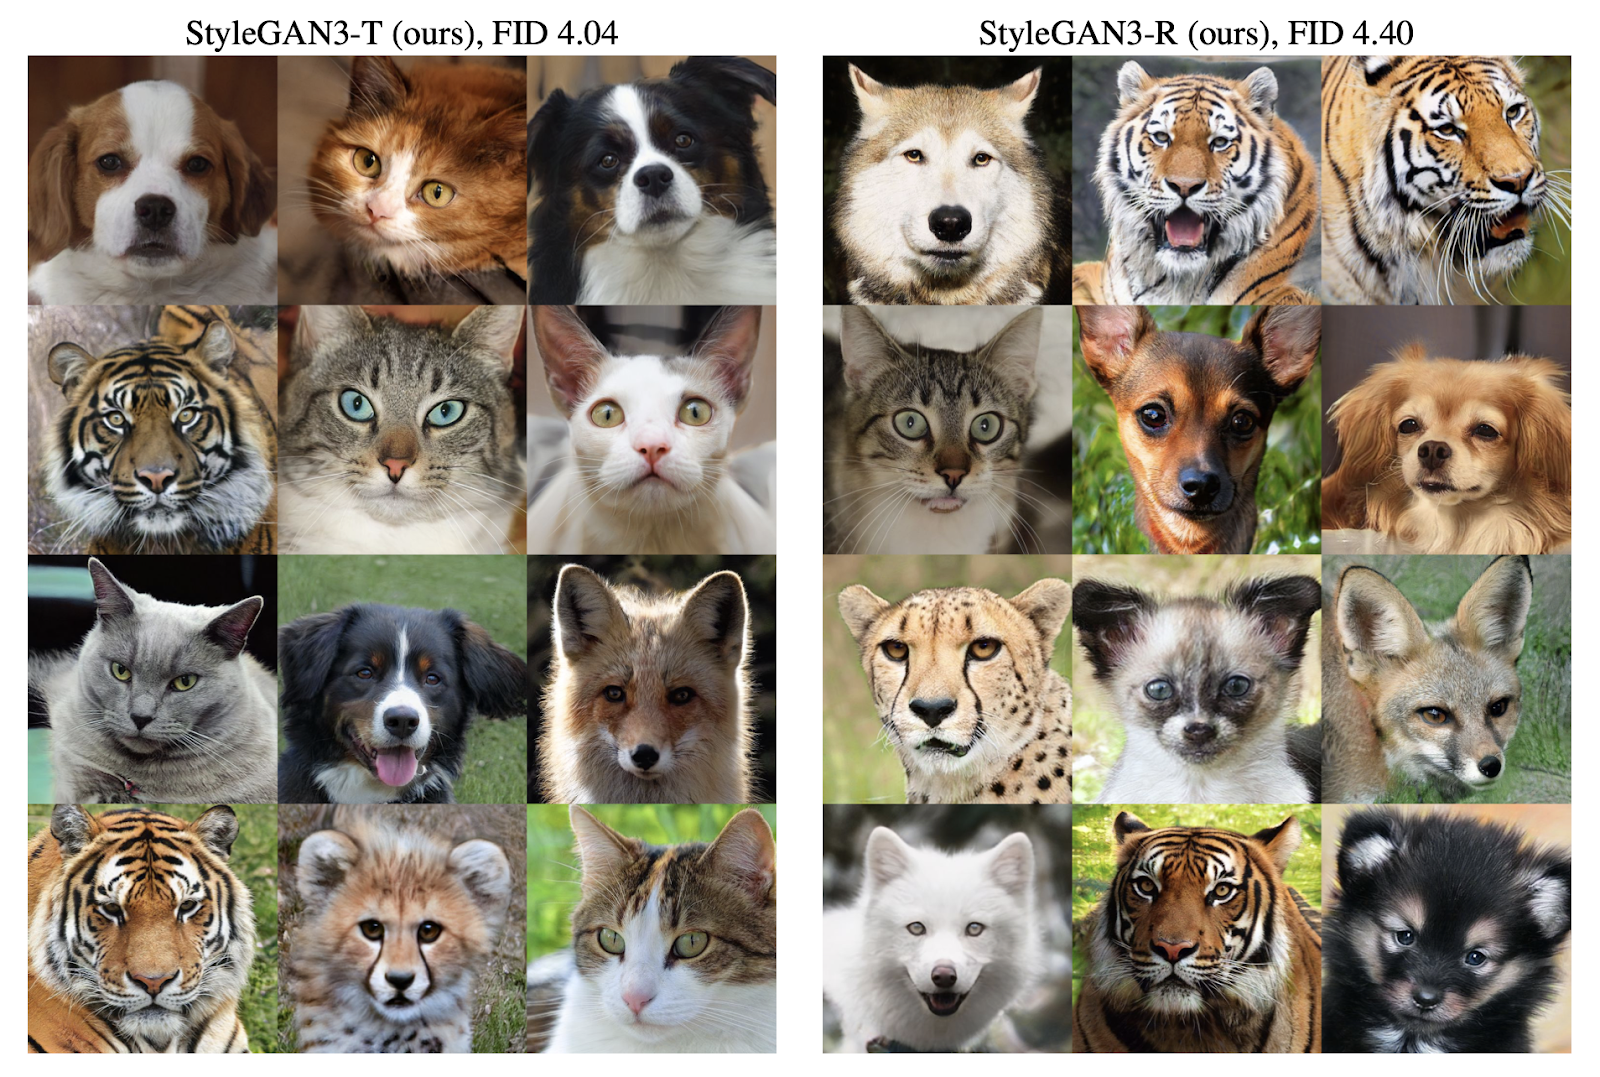
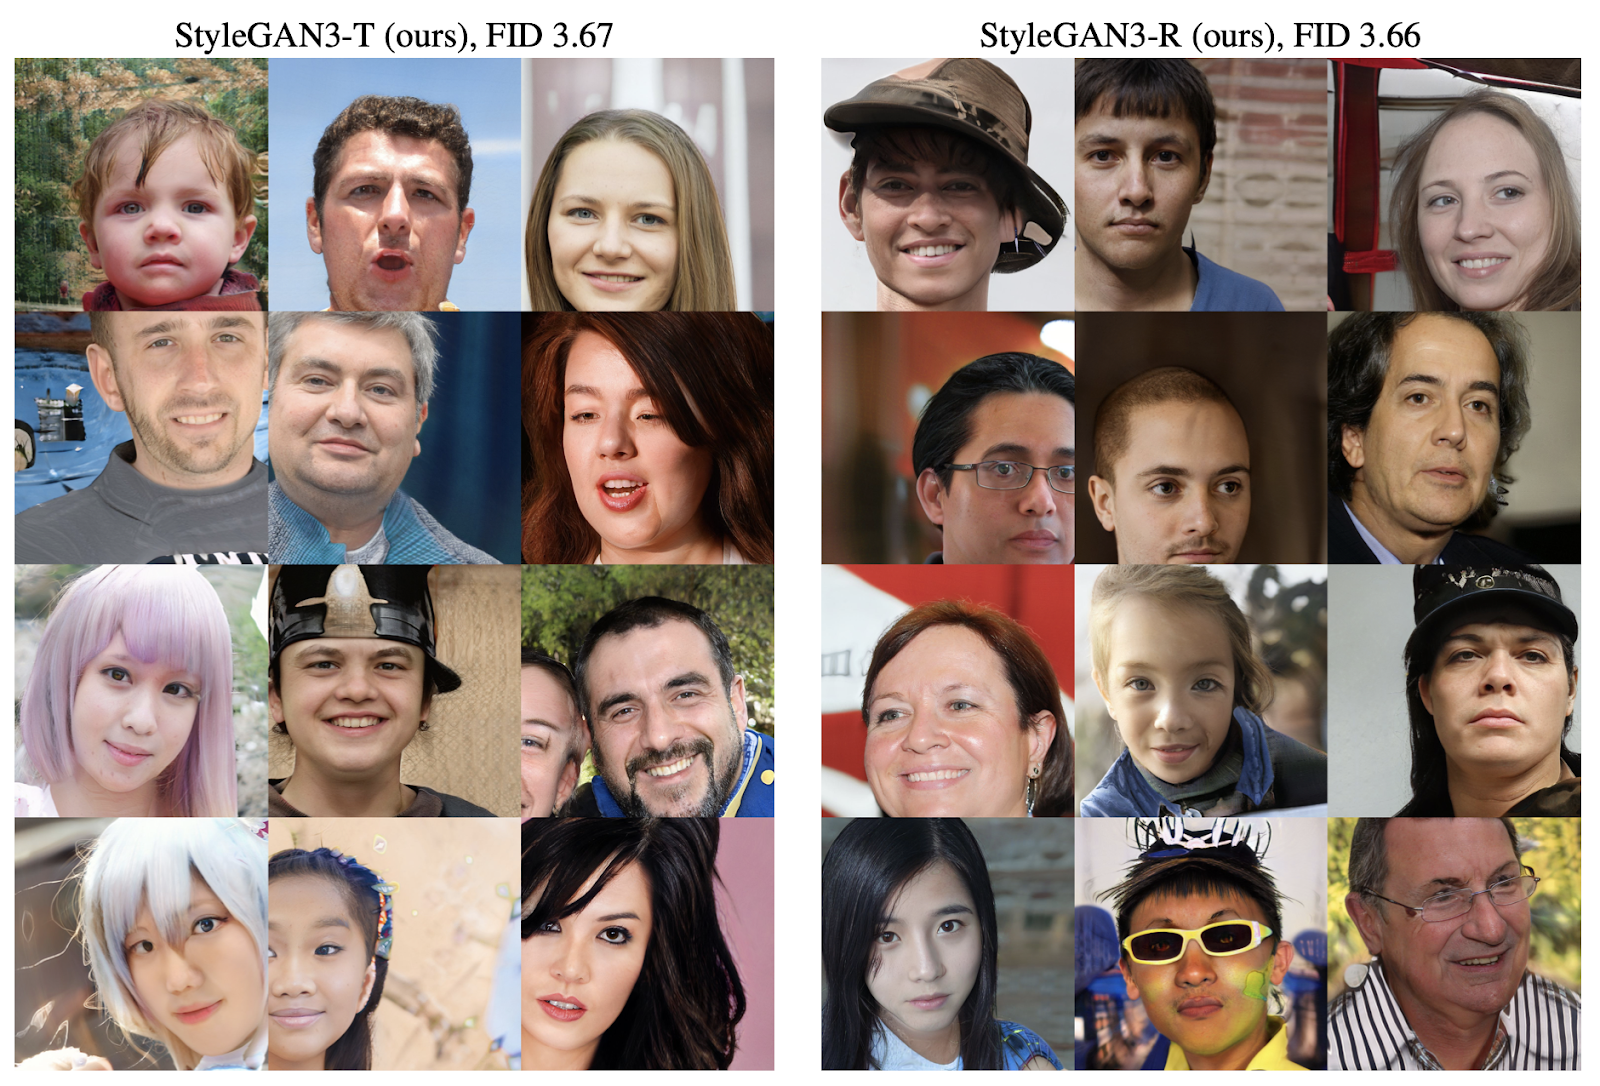
불과 몇 년 전만 해도 이러한 최첨단 모델이
그러나 경쟁의 특성상GAN 모델은 학습 시 매우 불안정하며 생성 시 매우 다양한 이미지 유형을 표시하지 않습니다. 또한 텍스트에서 이미지를 생성하는 작업에는 적용할 수 없지만 이에 대한 예가 있습니다.
확산 모델의 붐
확산 모델은 반대로생성된 이미지의 가변성이 충분하고 매우 안정적입니다. 그들의 주요 단점은 학습 및 생성 속도입니다. 모델을 훈련시키는 데 수십 또는 수백 개의 비디오 카드가 필요하며 이미 훈련된 모델을 사용하여 이미지를 생성하는 데는 수십 밀리초가 걸리는 GAN과 달리 몇 초가 걸립니다.

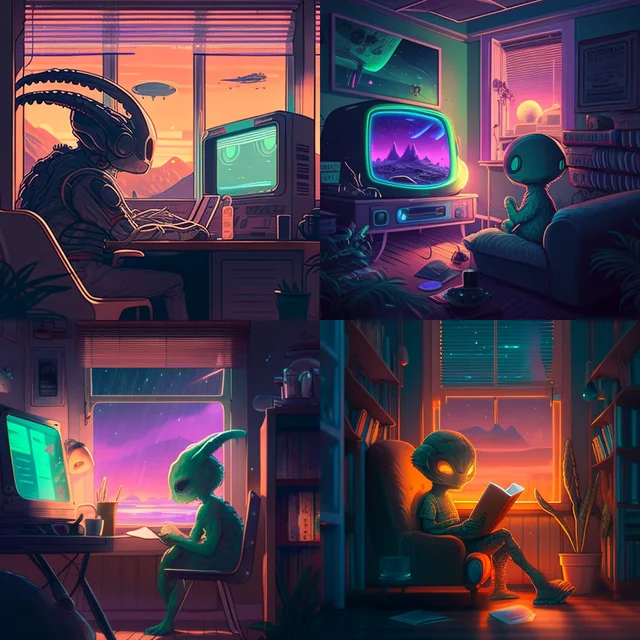
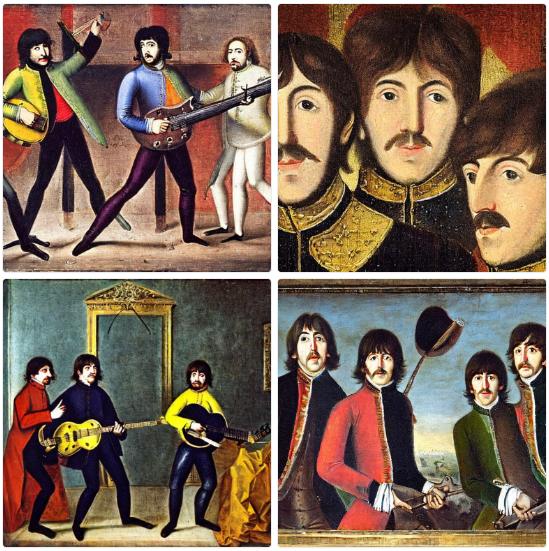
확산 모델 주변의 붐은 출구에 의해 촉진됩니다.대형 생성 텍스트-이미지 모델. 확실히 많은 독자들이 DALL·E 2, MidJourney, Imagen 또는 Stable Diffusion에 의해 생성된 결과를 보았습니다. 일부 아티스트와 일러스트레이터는 신경망이 작업을 앗아갈까 걱정하는 반면, 다른 아티스트와 일러스트레이터는 신경망이 창작 과정에만 도움이 될 것이라고 생각합니다. 프로그래머와 아티스트는 프롬프트 엔지니어링(보다 정확한 생성 결과를 얻기 위해 텍스트를 선택하는 기술)을 마스터하고 흥미로운 요청과 그에 못지않게 흥미로운 결과를 공유합니다.
확산 모델은 어떻게 작동합니까?
확산 모델은 반복 모델입니다.무작위 노이즈를 입력으로 받아들입니다. 시작하려면 Ho et al.이 제시한 가장 기본적인 확산 모델인 DDPM(Denoising Diffusion Probabilistic Model)을 고려하십시오. 이 모델은 수십만 개의 이미지 샘플에 대해 단계별로 훈련되며, 알려진 강도의 무작위 노이즈가 각 단계에서 샘플의 이미지에 적용되고 모델은 이 노이즈를 역전시키는 방법을 학습하여 이미지 품질을 향상시킵니다. 이러한 방식으로 훈련된 모델을 완전히 무작위 노이즈의 그림에 반복적으로 적용하면 각 단계에서 "약한" 노이즈를 반전시켜 모델이 완전히 새로운 이미지를 생성하고 역확산을 사용하여 무작위 노이즈를 점진적으로 제거할 수 있습니다.
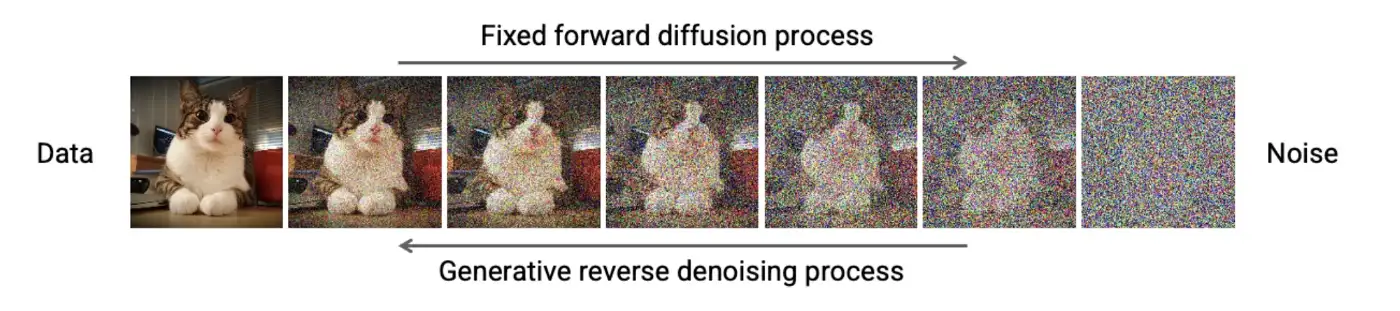
기본 확산 프로세스 그림(CVPR 2022 튜토리얼에서 발췌)
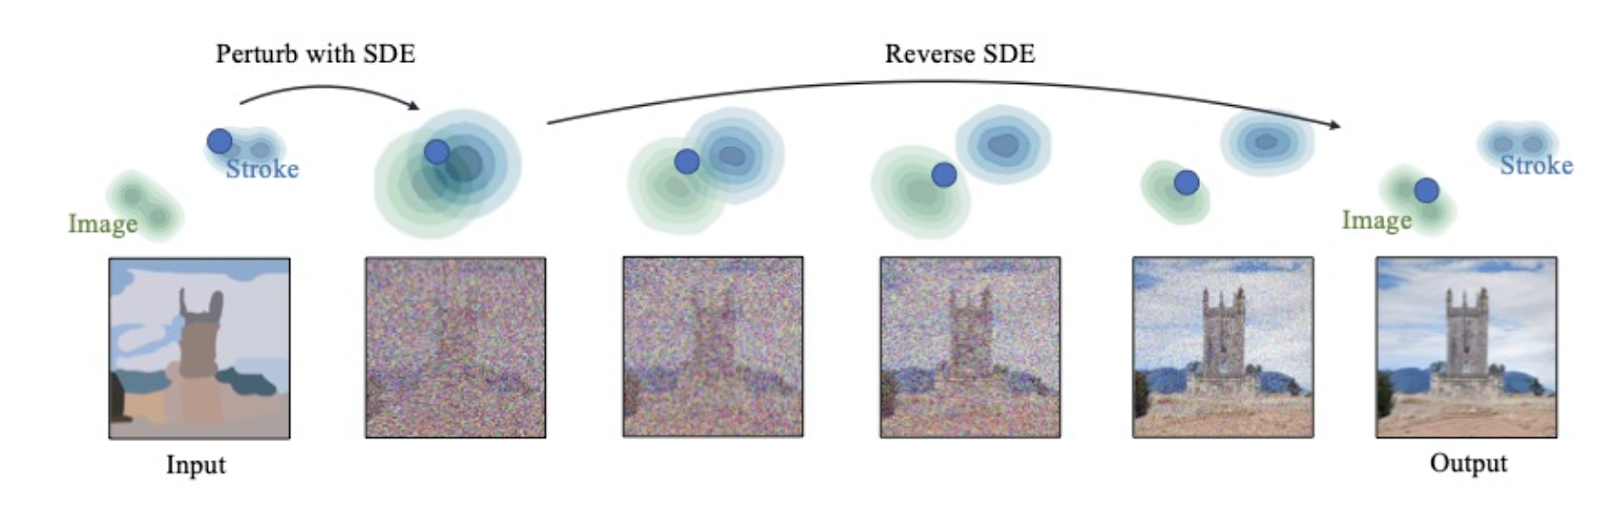
생성되는 무작위 노이즈이미지는 조건(텍스트나 다른 예시 이미지로 표현되는 결과에 대한 요구 사항)과 결합될 수 있습니다. 먼저, 사용자가 신경망에 큰 획으로 구성된 그림을 나타내는 SDEdit 기사의 예를 살펴보겠습니다. 이 그림은 예를 들어 잡음이 있는 사진과 구별할 수 없을 정도로 잡음이 더 심하며, 그런 다음 제공된 그림을 기반으로 고품질 이미지를 재구성하는 반복적인 역확산 프로세스가 적용됩니다.
세대를 원하는 방향으로 안내하는 또 다른 방법결과는 텍스트에 의한 모델의 조건입니다. 이를 위해 이미지와 텍스트의 의미를 동시에 이해할 수 있는 이미지 쌍과 캡션에 대해 학습된 언어 모델이 사용됩니다. 이러한 모델의 예로 OpenAI에서 출시한 CLIP(Contrastive Language - Image Pre-training)이 있습니다. 이 모델은 이미지와 텍스트를 공통 잠재 벡터 공간으로 변환할 수 있습니다(여기서 벡터는 일부 값의 열일 뿐입니다). 예를 들어 이 공간에서 텍스트 쿼리에 가장 가까운 이미지를 찾는 것이 가능해집니다. 이는 벡터에 대한 대수 연산이기 때문입니다.
잠재 확산 모델,2021년에 도입된 조건은 방향성 노이즈에서 이미지를 생성하기 위해 텍스트의 벡터 공간에 대한 모델입니다. 이 모델은 텍스트와 이미지의 공통 잠재 공간 속성을 사용합니다. Stable Diffusion, Imagen 및 기타 대규모 텍스트-이미지 신경망은 이 원칙에 따라 작동합니다.
품질을 향상시키는 또 다른 중요한 기술조건부 확산 모델 훈련에 사용되는 세대는 분류자 무료 안내입니다. 간단히 말해서, 분류자 무료 안내 매개변수의 값이 높을수록 결과가 텍스트 쿼리와 더 유사해지며 결과의 변동성이 줄어드는 경우가 많습니다.
확산 모델의 문제점
물론 확산 모델은 그렇지 않습니다.이미지 생성 문제에 대한 보편적인 솔루션입니다. 그들은 여전히 GAN과 같은 문제에 노출되어 있습니다. 언뜻 보기에 실제 이미지에는 상당한 단점이 있습니다. 생성된 사람은 5개 이상의 손가락 또는 32개의 치아를 가질 수 있습니다. 또한 이러한 모델은 이미지에 텍스트를 생성하는 데 상당히 서투르고 심지어 자체 "언어"를 발명하기도 합니다.
아티스트들은 Midjourney와 Stability AI를 비난합니다.(Stable Diffusion 소속 회사) 훈련 데이터 준비 시 저작권 침해 - 해당 회사가 아티스트의 동의나 적절한 보상 없이 인터넷에서 이미지를 다운로드했다고 주장합니다. Stable Diffusion을 포함한 생성 네트워크는 인터넷에서 얻은 편향된 데이터를 기반으로 훈련되기 때문에 인종, 성별 및 기타 사회 문제에 대한 부정적인 고정관념을 강화한다는 우려도 커지고 있습니다.
무료로 체험하는 방법
이전의 많은 개발과는 달리프로그래머만이 접근할 수 있었던 컴퓨터 비전 분야와 달리, 확산 네트워크 분야의 새로운 기술은 누구나 시도할 수 있는 경우가 많습니다. 오픈 소스 소프트웨어 및 신경망의 데모 버전 게시를 향한 일반적인 추세로 인해 Hugging Face와 같은 스타트업은 Stable Diffusion 2.1과 같은 여러 버전의 모델을 집계할 수 있습니다. 또한 코드에서 모델 사용을 단순화하도록 설계된 디퓨저 라이브러리도 개발 중입니다.
Google Colab 서비스를 사용하면 다음에서 코드를 실행할 수 있습니다.GPU와 TPU를 사용하여 많은 매니아들이 자신의 모델 버전을 게시하는 데 이를 사용합니다. 예를 들어 비디오 스타일을 변경할 수 있는 Disco Diffusion Warp 모델이 있습니다.
모델에 대한 편리한 인터페이스도 있습니다.따라서 MidJourney 신경망은 수십 세대에 걸친 무료 평가판을 가지고 있으며 이는 텍스트-이미지 모델을 시도하기에 충분합니다. OpenAI는 또한 DALL·E 2 모델에 대한 평가판 액세스를 제공하고 있습니다.
다음은 무엇입니까?
우리는 황금시대를 경험하고 있다고 자신있게 말할 수 있다.신경망 이미지 생성 시대. 커뮤니티는 비공개 확산 모델인 Imagen과 기타 인공 지능 기술 사용을 포함한 이미지 편집 및 생성에 대한 수많은 기사를 출시한 Google의 미래 제품을 간절히 기다리고 있습니다.
창작 분야에서 새로운 스타트업이 등장하고 있습니다.OpenAI나 Google과 같은 거대 기업과 성공적으로 경쟁하는 이미지 편집입니다. 확산 모델에 대한 새로운 기사는 거의 매주 게시되며 오늘날 적용 범위는 나열된 2D 컴퓨터 비전 작업에만 국한되지 않고 의료 영상 작업, 비디오 생성 및 3D 텍스트에 사용됩니다.
더 읽어보기 :
목성의 위성에 있는 붉은 줄무늬의 비밀이 밝혀지다
"불가능한" 행성을 찾았습니다. 그녀는 현대 과학을 무시
소금 사막의 신비한 육각형 "벌집"이 설명을 찾았습니다.