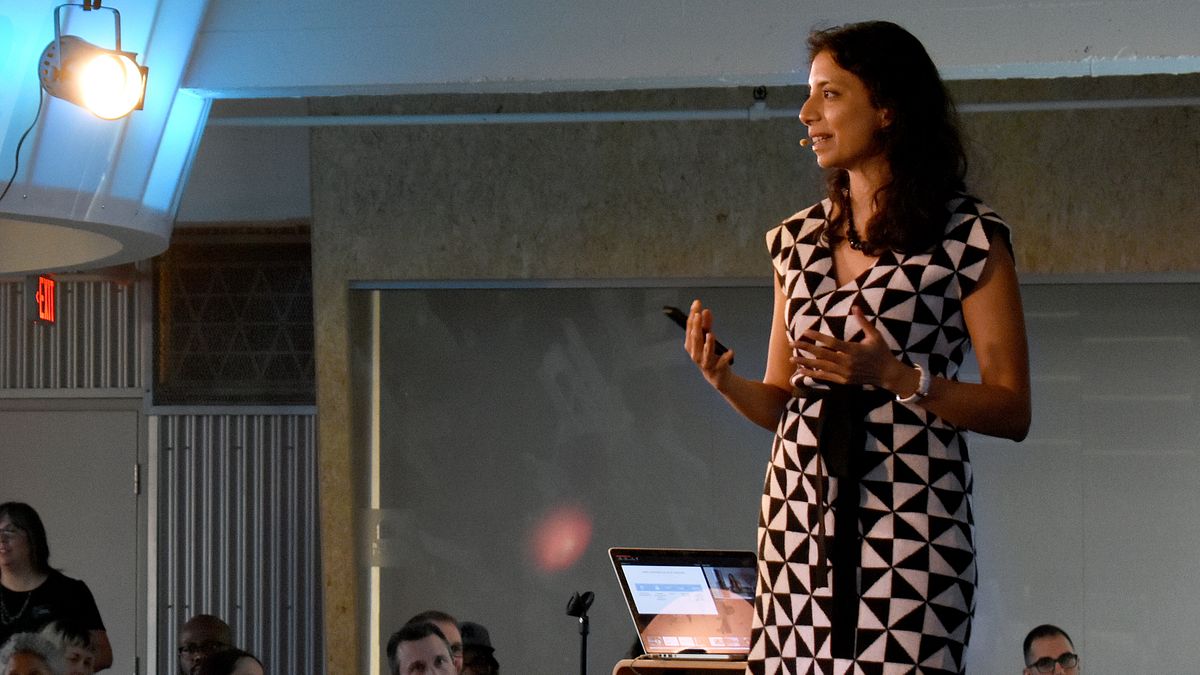
Anima Anandkumaryra Kalifornijos technologijos instituto profesorius ir tyrimų direktorius
"Padėtis dėl koronaviruso rodo, kad žmonės yra žymiai priekyje AI."
Kaip prasidėjo dirbtinio intelekto revoliucija?Kelis dešimtmečius įdomuatradimai šioje srityje. Žmogui nėra nieko žemiškesnio, nei atpažinti vaizdus ekrane. Tačiau dirbtiniam intelektui tai yra nepaprastai sunki užduotis, nes jis nėra gimęs turėdamas tam jau suteiktus sugebėjimus. Mokslininkai susidūrė su užduotimi „išmokyti“ mašinų smegenis atpažinti tai, ką jos matė. Pirmosiomis tyrimų dienomis Stanfordo profesorius pradėjo fiksuoti vaizdus, kad kompiuteriui būtų lengviau juos klasifikuoti. Tai buvo paženklinti paveikslėliais, kurie pradėjo gilų neuroninio mokymosi revoliuciją.
Naujo dirbtinio intelekto lygio pasiekimas prasidėjo į programą įtraukus milijardus parametrų, kurie leis atpažinti konkretų objektą.Užduoties sunkumas yra sukurti gilų neuroninį tinkląnekintamumo sąlygomis ji atpažino, pavyzdžiui, šunį, neatsižvelgdama į laikysenos, spalvos, veislės ir pan. skirtumą. Dirbtinio intelekto mokymas reiškia, kad apdorojant vaizdą, daugybė kadro sluoksnių yra žiūrimi hierarchine tvarka. Taigi, pagrindiniame lygyje skirtingais kampais vienas kitam matomos tik linijos. Tada jie sujungia ir sudaro sudėtingesnes formas, pavyzdžiui, šuns veido spalvą. Jau galima atskirti formą, spalvą ir kitas individualias savybes. Būtent etapas, kai mes išmokome procesą padalinti į dalis, į lygius, tapo didžiuliu žingsniu į priekį.
Tolesniam vystymuisi reikalingi ne tik gilūs neuroniniai tinklai, bet ir didžiulė skaičiavimo galia.Per pastaruosius dešimtmečius matėmesulėtėjęs mūsų kompiuterių pajėgumų augimas, kai vienos gijos skaičiavimo greitis nebepadvigubėja. Tačiau tuo pat metu dabar galime vienu metu apskaičiuoti milžiniškos apimties ir sudėtingumo operacijas. Dabartinis giliųjų tinklų išsivystymo lygis lėmė tai, kad dabar juose vienu metu gali vykti milijardai procesų. O jų tikslas tik vienas: nustatyti, kas pavaizduota nuotraukoje. Ši procedūra atliekama naudojant matricinės animacijos procesus ir kitas technologijas. Ir čia, žinoma, viskas priklauso nuo vaizdo plokščių galios.
Iki 2014 m. Gilieji neuroniniai tinklai sugebėjo atpažinti vaizdus geriau nei žmonės, o tai reiškia, kad šiandien jie tapo dar labiau pažengę.Tai įvyko dėl trijų derinioveiksniai: pažymėtų duomenų galimybės, esamų giliųjų neuroninių tinklų algoritmų lankstumas ir milžiniškos kompiuterių galimybės. Yra daug puikių pavyzdžių, kokių aukštumų mašinos smegenys jau pasiekė, pavyzdžiui, gilus mokymasis padėjo dirbtiniam intelektui įveikti žmogų žaidime „Go“. Šis žaidėjas buvo vienas geriausių, bet pralaimėjo. Be to, dirbtinis intelektas dabar gali sukurti tokias tikroviškas žmonių nuotraukas, kad ši technologija jau išlaikė Turingo testą. Žmogus nebegali suprasti, kuris vaizdas yra tikras, o kurį sukūrė mašina. Tai puikūs AI sėkmės pavyzdžiai, tačiau pažanga tuo tikrai nesibaigs.
Tačiau yra keletas pavyzdžių, kai dirbtinis intelektas neatitiko lūkesčių.Tarkime, situacija, kai pagrindinis aspektasyra saugumas. Jau kelis dešimtmečius matome, kad daugėja autonominiuose automobiliuose naudojamų technologijų, tačiau, deja, jų sudėtingumas vis dar lemia avarijas. Be to, mašina negali pakeisti žmogaus, kai reikia kurti ir redaguoti turinį. O dabartinė koronaviruso situacija rodo, kad žmonės gerokai lenkia AI.
Ką veiksime ateityje, plėtodami dirbtinį intelektą ir giliųjų neuroninių tinklų technologijas?Šiuo metu aktyviai vystosirobotika: pavyzdžiui, viena įmonė turi robotą, galintį atlikti apvertimus atgal. Bet jo net negalima lyginti su šunimi. Šis robotas yra nepatogus, nuolat krenta, tačiau gyvūnas krisdamas išmoksta, kaip kitą kartą atlikti tą ar kitą judesį nenukrisdamas. Bet robotas to nesugeba, nėra apmokytas. Tai kelia klausimą, ar įmanoma sukurti DI, kuris būtų pasirengęs mokytis ir savarankiškai spręsti problemas?
"Algoritmų supratimas viršija mūsų galimybes."
Dirbtinio intelekto algoritmas yra iš anksto nustatytos informacijos rinkinys ir labai aiški užduotis.Kokius duomenis nustatome ir preliminariaiturėtų būti naudojami nurodyti parametrai, taip pat kaip įgyvendinti sprendimų priėmimo procesą. AI algoritmo sukūrimas ir priežiūra reikalauja didžiulio duomenų kiekio. Tai sunku, nes atsiranda vis daugiau duomenų, pavyzdžiui, atpažįstant vaizdo srautą, atpažįstamų kadrų skaičius yra labai didelis. Ženklinimas yra problemiškas, nes žmonės priskiria pavadinimus milijonams vaizdo įrašų, taigi ir objektams ekrane.
Kalbant apie iš anksto nustatytus parametrus, vėlgi turite susidoroti su tuo, kad viskas atliekama rankiniu būdu.Šiais laikais dirbtinį intelektą lengva apgauti.Pavyzdžiui, jei turime „stop“ ženklą ir ant jo pastatome kelis blokus, tai dirbtinis intelektas nebesupras jo reikšmės. O be vairuotojo pagalbos judantis automobilis šio ženklo nebeatpažįsta kaip raginimo sustoti. Mūsų žmogaus intelektas yra visiškai kitoks. Galbūt savo mąstymą galime perkelti į kompiuterį, bet kol kas to padaryti nepavyko. Kalbant apie nurodymus, įsakymus ir nurodymus, turime elgtis labai paprastai: duodame vieną užduotį – atpažinti tai, kas pavaizduota šiame paveikslėlyje. Kalbant apie algoritmo sėkmės ar neveiksmingumo vertinimo parametrus, čia mes esame labai riboti.
Mes kartais negalime suprasti, koks sėkmingas yra dabartinis algoritmas, nes jis mums nepriklauso.Be to, yra keletas problemų, susijusių sufaktas, kad mūsų turimi duomenys daugiausia yra apie šviesaus gymio vyrus. Dėl šios priežasties AI klaidingai identifikuoja tamsiaodes moteris. Yra ir kitų veido atpažinimo klaidų. Problema kyla dėl to, kad dirbtinio intelekto efektyvumo vertinimas yra itin ribotas. Negalime pamiršti paradigmos, teigiančios, kad mums reikia didžiulių duomenų kiekių ir visi jie turi būti pažymėti. Iš anksto nustatyti parametrai turi būti aiškūs algoritmui, o pati užduotis turi būti paprasta ir logiška.
Pirmiausia turite įsitikinti, kad jums nereikia žymėti duomenų.AI turi veikti be žmogaus pagalboskompiuteris pats surado sąvokas, formavo idėjas ir suprato konkretaus vaizdo ypatybes. Ar sunku? Taip, labai, bet žmonės tai daro ir lengvai. Kalbant apie iš anksto nustatytus duomenis, čia turime sukurti labai aiškius vaizdus, kad parodytume, kas yra iš duomenų, kuriuos „paduodame“ sistemai. O čia iš žmogaus smegenų galima daug pasimokyti. Ir galiausiai užduotys, kurias pateikiame algoritmui. Dirbtinis intelektas turi būti labiau prisitaikantis, nes dabar mes kiekvieną kartą treniruojame savo sistemą nuo nulio, bet reikia padaryti taip, kad ji prisitaikytų ir keistųsi, atliktų įvairias užduotis. Taigi dabar mes mokomės, kad dirbtinis intelektas būtų lankstus.
Kaip suprasti, kad turime katę?
Atpažįstame katę, net jei tai neryškus vaizdas, nes mūsų smegenys nuolat bando suteikti neryškiam vaizdui tam tikrą ryškumą tolesnei analizei.Yra daugybė teorijų ir viena garsiausiųsako, kad mes ne tik žiūrime į kokį nors objektą, bet ir smegenys parenka variantus, kokie tai gali būti. Gilūs neuroniniai tinklai daro tą patį. Turime a priori duomenų, kaip katė turėtų atrodyti. Ir mes bandome suderinti šią nuotrauką su mintimi, kaip atrodo katės. Svarbu tai suprasti kūrimo metu, kad būtų užtikrintas vaizdo identifikavimo nuoseklumas.

Kaip galime pasiekti stabilumą identifikuojant objektus dirbtiniais tinklais?Tai natūraliai atsiranda dėlpakartojamumas. Mes nufotografuojame išorinį vaizdą ir žiūrime į jį, o signalas patenka į smegenis. Taip pat yra atsiliepimų iš viršaus į apačią. Naudodamos informaciją apie tai, kaip katė atrodo, smegenys formuoja tam tikrą suvokimą. Kaip atlikti šiuos sudėtingiausius mūsų smegenų procesus įgyvendina dirbtinis intelektas? Būtina sujungti gerą „katės“ sąvokos klasifikatorių, kuris „maitins“ nervinį tinklą, su puikiu šių vaizdų generatoriumi. Tuo pačiu metu vyks neuroninio tinklo sampratos klasifikavimas ir mokymas. Atsiliepimai bus gauti apie standartinius neuroninius tinklus. Šis ryšys suteiks galimybę gauti generatyvinį grįžtamąjį ryšį. Kitaip tariant, bandydamas apdoroti gaunamą signalą, žmogus bando pažymėti vaizdą. Ir tada yra grįžtamasis ryšys, kai mes bandome sukurti suvokimą pagal tai, ką matome. Šie du procesai turi būti tarpusavyje susiję.
Standartinis neuroninis tinklas, kaip taisyklė, negali atpažinti neryškių vaizdų, tačiau mūsų modelis, grįžtamojo ryšio mechanizmo dėka, daro vaizdus aiškesnius ir gali juos atpažinti.Matome, kad tokia schema pasitvirtinoefektyvumą, todėl galime būti įkvėpti to, kaip žmonės mato kurdami kompiuterinę viziją. Remdamiesi jau sukurtais modeliais, galite sukurti pažangesnius algoritmus, kurie turės didelį našumą. Tačiau mums taip pat reikia veiksmingos infrastruktūros, kuri galėtų valdyti AI procesus dideliu mastu. Individualiai su algoritmais nedirbame. Jūs paimate kai kuriuos duomenis ir turite juos vizualizuoti, o tai yra labai sudėtingas procesas. Todėl jums reikia galingo procesoriaus, galinčio apdoroti įspūdingus informacijos kiekius. Be to, mes naudojame tam tikras sistemas (CLARA) įvairioms programoms, įskaitant mediciną. Dabar, atsižvelgiant į COVID-19 pandemiją, reikia mokyti mašininio mokymosi modelius dideliu mastu. To tikslas – sukurti vakcinas ir vaistus nuo viruso. CLARA įrankis gali dirbti su trimatėmis struktūromis ir įvairiais algoritmais, iš esmės būdamas jų darbo koordinatorius.
Kita dirbtinio intelekto mokymosi galimybė yra naudoti stimuliuojamus duomenis, o ne realius duomenis.Turime daugybę robotų, kuriais galime taptivirėjai mūsų virtuvėse. Tokios mašinos gali atidaryti ir uždaryti stalčių, paimti daiktą, ką nors sumaišyti ar plakti. Šios žmonėms paprastos operacijos yra labai sunkios robotams, nes sunku juos išmokyti tai daryti. Bet simuliacinių procesų pagalba galėsime atidaryti neegzistuojančias, užprogramuotas dėžes. Ir taip robotas išmoksta panašių operacijų. Programos leidžia tai daryti lygiagrečiai ir dideliu mastu, o tai leidžia įveikti duomenų mums keliamus apribojimus. Tačiau tokia mokymo sistema reiškia, kad reikia sukurti labai sudėtingus algoritmus, kurie nuves mašiną iš modeliavimo pasaulio į realų pasaulį ir atvers visiškai naujas, įdomias darbo su AI perspektyvas. Yra programa, leidžianti prie tų modelių pridėti modeliavimą, kai dirbtinis intelektas mokomas remiantis tikrais duomenimis. Tai dar vienas pavyzdys, kad turime gerą infrastruktūrą ir galime spręsti labai sudėtingas problemas. Atsirado galimybė kurti naujus algoritmus ir modelius, taip pat juos išbandyti daug greičiau nei buvo padaryta anksčiau.
Dirbtinio intelekto ateitis turi būti visapusiška ir įsikūnyti į skirtingas sferas, kad turėtume labai adaptyvią, nuolat mokančią priemonę.Kad tai padarytume, dabar turime persvarstyti būdusgilus mokymasis. Savarankiškas mokymasis yra raktas į sėkmę, todėl turime rasti būdų, kaip sukurti neprižiūrimas mokymosi programas į sistemas. Ir jei mes kalbame apie konvoliucinius neuroninius tinklus, grįžtamojo ryšio sistema daro juos stabilesnius. Ir tai yra pirmasis žingsnis kuriant tikrą naujos kartos AI bazę.
Taip pat žiūrėkite:
Lobių ieškotojas Škotijoje randa 3000 metų senumo lobį
„Perseids“ meteorų lietus - 2020 m .: kur jį pamatyti, kur ieškoti ir kaip nusifotografuoti
Pažvelkite į 3D Visatos žemėlapį: jis buvo sudarytas 20 metų ir jau nustebino mokslininkus