Kiekvienas analizės žodis turi savo įvertinimą. Mokslo ir kultūros temų aptarimas, anglų kalbos vartojimas
Tyrimą parėmė Rusijos mokslo fondo parama.
panaudotas Smirnovo tyrimasreprezentatyvi HSE longitudin kohortos grupės tyrimo „Išsilavinimo ir karjeros trajektorijos“ (TrEC) duomenų imtis. Tyrimas stebi 4400 studentų iš 42 Rusijos regionų iš universitetų, dalyvaujančių PISA (Tarptautinės studentų vertinimo programos) programoje, karjeros raidą. Į tyrimo duomenis buvo įtraukti ir studentų VK sąskaitų duomenys (šią informaciją sutiko pateikti 3 483 studentai).
„Kadangi tokie duomenys kartu su skaitmeniniaispėdsakų sunku gauti, jie beveik niekada nenaudojami “, - aiškina Smirnovas. Tuo tarpu toks duomenų rinkinys leidžia sukurti patikimą modelį, kurį galima pritaikyti kitiems parametrams. Rezultatus galima ekstrapoliuoti visiems kitiems studentams - gimnazistams ir gimnazistams.
Kaip mokymo pavyzdį mes naudojomežinutės iš viešų puslapių „VKontakte“ - iš viso 130 575 žinutės iš 2468 žmonių, kurie 2012 m. išlaikė PISA testą. Testas leido tyrėjui įvertinti studento akademinius gebėjimus, taip pat sugebėjimą praktiškai parodyti savo žinias. Tyrime dalyvavo tik viešai prieinami „VKontakte“ pranešimai iš sutartų dalyvių.
Tyrimo metu VKontakte postkorpuse buvo atliktas neprižiūrimas mašininis mokymasis su vektoriniu žodžių vaizdavimu (iš viso 1,9 mlrd. žodžių, su 2,5 mln. unikalių žodžių).
„Kiekvieną įrašą pristatėme kaip 300 dimensijųvektorių, apskaičiuojant visų jo sudedamųjų žodžių vektorinius vaizdus “, - aiškina Smirnovas. "Šie pranešimų rodiniai buvo naudojami linijinės regresijos modeliui mokyti, kad būtų galima numatyti PISA įrašų autorių įvertinimus".
Pagal „prognozę“ tyrėjasreiškia ne ateities numatymą, o koreliaciją tarp apskaičiuotų rezultatų ir faktinių mokinių PISA egzamino surinktų balų, taip pat jų vieningo valstybinio egzamino rezultatų (kurie yra viešai prieinami internete apibendrinta forma – t. y. vidurkis mokykloje). Pradiniame etape modelis išmoko numatyti PISA duomenis. Galutiniame modelyje skaičiavimai buvo lyginami su abiturientų ir stojančiųjų Vieningų valstybinių egzaminų rezultatais.
Manoma, kad galutinis modelis sugebėjopatikimai atpažinti, ar stiprus, ar silpnas studentas parašė konkretų įrašą socialiniame tinkle, arba, kitaip tariant, diferencijuoti dalykus pagal jų akademinę veiklą. Po mokymų laikotarpio modelis sugebėjo 93,7% tikslumu atskirti pranešimus, kuriuos parašė studentai, surinkę aukštus ar žemus PISA balus (5-6 ir 0-1 lygiai). Kalbant apie PISA ir USE palyginamumą, nors abu testai skiriasi, tyrimai parodė, kad šių dviejų testų studentų rezultatai yra labai susiję tarpusavyje.
Paaiškėjo, kad „numatomi akademiniai rezultatai yra glaudžiai susijęsusijęs su egzamino rezultatais “, - sako Smirnovas. „Koreliacijos koeficientas yra tarp 0,49 ir 0,6. Universitetų atveju, kai buvo lyginami numatomi akademiniai rezultatai ir USE balai (informacija, pateikta dabartiniame tyrime, Stebėjimo priėmimo į universitetus kokybė), rezultatai taip pat parodė tvirtą ryšį. Koreliacijos koeficientas yra 0,83, tai yra žymiai didesnis nei vidurinėje mokykloje, nes daugiau duomenų. "
Rezultatai
Smirnovas išryškino įprastus teksto bruožuspranešimus, atsižvelgiant į jų autorių pažangą. Nustatyta, kad antraštinių žodžių (-0,08), jaustukų (-0,06) ir šauktukų (-0,04) naudojimas neigiamai koreliuoja su akademine veikla. Kita vertus, lotyniškų simbolių naudojimas, vidutinis žinutės ir žodžio ilgis, žodyno dydis ir vartotojo tekstų entropija teigiamai koreliuoja su akademine veikla (atitinkamai nuo 0,07 iki 0,16).
Taip pat patvirtinta, kad skirtingų pasiekimų lygių mokiniai turi skirtingą žodyną.
Gerai pasirodę studentai naudojo:
- Angliški žodžiai;
- Žodžiai, susiję su literatūra (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Koncepcijų skaitymas (skaityti, publikuoti, knygą, tomą);
- Terminai ir pavadinimai, susiję su fizika (Visata, kvantas, teorija, Einšteinas, Niutonas, Hokingas);
- Žodžiai, susiję su mąstymo procesais (mąstymas, įsiminimas).
Žemų balų studentai vartojo žodžius suklaidos, populiarių kompiuterinių žaidimų pavadinimai, sąvokos, susijusios su karine tarnyba (armija, priesaika ir kt.), horoskopo terminai (Avinas, Šaulys) ir žodžiai, susiję su vairavimu ir autoįvykiais (susidūrimas, kelių policija, ratai, derinimas).
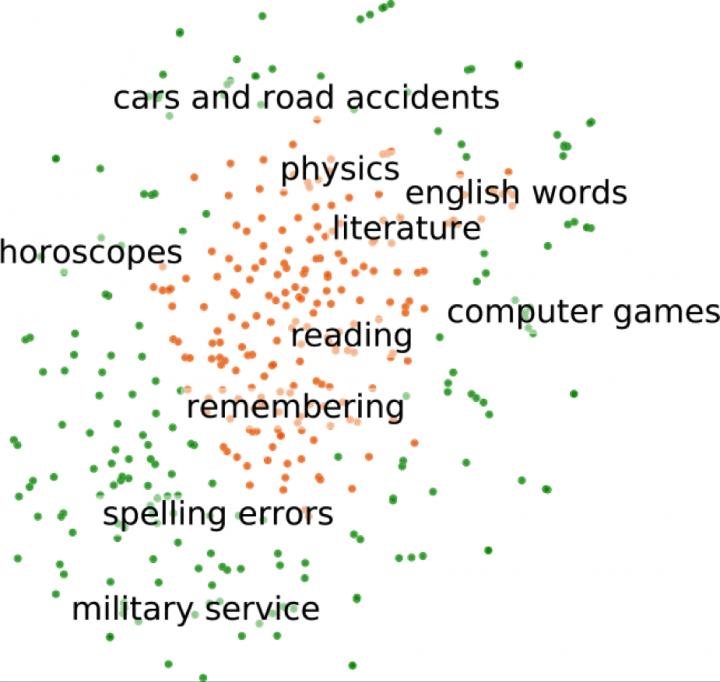 Teminiai klasteriai: Aukščiausio ir žemiausio įvertinimo žodžiai iš mokymo duomenų rinkinio
Smirnovas paskaičiavo koeficientus visiems 2,5 mlnvektorinio modelio žodžius ir pateikė juos tolesniam tyrimui. Įdomu tai, kad net žodžiai, kurie yra reti mokymo duomenų rinkinyje, gali numatyti akademinius rezultatus. Pavyzdžiui, net jei pavadinimas „Niutas“ (kaip Hario Poterio veikėjas Niutas Skamanderis) niekada nepasirodo treniruočių duomenyse, modelis gali priskirti aukštesnį įvertinimą žinutėms, kuriose jis yra. Taip atsitiks, jei modelis sužinos, kad žodžius iš romanų serijos vartoja daug pasiekę mokiniai, o be priežiūros besimokantis modelis „intuityviai“ supras, kad pavadinimas „Niutas“ patenka į šią kategoriją.
Taip pat skaitykite
Kasmetinė misija Arktyje baigėsi ir duomenys nuvilia. Kas laukia žmonijos?
Stebėkite, kaip naujasis „Hummer“ įveikė kliūtis kelyje, judėdamas kaip krabas
3 ligos dieną dauguma COVID-19 pacientų praranda kvapo pojūtį ir dažnai kenčia nuo slogos