Katram vārdam analīzē ir savs vērtējums. Zinātnisko un kultūras tēmu apspriešana, angļu valodas lietošana
Pētījumu atbalstīja Krievijas Zinātnes fonda dotācija.
Smirnova pētījums izmantotsreprezentatīvs datu paraugs no HSE garengriezuma kohortas paneļa pētījuma “Izglītības un karjeras trajektorijas” (TrEC). Pētījumā tiek izsekots 4400 studentu karjeras attīstībai no 42 Krievijas reģioniem no universitātēm, kas piedalās programmā PISA (Starptautiskā studentu novērtēšanas programma). Pētījuma datos tika iekļauti arī dati par studentu VK kontiem (3483 studentu dalībnieki piekrita sniegt šo informāciju).
“Kopš šādiem datiem, apvienojumā ar digitālajiempēdas ir grūti iegūt, tās gandrīz nekad neizmanto, ”skaidro Smirnovs. Tikmēr šāda datu kopa ļauj izstrādāt stabilu modeli, kuru var piemērot citiem parametriem. Rezultātus var ekstrapolēt visiem pārējiem studentiem - vidusskolēniem un vidusskolēniem.
Kā apmācības paraugu mēs izmantojāmziņojumi no VKontakte publiskām lapām - kopā 130 575 ziņojumi no 2468 cilvēkiem, kuri 2012. gadā izturēja PISA testu. Tests ļāva pētniekam novērtēt studenta akadēmiskās spējas, kā arī spēju praksē demonstrēt savas zināšanas. Pētījums ietvēra tikai publiski pieejamus VKontakte ziņojumus no norunātajiem dalībniekiem.
Pētījuma laikā VKontakte postkorpusā tika veikta bez uzraudzības mašīnmācīšanās ar vārdu vektora attēlojumu (kopā 1,9 miljardi vārdu, ar 2,5 miljoniem unikālu vārdu).
“Mēs katru ziņu esam prezentējuši kā 300 dimensijuvektorus, aprēķinot visu tā sastāvā esošo vārdu vektoru attēlojumus, ”skaidro Smirnovs. "Šie ziņu skati tika izmantoti, lai apmācītu lineāru regresijas modeli, lai prognozētu PISA ziņu autoru vērtējumus."
Pēc "prognozes" pētnieksnenozīmē nākotnes prognozēšanu, bet gan korelāciju starp aprēķinātajiem rezultātiem un patiesajiem skolēnu PISA eksāmenā iegūtajiem punktiem, kā arī viņu vienotā valsts eksāmena rezultātiem (kas apkopotā veidā ir publiski pieejami internetā – t.i., tie ir vidējie rādītāji skolā). Sākotnējā posmā modelis iemācījās prognozēt PISA datus. Galīgajā modelī aprēķini tika salīdzināti ar vidusskolu absolventu un reflektantu Vienoto valsts pārbaudījumu rezultātiem.
Bija paredzēts, ka galīgais modelis to spēsuzticami atpazīt, vai spēcīgs vai vājš students ir uzrakstījis konkrētu ierakstu sociālajā tīklā, vai, citiem vārdiem sakot, diferencēt priekšmetus atbilstoši viņu akadēmiskajam sniegumam. Pēc apmācības perioda modelis spēja atšķirt studentu rakstītus ziņojumus ar augstu vai zemu PISA punktu skaitu (5. – 6. Līmenis un 0–1. Līmenis) ar precizitāti 93,7%. Attiecībā uz PISA un USE salīdzināmību, lai arī abi testi atšķiras, pētījumi ir parādījuši, ka studentu sniegums šajos divos testos ir ļoti korelē viens ar otru.
Izrādījās, ka “paredzamais akadēmiskais sniegums ir cieši saistītssaistīts ar eksāmena rezultātiem, "- saka Smirnovs. “Korelācijas koeficients ir no 0,49 līdz 0,6. Un attiecībā uz universitātēm, salīdzinot prognozētos akadēmiskos sasniegumus un USE rādītājus (informācija, kas pieejama pašreizējā pētījumā, Universitātes uzņemšanas kvalitātes uzraudzība), rezultāti arī parādīja ciešas attiecības. Korelācijas koeficients ir 0,83, kas ir ievērojami lielāks nekā vidusskolai, jo vairāk datu. "
Rezultāti
Smirnovs uzsvēra kopīgas teksta iezīmesziņas par to autoru progresu. Tika konstatēts, ka virsrakstu (-0,08), emocijzīmju (-0,06) un izsaukumu (-0,04) lietošana negatīvi korelē ar akadēmisko sniegumu. No otras puses, latīņu burtu lietošana, vidējais ziņojuma un vārda garums, vārdu krājuma lielums un lietotāju tekstu entropija ir pozitīvi korelēti ar akadēmisko sniegumu (attiecīgi no 0,07 līdz 0,16).
Ir arī apstiprināts, ka skolēniem ar dažādiem sasniegumu līmeņiem ir atšķirīgs vārdu krājums.
Studenti ar augstu sniegumu izmantoja:
- Angļu vārdi;
- Vārdi, kas saistīti ar literatūru (Bredberijs, Fārenheits, Orvels, Hakslijs, Folkners, Nabokovs, Brodskis, Kamiss, Manns);
- Jēdzienu lasīšana (lasīt, publicēt, grāmata, sējums);
- Termini un nosaukumi, kas saistīti ar fiziku (Visums, kvants, teorija, Einšteins, Ņūtons, Hokings);
- Vārdi, kas saistīti ar domāšanas procesiem (domāšana, iegaumēšana).
Studenti ar zemu punktu skaitu lietoja vārdus arkļūdas, populāru datorspēļu nosaukumi, jēdzieni, kas saistīti ar militāro dienestu (armija, zvērests utt.), horoskopa termini (Auns, Strēlnieks) un vārdi, kas saistīti ar braukšanu un autoavārijām (sadursme, ceļu policija, riteņi, tūnings).
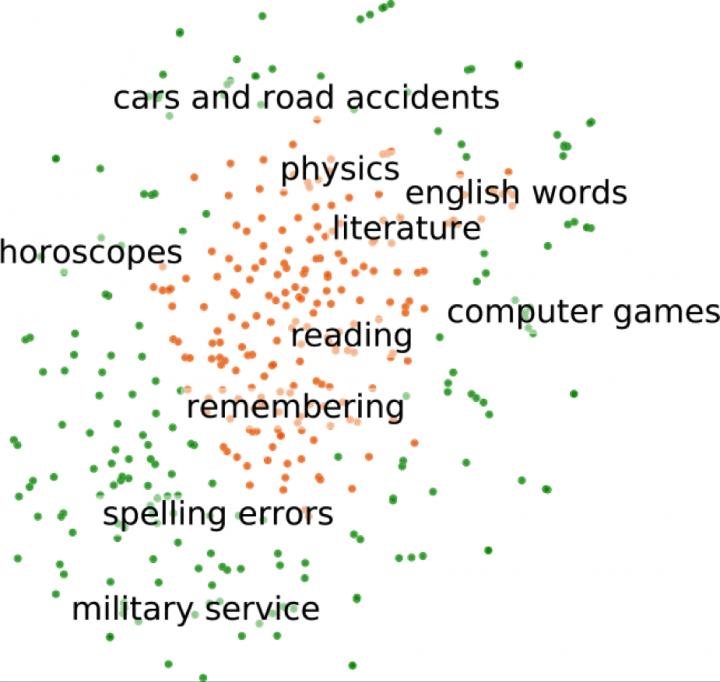 Tematiskās kopas: pārstāv visaugstākos un zemāk vērtētos vārdus no apmācību datu kopas
Smirnovs aprēķināja koeficientus visiem 2,5 miljvektora modeļa vārdus un nodrošināja tos tālākai izpētei. Interesanti, ka pat vārdi, kas apmācības datu kopā ir reti sastopami, var paredzēt akadēmisko sniegumu. Piemēram, pat ja vārds "Ņūts" (tāpat kā Harija Potera varonis Ņūts Skanders) nekad neparādās apmācības datos, modelis var piešķirt augstāku vērtējumu ziņojumiem, kas to satur. Tas notiks, ja modele uzzinās, ka vārdus no romānu sērijas lieto skolēni ar augstu sasniegumu līmeni, un, nekontrolēti mācoties, modelis "intuitīvi" saprot, ka nosaukums "Ņūts" ietilpst šajā kategorijā.
Lasīt arī
Ikgadējā misija Arktikā ir beigusies, un dati rada vilšanos. Kas gaida cilvēci?
Skatieties, kā jaunais Hummer pārvar šķēršļus uz ceļa, pārvietojoties kā krabis
Slimības 3. dienā lielākajai daļai COVID-19 pacientu zūd oža un bieži cieš no iesnas