Elk woord in de analyse heeft zijn eigen beoordeling. Bespreking van wetenschappelijke en culturele onderwerpen, gebruik van het Engels
De studie werd ondersteund door een subsidie van de Russian Science Foundation.
Smirnovs studie gebruikteen representatieve steekproef van gegevens uit de HSE longitudinale cohortpanelstudie “Educational and Career Trajectories” (TrEC). Het onderzoek volgt de loopbaanontwikkeling van 4.400 studenten uit 42 regio's van Rusland van universiteiten die deelnemen aan het PISA-programma (Program for International Student Assessment). De onderzoeksgegevens omvatten ook gegevens over de VK-accounts van studenten (3.483 studentendeelnemers stemden ermee in deze informatie te verstrekken).
“Omdat zulke data, in combinatie met digitalesporen zijn moeilijk te verkrijgen, ze worden bijna nooit gebruikt”, legt Smirnov uit. Ondertussen maakt zo'n dataset het mogelijk om een robuust model te ontwikkelen dat op andere parameters kan worden toegepast. En de resultaten kunnen worden geëxtrapoleerd naar alle andere middelbare scholieren en middelbare scholieren.
Als trainingsvoorbeeld gebruikten weberichten van openbare pagina's "VKontakte" - in totaal 130.575 berichten van 2.468 mensen die in 2012 de PISA-test hebben doorstaan. De test stelde de onderzoeker in staat om het academische vermogen van de student te beoordelen, evenals zijn vermogen om zijn kennis in de praktijk aan te tonen. De studie omvatte alleen openbaar beschikbare VKontakte-berichten van overeengekomen deelnemers.
Tijdens het onderzoek werd onbewaakt machinaal leren met vectorrepresentatie van woorden uitgevoerd in het postcorpus van VKontakte (in totaal 1,9 miljard woorden, met 2,5 miljoen unieke woorden).
“We hebben elk bericht gepresenteerd in de vorm van een 300-dimensionalevector door het gemiddelde te nemen van de vectorrepresentaties van al zijn samenstellende woorden, "legt Smirnov uit. "Deze postweergaven werden gebruikt om een lineair regressiemodel te trainen om de beoordelingen van de PISA-postauteurs te voorspellen."
Door "voorspelling" van de onderzoekerbetekent niet het voorspellen van de toekomst, maar een correlatie tussen de berekende resultaten en de werkelijke scores behaald door studenten op het PISA-examen, evenals hun Unified State Exam-resultaten (die in geaggregeerde vorm openbaar beschikbaar zijn op internet – d.w.z. deze zijn gemiddelde scores op school). In de voorbereidende fase leerde het model PISA-gegevens voorspellen. In het uiteindelijke model werden de berekeningen vergeleken met de Unified State Examination-resultaten van afgestudeerden en aanvragers van de middelbare school.
Het uiteindelijke model moest dat kunnenbetrouwbaar herkennen of een sterke of zwakke student een specifiek bericht op een sociaal netwerk heeft geschreven, of, met andere woorden, onderwerpen differentiëren in overeenstemming met hun academische prestaties. Na een periode van training was het model in staat om berichten van studenten met hoge of lage PISA-scores (niveaus 5-6 en niveaus 0-1) te onderscheiden met een nauwkeurigheid van 93,7%. Wat betreft de vergelijkbaarheid van PISA en USE, hoewel de twee tests verschillen, heeft onderzoek aangetoond dat de prestaties van studenten op deze twee tests sterk met elkaar gecorreleerd zijn.
Het bleek dat "voorspelde academische prestaties nauw"verband houden met de resultaten van het examen”, zegt Smirnov. “De correlatiecoëfficiënt ligt tussen 0,49 en 0,6. En in het geval van universiteiten, toen de verwachte academische prestaties en USE-aanvragersscores werden vergeleken (informatie beschikbaar in het huidige onderzoek, Monitoring the Quality of Admission to Higher Education Institutions), lieten de resultaten ook een sterke relatie zien. De correlatiecoëfficiënt is 0,83, wat significant hoger is dan voor de middelbare school, omdat meer gegevens."
Resultaten
Smirnov benadrukte veelvoorkomende tekstfunctiesberichten in relatie tot de voortgang van hun auteurs. Het gebruik van trefwoorden (-0.08), emoticons (-0.06) en uitroepen (-0.04) bleek negatief te correleren met academische prestaties. Aan de andere kant zijn het gebruik van Latijnse karakters, gemiddelde bericht- en woordlengte, woordenschatgrootte en entropie van gebruikersteksten positief gecorreleerd met academische prestaties (respectievelijk van 0,07 tot 0,16).
Er is ook bevestigd dat leerlingen met verschillende prestatieniveaus een verschillende woordenschat hebben.
Hoog presterende studenten gebruikt:
- Engelse woorden;
- Literaire woorden (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Lezingsconcepten (lezen, publiceren, boek, volume);
- Termen en namen gerelateerd aan fysica (Universum, kwantum, theorie, Einstein, Newton, Hawking);
- Woorden die verband houden met denkprocessen (denken, onthouden).
Leerlingen met lage scores gebruikten woorden metfouten, namen van populaire computerspellen, concepten met betrekking tot militaire dienst (leger, eed, enz.), horoscooptermen (Ram, Boogschutter) en woorden met betrekking tot auto- en auto-ongelukken (botsing, verkeerspolitie, wielen, afstemming).
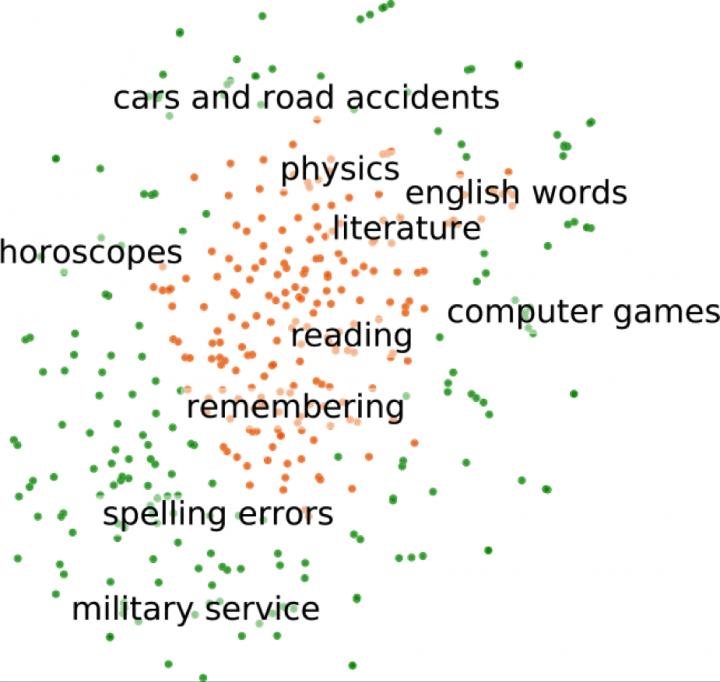 Thematische clusters: vertegenwoordigen de hoogst en laagst scorende woorden uit de trainingsdataset
Smirnov berekende de coëfficiënten voor alle 2,5 miljoenwoorden van het vectormodel en verstrekte deze voor verder onderzoek. Interessant is dat zelfs woorden die zeldzaam zijn in de trainingsdataset academische prestaties kunnen voorspellen. Zelfs als de naam 'Newt' (zoals in het Harry Potter-personage Newt Scamander) bijvoorbeeld nooit voorkomt in de trainingsgegevensset, kan het model een hogere beoordeling toekennen aan berichten die deze naam bevatten. Dit zal gebeuren als het model leert dat woorden uit de nieuwe reeks worden gebruikt door goed presterende studenten, en door leren zonder toezicht het model "intuïtief" begrijpt dat de naam "Newt" in deze categorie valt.
Lees ook
De jaarlijkse missie in het noordpoolgebied is afgelopen en de gegevens zijn teleurstellend. Wat staat de mensheid te wachten?
Kijk hoe de nieuwe Hummer obstakels op de weg overwint, bewegend als een krab
Op dag 3 van de ziekte verliezen de meeste COVID-19-patiënten hun reukvermogen en hebben ze vaak een loopneus