Hoewel de bronnen van vooringenomenheid in AI-systemen gevarieerd zijn, is stereotypering een van de belangrijkste oorzaken.
Om dit probleem bij haar op te lossenOorspronkelijk hebben onderzoekers van het Princeton Visual AI Lab een open source-tool ontwikkeld die automatisch mogelijke beschadigingen in visuele datasets detecteert. Met de tool kunnen makers en gebruikers van datasets ondervertegenwoordiging of stereotiepe beeldproblemen corrigeren voordat beeldcollecties worden gebruikt om computervisie-modellen te trainen. In aanverwant werk publiceerden leden van het Visual AI Lab een vergelijking van bestaande methoden voor het voorkomen van vooringenomenheid in computer vision-modellen zelf en stelden ze een nieuwe, effectievere benadering voor om vertekening te verminderen.
De eerste tool, genaamd REVISE, gebruiktstatistische methoden om een dataset te onderzoeken op mogelijke vooroordelen of problemen met ondervertegenwoordiging langs drie dimensies: object, geslacht en geografie.
REVISE evalueert de inhoud van de dataset,gebruikmakend van bestaande beeldannotaties en metingen zoals het aantal objecten, de gecombineerde aanwezigheid van objecten en mensen, en het land van herkomst van de beelden. Onder deze metingen identificeert de tool patronen die verschillen van de mediaanverdeling.
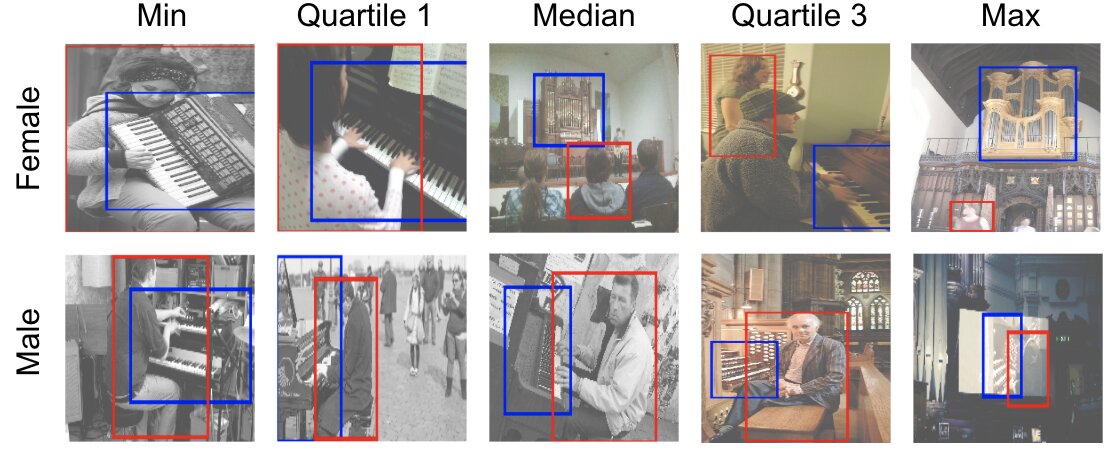 In één dataset identificeerde REVISE een potentieelgeslachtsbias in afbeeldingen van mensen (rode rechthoeken) en het orgel van een muziekinstrument (blauwe rechthoeken). Een analyse van de verdeling van de geschatte driedimensionale afstanden tussen een persoon en een orgel toonde aan dat mannen meestal werden afgebeeld terwijl ze het instrument bespeelden, terwijl vrouwen zich vaak gewoon in dezelfde ruimte als het instrument bevonden. Krediet: Princeton Visual AI Lab.
Bijvoorbeeld in een van de geteste setsUit REVISE-gegevens bleek dat afbeeldingen met mensen en bloemen verschilden tussen mannen en vrouwen: mannen verschenen vaker met bloemen bij ceremonies of bijeenkomsten, en vrouwen verschenen vaker in geënsceneerde decors of schilderijen.
Zodra de tool dit soort detecteertdiscrepanties, “de vraag rijst of dit een volkomen onschuldig feit is of dat er iets belangrijkers aan de hand is, en dit is heel moeilijk te automatiseren”, legt Olga Rusakovskaya uit, universitair docent computerwetenschappen en hoofdonderzoeker van het Visual AI Lab.
“De praktijk van het verzamelen van datasets op de computerwetenschappen werden tot voor kort niet zo grondig bestudeerd ”, concludeert co-auteur Angelina Wang, een afgestudeerde student informatica. Ze legt uit dat de afbeeldingen meestal “van internet komen, en mensen begrijpen niet altijd dat hun afbeeldingen worden gebruikt [in datasets]. We moeten afbeeldingen verzamelen van meer diverse groepen mensen en dat respectvol doen. "
Lees ook:
Het is mogelijk om op aarde een thermonucleaire reactor te maken. Wat zijn de gevolgen?
De Doomsday-gletsjer bleek gevaarlijker te zijn dan wetenschappers dachten. We vertellen het belangrijkste
Op dag 3 van de ziekte verliezen de meeste COVID-19-patiënten hun reukvermogen en hebben ze vaak een loopneus