Hvert ord i analysen har sin egen vurdering. Diskusjon av vitenskapelige og kulturelle emner, bruk av engelsk
Studien ble støttet av et tilskudd fra Russian Science Foundation.
Smirnovs studie bruktet representativt utvalg av data fra HMS longitudinelle kohortpanelstudie «Educational and Career Trajectories» (TrEC). Studien sporer karriereutviklingen til 4400 studenter fra 42 regioner i Russland fra universiteter som deltar i PISA-programmet (Program for International Student Assessment). Studiedataene inkluderte også data om studentenes VK-kontoer (3 483 studentdeltakere gikk med på å gi denne informasjonen).
“Siden slike data, kombinert med digitalspor er vanskelige å få tak i, de blir nesten aldri brukt, ”forklarer Smirnov. I mellomtiden tillater et slikt datasett en robust modell som kan brukes på andre parametere. Og resultatene kan ekstrapoleres til alle andre studenter - videregående og videregående studenter.
Som et treningseksempel brukte vimeldinger fra offentlige VKontakte-sider - totalt 130 575 meldinger fra 2468 personer som besto PISA-testen i 2012. Testen tillot forskeren å vurdere studentens faglige evne, samt hans evne til å demonstrere sin kunnskap i praksis. Studien inkluderte bare offentlig tilgjengelige VKontakte-meldinger fra avtalte deltakere.
I løpet av studien ble det utført uovervåket maskinlæring med vektorrepresentasjon av ord i VKontakte post-corpus (1,9 milliarder ord totalt, med 2,5 millioner unike ord).
“Vi har presentert hvert innlegg som et 300-dimensjonaltvektor ved å ta en gjennomsnitt av vektorrepresentasjonene av alle ordene, ”forklarer Smirnov. "Disse innleggssiktene ble brukt til å trene en lineær regresjonsmodell for å forutsi rangeringene til PISA-forfatterne."
Ved "prediksjon" forskerenbetyr ikke å forutsi fremtiden, men en korrelasjon mellom de beregnede resultatene og de faktiske poengsummene oppnådd av studentene på PISA-eksamenen, så vel som deres Unified State Examination-resultater (som er offentlig tilgjengelig på Internett i aggregert form – dvs. disse er gjennomsnittlig poengsum på skolen). På det innledende stadiet lærte modellen å forutsi PISA-data. I den endelige modellen ble beregningene sammenlignet med Unified State Examination-resultatene til nyutdannede på videregående skole og søkere.
Den endelige modellen skulle kunnepålitelig gjenkjenne om en sterk eller svak student skrev et bestemt innlegg på et sosialt nettverk, eller med andre ord, differensiere fag i henhold til deres akademiske prestasjoner. Etter en periode med opplæring kunne modellen skille meldinger skrevet av studenter med høy eller lav PISA-score (nivå 5-6 og nivå 0-1) med en nøyaktighet på 93,7%. Når det gjelder sammenlignbarheten mellom PISA og USE, selv om de to testene er forskjellige, har forskning vist at studentprestasjoner på de to testene sterkt korrelerer med hverandre.
Det viste seg at ”spådd akademisk ytelse er tettknyttet til resultatene av eksamen, "- sier Smirnov. “Korrelasjonskoeffisienten er mellom 0,49 og 0,6. Og når det gjelder universiteter, når den anslåtte akademiske ytelsen og USE-poengsummen ble sammenlignet (informasjon tilgjengelig i den aktuelle studien, Monitoring the quality of university admmissions), viste resultatene også et sterkt forhold. Korrelasjonskoeffisienten er 0,83, som er betydelig høyere enn for videregående skole, fordi mer data. "
Resultater
Smirnov markerte vanlige tekstfunksjonerinnlegg i forhold til fremdriften til forfatterne. Bruk av hovedord (-0.08), uttrykksikoner (-0.06) og utrop (-0.04) ble funnet å være negativt korrelert med akademisk ytelse. På den annen side er bruken av latinske tegn, den gjennomsnittlige meldingen og ordlengden, vokabularstørrelsen og entropien til brukertekster positivt korrelert med akademisk ytelse (fra henholdsvis 0,07 til 0,16).
Det er også bekreftet at elever med ulike prestasjonsnivåer har ulikt ordforråd.
Studenter med høy ytelse brukte:
- Engelske ord;
- Ord relatert til litteratur (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Lesekonsepter (lese, publisere, bok, bind);
- Begreper og navn relatert til fysikk (Univers, kvante, teori, Einstein, Newton, Hawking);
- Ord relatert til tankeprosesser (tenkning, memorisering).
Studenter med lave poeng brukte ord medfeil, navn på populære dataspill, begreper relatert til militærtjeneste (hær, ed, etc.), horoskoputtrykk (Væren, Skytten) og ord relatert til kjøring og bilulykker (kollisjon, trafikkpoliti, hjul, tuning).
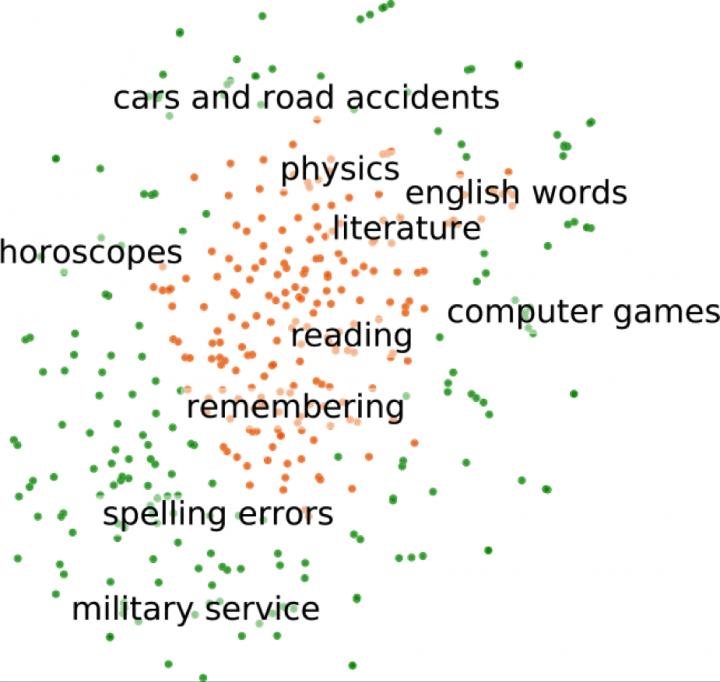 Temaklynger: Representerer de høyeste og laveste poengordene fra treningsdatasettet
Smirnov regnet ut koeffisientene for alle 2,5 millionerord fra vektormodellen og ga dem for videre studier. Interessant nok kan selv ord som er sjeldne i treningsdatasettet forutsi akademisk ytelse. For eksempel, selv om navnet "Newt" (som Harry Potter-karakteren Newt Scamander) aldri vises i treningsdataene, kan modellen gi en høyere vurdering til meldinger som inneholder det. Dette vil skje dersom modellen lærer at ord fra romanserien brukes av høyt presterende elever, og gjennom uovervåket læring forstår modellen «intuitivt» at navnet «Newt» faller inn i denne kategorien.
Les også
Det årlige oppdraget i Arktis er avsluttet, og dataene er skuffende. Hva venter menneskeheten?
Se den nye Hummer overvinne hindringer på veien, bevege seg som en krabbe
På sykdomsdag 3 mister de fleste COVID-19 pasienter luktesansen og lider ofte av en rennende nese