Każde słowo w analizie ma swoją własną ocenę.
Badanie zostało sfinansowane z grantu Rosyjskiej Fundacji Nauki.
Wykorzystano badanie Smirnowareprezentatywna próbka danych z podłużnego badania panelowego kohortowego HSE „Trajektorie edukacyjne i zawodowe” (TrEC). Badanie śledzi rozwój kariery 4400 studentów z 42 regionów Rosji z uczelni uczestniczących w programie PISA (Program for International Student Assessment). Dane do badania obejmowały także dane dotyczące kont VK studentów (3483 studentów zgodziło się na udostępnienie tych informacji).
„Ponieważ takie dane w połączeniu z cyfrowymiślady są trudne do zdobycia, prawie nigdy nie są używane ”, wyjaśnia Smirnov. Tymczasem taki zbiór danych umożliwia opracowanie solidnego modelu, który można zastosować do innych parametrów. Wyniki można ekstrapolować na wszystkich innych uczniów - uczniów szkół średnich i liceów.
Jako próbkę szkoleniową użyliśmywiadomości z publicznych stron „VKontakte” - łącznie 130 575 wiadomości od 2468 osób, które przeszły test PISA w 2012 roku. Test pozwolił badaczowi ocenić zdolności akademickie studenta, a także jego umiejętność wykazania się wiedzą w praktyce. Badanie obejmowało tylko publicznie dostępne wiadomości VKontakte od uzgodnionych uczestników.
Podczas badania w postkorpusie VKontakte przeprowadzono nienadzorowane uczenie maszynowe z wektorową reprezentacją słów (w sumie 1,9 miliarda słów, w tym 2,5 miliona unikalnych słów).
„Przedstawiliśmy każdy post jako 300-wymiarowywektory poprzez uśrednienie reprezentacji wektorów wszystkich słów składowych ”- wyjaśnia Smirnov. „Te widoki postu zostały wykorzystane do trenowania modelu regresji liniowej do przewidywania ocen autorów postu PISA”.
Przez „przewidywanie” badaczanie oznacza przewidywania przyszłości, ale korelację pomiędzy wyliczonymi wynikami a rzeczywistymi wynikami uzyskanymi przez uczniów na egzaminie PISA oraz wynikami ich egzaminu Unified State Examination (które są publicznie dostępne w Internecie w formie zagregowanej – tj. średnie wyniki w szkole). Model na etapie wstępnym nauczył się przewidywać dane PISA. W ostatecznym modelu obliczenia porównano z wynikami Unified State Examination absolwentów i kandydatów do szkół średnich.
Ostateczny model miał być w stanierzetelnie rozpoznać, czy silny lub słaby uczeń napisał określony post w sieci społecznościowej, lub innymi słowy, rozróżniać przedmioty na podstawie ich wyników w nauce. Po okresie szkolenia model był w stanie rozróżnić komunikaty napisane przez uczniów z wysokimi lub niskimi wynikami PISA (poziomy 5-6 i poziomy 0-1) z dokładnością 93,7%. Jeśli chodzi o porównywalność PISA i USE, chociaż te dwa testy różnią się, badania wykazały, że wyniki uczniów w tych dwóch testach są ze sobą silnie skorelowane.
Okazało się, że „przewidywane wyniki w nauce są bardzo zbliżonezwiązane z wynikami egzaminu ”- mówi Smirnov. „Współczynnik korelacji wynosi od 0,49 do 0,6. W przypadku uniwersytetów, gdy porównano przewidywane wyniki w nauce i wyniki kandydatów USE (informacje dostępne w bieżącym badaniu Monitorowanie jakości przyjęć na uniwersytety), wyniki również wykazały silny związek. Współczynnik korelacji wynosi 0,83, czyli jest znacznie wyższy niż w przypadku liceum, bo więcej danych ”.
Wyniki
Smirnov podkreślił typowe cechy tekstupostów w stosunku do postępów ich autorów. Stwierdzono, że użycie haseł (-0,08), emotikonów (-0,06) i wykrzykników (-0,04) negatywnie koreluje z wynikami w nauce. Z drugiej strony, użycie znaków łacińskich, średnia długość komunikatu i słowa, wielkość słownictwa i entropia tekstów użytkownika są dodatnio skorelowane z wynikami w nauce (odpowiednio od 0,07 do 0,16).
Potwierdzono również, że uczniowie o różnym poziomie osiągnięć posługują się innym słownictwem.
Uczniowie osiągający dobre wyniki wykorzystali:
- Angielskie słowa;
- Słowa związane z literaturą (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Pojęcia dotyczące czytania (przeczytaj, opublikuj, książka, tom);
- Terminy i nazwy związane z fizyką (Wszechświat, kwant, teoria, Einstein, Newton, Hawking);
- Słowa związane z procesami myślowymi (myślenie, zapamiętywanie).
Uczniowie z niskimi wynikami używali słów zbłędy, nazwy popularnych gier komputerowych, pojęcia związane ze służbą wojskową (wojsko, przysięga itp.), określenia horoskopowe (Baran, Strzelec) oraz słowa związane z jazdą i wypadkami samochodowymi (kolizja, policja drogowa, koła, tuning).
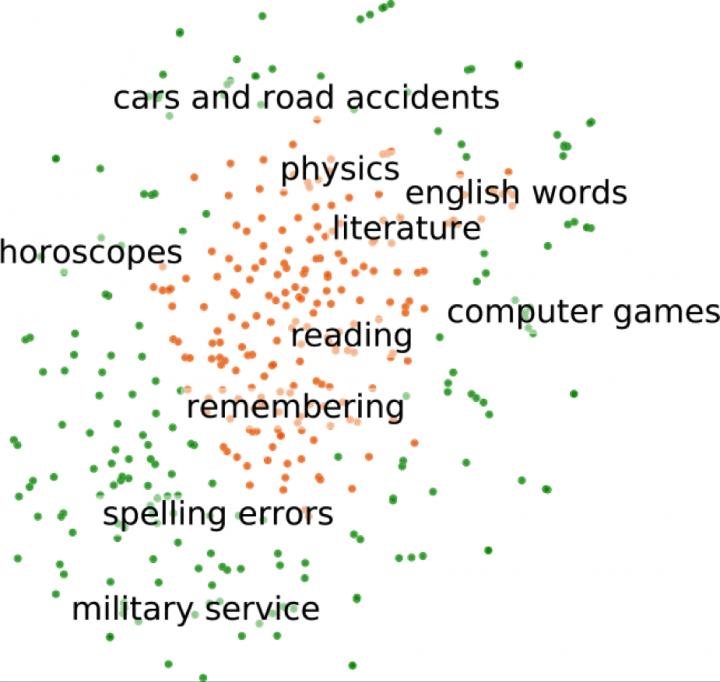 Klastry tematyczne: reprezentujące słowa o najwyższej i najniższej punktacji ze zbioru danych szkoleniowych
Smirnow obliczył współczynniki dla wszystkich 2,5 milionasłowa modelu wektorowego i dostarczył je do dalszych badań. Co ciekawe, nawet słowa, które są rzadkie w zbiorze danych uczących, mogą przewidzieć wyniki w nauce. Na przykład, nawet jeśli imię „Newt” (jak postać z Harry'ego Pottera Newt Scamander) nigdy nie pojawia się w danych uczących, model może przypisać wyższą ocenę wiadomościom, które je zawierają. Stanie się tak, jeśli model dowie się, że słowa z serii powieści są używane przez uczniów osiągających wysokie wyniki, a poprzez naukę bez nadzoru model „intuicyjnie” zrozumie, że imię „Newt” należy do tej kategorii.
Czytaj także
Coroczna misja w Arktyce dobiegła końca, a dane są rozczarowujące. Co czeka ludzkość?
Zobacz, jak nowy Hummer pokonuje przeszkody na drodze, poruszając się jak krab
W 3. dniu choroby większość pacjentów z COVID-19 traci zmysł węchu i często cierpi na katar