Chociaż źródła uprzedzeń w systemach sztucznej inteligencji są zróżnicowane, jedną z głównych przyczyn są stereotypy.
Aby pomóc jej rozwiązać ten problemPierwotnie naukowcy z Princeton Visual AI Lab opracowali narzędzie typu open source, które automatycznie wykrywa potencjalne uszkodzenia w wizualnych zestawach danych. Narzędzie umożliwia twórcom zbiorów danych i użytkownikom korygowanie niedostatecznej reprezentacji lub stereotypowych problemów związanych z obrazowaniem, zanim zbiory obrazów zostaną wykorzystane do trenowania modeli widzenia komputerowego. W powiązanych pracach członkowie Visual AI Lab opublikowali porównanie istniejących technik zapobiegania uprzedzeniom w samych modelach widzenia komputerowego i zaproponowali nowe, skuteczniejsze podejście do redukcji uprzedzeń.
Pierwsze narzędzie o nazwie REVISE wykorzystujemetody statystyczne służące do badania zbioru danych pod kątem potencjalnych błędów stronniczości lub niedostatecznej reprezentacji w trzech wymiarach: przedmiot, płeć i położenie geograficzne.
REVISE ocenia zawartość zbioru danych,wykorzystanie istniejących adnotacji i pomiarów obrazu, takich jak liczba obiektów, łączna obecność obiektów i osób oraz kraj pochodzenia obrazów. Wśród tych pomiarów narzędzie identyfikuje wzorce różniące się od rozkładu mediany.
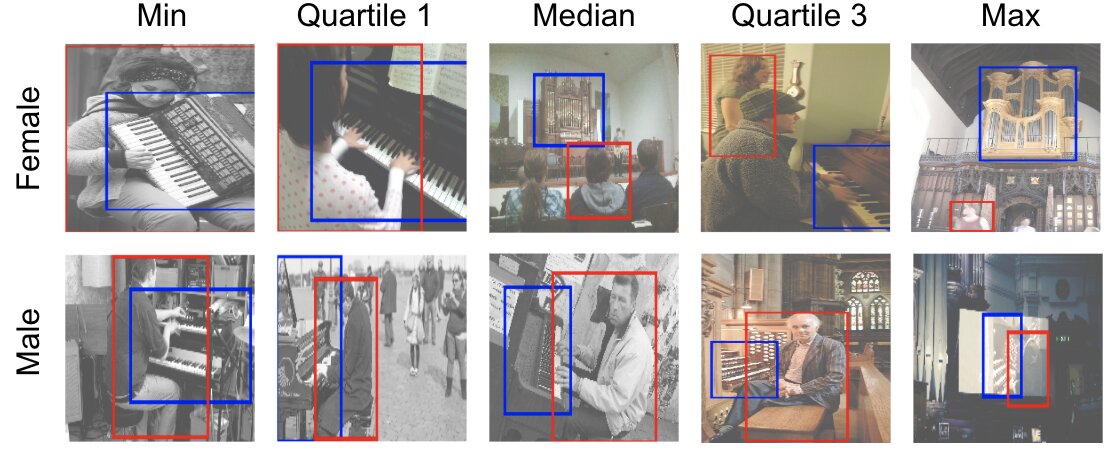 W jednym zbiorze danych REVISE zidentyfikował potencjałuprzedzenia ze względu na płeć na zdjęciach przedstawiających ludzi (czerwone prostokąty) i organy instrumentu muzycznego (niebieskie prostokąty). Analiza rozkładu szacowanych odległości trójwymiarowych między osobą a organem wykazała, że mężczyźni byli zwykle przedstawiani jako faktycznie grający na instrumencie, podczas gdy kobiety często znajdowały się po prostu w tej samej przestrzeni co instrument. Źródło: Princeton Visual AI Lab.
Na przykład w jednym z testowanych zestawówDane REVISE wykazały, że obrazy przedstawiające ludzi i kwiaty różnią się w przypadku mężczyzn i kobiet: mężczyźni częściej pojawiali się z kwiatami podczas ceremonii lub spotkań, a kobiety częściej pojawiały się w scenerii lub na obrazach.
Gdy narzędzie wykryje tego rodzajurozbieżnościach „pojawia się pytanie, czy jest to fakt zupełnie nieszkodliwy, czy też dzieje się coś ważniejszego, a bardzo trudno to zautomatyzować” – wyjaśnia Olga Rusakowska, adiunkt informatyki i główny badacz Laboratorium Visual AI.
„Praktyka gromadzenia zbiorów danych w komputerzedo niedawna nauka nie była tak dokładnie badana ”- podsumowuje współautorka badań Angelina Wang, absolwentka informatyki. Wyjaśnia, że obrazy pochodzą głównie „z Internetu, a ludzie nie zawsze rozumieją, że ich obrazy są wykorzystywane [w zbiorach danych]. Musimy zbierać obrazy od bardziej zróżnicowanych grup ludzi i robić to z szacunkiem ”.
Czytaj także:
Możliwe jest stworzenie reaktora termojądrowego na Ziemi. Jakie będą konsekwencje?
Lodowiec Doomsday okazał się bardziej niebezpieczny, niż sądzili naukowcy. Mówimy najważniejsze
W 3. dniu choroby większość pacjentów z COVID-19 traci zmysł węchu i często cierpi na katar