Každé slovo v analýze má svoje vlastné hodnotenie. Diskusia na vedecké a kultúrne témy, používanie angličtiny
Štúdia bola podporená grantom Ruskej vedeckej nadácie.
Použitá Smirnovova štúdiareprezentatívna vzorka údajov z longitudinálnej kohortovej panelovej štúdie HSE „Educational and Career Trajectories“ (TrEC). Štúdia sleduje kariérny rozvoj 4 400 študentov zo 42 regiónov Ruska z univerzít zapojených do programu PISA (Program pre medzinárodné hodnotenie študentov). Údaje o štúdiu obsahovali aj údaje o účtoch študentov VK (3 483 účastníkov študentov súhlasilo s poskytnutím týchto informácií).
„Od týchto údajov v kombinácii s digitálnymistopy sa dajú len ťažko získať, takmer nikdy sa nepoužívajú, “vysvetľuje Smirnov. Medzitým takýto súbor údajov umožňuje vývoj robustného modelu, ktorý je možné použiť na ďalšie parametre. A výsledky je možné extrapolovať na všetkých ostatných študentov - stredoškolákov a študentov stredných škôl.
Ako tréningovú vzorku sme použilisprávy z verejných stránok VKontakte - spolu 130 575 správ od 2 468 ľudí, ktorí v roku 2012 prešli testom PISA. Test umožnil výskumníkovi posúdiť akademické schopnosti študenta, ako aj jeho schopnosť preukázať svoje vedomosti v praxi. Štúdia zahŕňala iba verejne dostupné správy VKontakte od dohodnutých účastníkov.
Počas štúdie sa v post-korpuse VKontakte vykonalo strojové učenie bez dozoru s vektorovou reprezentáciou slov (celkovo 1,9 miliardy slov s 2,5 miliónmi jedinečných slov).
„Každý príspevok sme prezentovali ako 300-rozmernývektory spriemerovaním vektorových reprezentácií všetkých jeho základných slov, “vysvetľuje Smirnov. „Tieto zobrazenia príspevku boli použité na trénovanie lineárneho regresného modelu na predpovedanie hodnotení autorov príspevku PISA.“
„Predpovedaním“ výskumníkaneznamená predpovedanie budúcnosti, ale koreláciu medzi vypočítanými výsledkami a skutočným skóre dosiahnutým študentmi na skúške PISA, ako aj ich výsledkami Jednotnej štátnej skúšky (ktoré sú verejne dostupné na internete v agregovanej forme – t.j. priemerné výsledky v škole). V prípravnej fáze sa model naučil predpovedať údaje PISA. Vo výslednom modeli boli výpočty porovnané s výsledkami Jednotnej štátnej skúšky maturantov a uchádzačov o štúdium.
Finálny model mal byť schopnýspoľahlivo rozpoznať, či silný alebo slabý študent napísal konkrétny príspevok na sociálnu sieť, alebo inak povedané, odlíšiť predmety podľa svojich akademických výsledkov. Po období školenia bol model schopný rozlíšiť správy napísané študentmi s vysokým alebo nízkym skóre PISA (úrovne 5-6 a úrovne 0-1) s presnosťou 93,7%. Pokiaľ ide o porovnateľnosť PISA a USE, aj keď sa tieto dva testy líšia, výskum ukázal, že výkon študentov v týchto dvoch testoch navzájom veľmi korelujú.
Ukázalo sa, že „predpovedaný akademický výkon je blízkyspojené s výsledkami skúšky, “- hovorí Smirnov. „Korelačný koeficient je medzi 0,49 a 0,6. A v prípade vysokých škôl, keď sa porovnávali predpovedané študijné výsledky a skóre USE (informácie dostupné v aktuálnej štúdii, Monitorovanie kvality prijímacích skúšok na univerzitu), výsledky tiež preukázali silný vzťah. Korelačný koeficient je 0,83, čo je podstatne viac ako pre strednú školu, pretože viac údajov. “
Výsledky
Smirnov vyzdvihol bežné textové vlastnostipríspevkov vo vzťahu k pokroku ich autorov. Zistilo sa, že používanie hesiel (-0,08), emotikonov (-0,06) a výkričníkov (-0,04) negatívne koreluje s akademickým výkonom. Na druhej strane používanie latinských znakov, priemerná dĺžka správy a slova, veľkosť slovníka a entropia používateľských textov pozitívne korelujú s akademickými výsledkami (od 0,07 do 0,16).
Potvrdilo sa tiež, že žiaci s rôznou úrovňou prospechu majú rôznu slovnú zásobu.
Vysoko výkonní študenti použili:
- Anglické slová;
- Literárne slová (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Koncepty čítania (čítanie, publikovanie, kniha, zväzok);
- Pojmy a názvy súvisiace s fyzikou (vesmír, kvantum, teória, Einstein, Newton, Hawking);
- Slová súvisiace s myšlienkovými pochodmi (myslenie, memorovanie).
Študenti s nízkym skóre používali slová schyby, názvy populárnych počítačových hier, pojmy súvisiace s vojenskou službou (armáda, prísaha atď.), pojmy horoskopu (Baran, Strelec) a slová súvisiace s nehodami pri šoférovaní a autách (kolízia, dopravná polícia, kolesá, tuning).
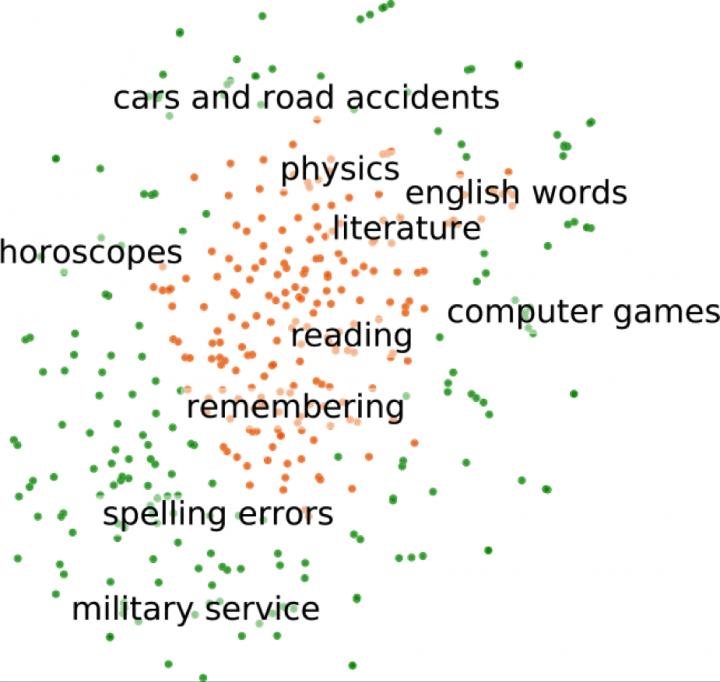 Tematické klastre: Predstavujú slová s najvyšším a najnižším skóre zo súboru školení
Smirnov vypočítal koeficienty pre všetkých 2,5 miliónaslová vektorového modelu a poskytli ich na ďalšie štúdium. Je zaujímavé, že aj slová, ktoré sú v súbore tréningových údajov zriedkavé, môžu predpovedať akademický výkon. Napríklad, aj keď sa meno „Newt“ (ako postava z Harryho Pottera Newt Scamander) nikdy neobjaví v tréningových údajoch, model môže priradiť vyššie hodnotenie správam, ktoré ho obsahujú. Stane sa tak, ak sa modelka dozvie, že slová z románovej série používajú študenti, ktorí dosahujú dobré výsledky, a prostredníctvom učenia bez dozoru modelka „intuitívne“ pochopí, že do tejto kategórie patrí aj názov „Mlook“.
Prečítajte si tiež
Každoročná misia v Arktíde sa skončila a údaje sú sklamaním. Čo čaká ľudstvo?
Sledujte, ako nový Hummer prekonáva prekážky na ceste a pohybuje sa ako rak
V deň 3 choroby väčšina pacientov COVID-19 stratí čuch a často trpí nádchou.