Свака реч у анализи има своју оцену. Дискусија о научним и културним темама, употреба енглеског језика
Студија је подржана грантом Руске научне фондације.
Смирновова студија користиларепрезентативни узорак података из ХСЕ лонгитудиналне кохортне панел студије „Трајекторије образовања и каријере“ (ТрЕЦ). Студија прати развој каријере 4.400 ученика из 42 региона Русије са универзитета који учествују у програму ПИСА (Програм за међународно оцењивање ученика). Подаци студије су такође укључивали податке о ВК налозима студената (3.483 студента су пристала да дају ове информације).
„Од таквих података, у комбинацији са дигиталнимдо трагова је тешко доћи, они се готово никада не користе “, објашњава Смирнов. У међувремену, такав скуп података омогућава развој робусног модела који се може применити на друге параметре. А резултати се могу екстраполирати на све остале средњошколце и средњошколце.
Као узорак за обуку смо користилипоруке са јавних страница „ВКонтакте“ - укупно 130.575 порука од 2.468 људи који су положили ПИСА тест 2012. године. Тест је омогућио истраживачу да процени академске способности ученика, као и његову способност да покаже своје знање у пракси. Студија је обухватала само јавно доступне поруке ВКонтакте од договорених учесника.
Током студије, у пост-корпусу ВКонтактеа спроведено је машинско учење без надзора са векторском представом речи (укупно 1,9 милијарди речи, са 2,5 милиона јединствених речи).&нбсп;
„Представили смо сваки пост у облику 300-димензијевектор усредњавањем векторских приказа свих његових саставних речи “, објашњава Смирнов. „Ови прикази приказа коришћени су за обуку модела линеарне регресије за предвиђање рејтинга аутора ПИСА поста.“
По „предвиђању” истраживачане значи предвиђање будућности, већ корелацију између израчунатих резултата и стварних резултата које су ученици добили на ПИСА испиту, као и њихових резултата Јединственог државног испита (који су јавно доступни на Интернету у збирном облику – тј. просечни резултати у школи). У прелиминарној фази, модел је научио да предвиди ПИСА податке. У коначном моделу, прорачуни су упоређени са резултатима Јединственог државног испита матураната и кандидата.
Коначни модел је требало да можепоуздано препознати да ли је јак или слаб студент написао одређени пост на друштвеној мрежи или, другим речима, разликује предмете у складу са својим академским учинком. Након периода обуке, модел је могао да разликује поруке ученика које су написали високи или ниски ПИСА резултати (нивои 5-6 и нивои 0-1) са тачношћу од 93,7%. Што се тиче упоредивости ПИСА и УСЕ, иако се два теста разликују, истраживања су показала да су перформансе ученика на ова два теста у великој корелацији.
Испоставило се да су „предвиђени академски успеси блискиповезано са резултатима испита “, каже Смирнов. „Коефицијент корелације је између 0,49 и 0,6. А у случају универзитета, када су упоређивани предвиђени академски успех и резултати пријављених на УСЕ (подаци доступни у тренутној студији, Праћење квалитета уписа на универзитете), резултати су такође показали снажну везу. Коефицијент корелације је 0,83, што је знатно више него за средњу школу, јер више података “.
Резултати
Смирнов је истакао уобичајене карактеристике текстаобјаве у односу на напредак њихових аутора. Утврђено је да употреба главних речи (-0,08), емотикона (-0,06) и узвика (-0,04) негативно корелира са академским учинком. С друге стране, употреба латиничних знакова, просечна дужина поруке и речи, величина речника и ентропија корисничких текстова позитивно су повезани са академским учинком (од 0,07 до 0,16, респективно).
Такође је потврђено да ученици са различитим нивоима постигнућа имају различит речник.&нбсп;
Студенти са високим перформансама су користили:
- Енглеске речи;
- Књижевне речи (Брадбури, Фахренхеит, Орвелл, Хуклеи, Фаулкнер, Набоков, Бродски, Цамус, Манн);
- Појмови читања (читање, објављивање, књига, том);
- Термини и називи повезани са физиком (Универзум, квант, теорија, Ајнштајн, Њутн, Хокинг);
- Речи повезане са мисаоним процесима (размишљање, памћење).
Ученици са ниским оценама користили су речи сагрешке, називи популарних рачунарских игара, концепти који се односе на служење војног рока (војска, заклетва итд.), изрази у хороскопу (Ован, Стрелац) и речи повезане са вожњом и аутомобилским несрећама (судар, саобраћајна полиција, точкови, подешавање).
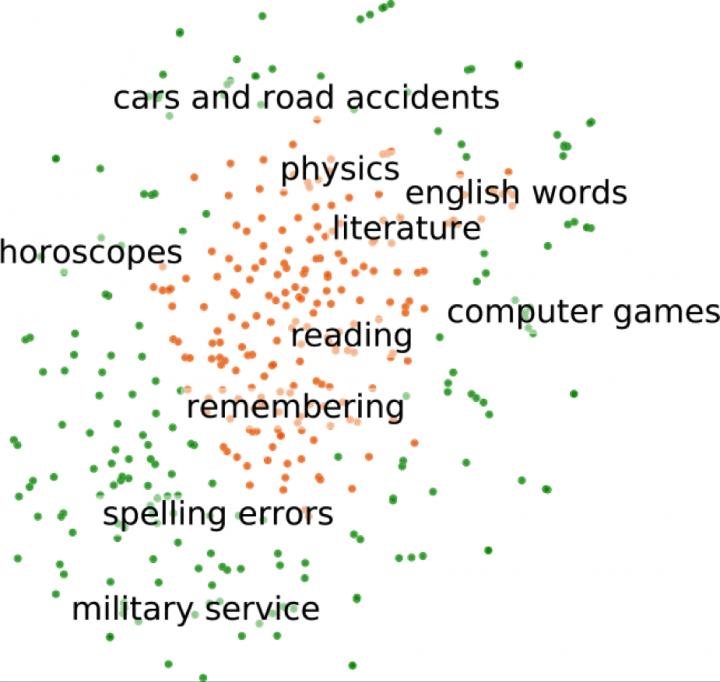 Тематски кластери: Представљање речи са највишим и најнижим бодовима из скупа података о обуци
Смирнов је израчунао коефицијенте за свих 2,5 милионаречи векторског модела и обезбедио их за даље проучавање. Занимљиво је да чак и речи које су ретке у скупу података за обуку могу предвидети академски учинак. На пример, чак и ако се име „Њут“ (као што је лик Хари Потера Њут Скамандер) никада не појави у подацима о обуци, модел може да додели вишу оцену порукама које га садрже. То ће се десити ако модел научи да речи из серије романа користе ученици са високим успехом, а кроз учење без надзора модел „интуитивно“ схвати да назив „Њут“ спада у ову категорију.
Прочитајте такође
Годишња мисија на Арктику је завршена и подаци су разочаравајући. Шта чека човечанство?
Гледајте како нови Хуммер савладава препреке на путу, крећући се попут раке
Трећег дана болести, већина пацијената са ЦОВИД-19 губи смрад и често пате од цурења из носа