Каждое слово в анализе имеет свой рейтинг. Обсуждение научных и культурных тем, использование английских
การศึกษาได้รับการสนับสนุนโดยทุนจากมูลนิธิวิทยาศาสตร์รัสเซีย
В исследовании Смирнова использовалась репрезентативная выборка данных лонгитюдного когортного панельного исследования НИУ ВШЭ «Образовательные и карьерные траектории» (TrEC). В исследовании прослеживается карьерный рост 4400 студентов из 42 регионов России из вузов, участвующих в программе PISA (Программа оценки иностранных студентов). Данные исследования также включают данные об учетных записях студентов в ВК (3483 студента-участника согласились предоставить эту информацию).
“ เนื่องจากข้อมูลดังกล่าวรวมกับดิจิทัลร่องรอยนั้นยากที่จะได้รับพวกมันแทบจะไม่เคยถูกใช้เลย” สเมียร์นอฟอธิบาย ในขณะเดียวกันชุดข้อมูลดังกล่าวช่วยให้สามารถพัฒนาโมเดลที่มีประสิทธิภาพซึ่งสามารถนำไปใช้กับพารามิเตอร์อื่น ๆ ได้ และผลที่ได้สามารถประเมินได้สำหรับนักเรียนคนอื่น ๆ ทั้งหมดไม่ว่าจะเป็นนักเรียนมัธยมและนักเรียนมัธยมปลาย
เป็นตัวอย่างการฝึกอบรมเราใช้ข้อความจากหน้า VKontakte สาธารณะ - ทั้งหมด 130,575 ข้อความจาก 2,468 คนที่ผ่านการทดสอบ PISA ในปี 2012 การทดสอบช่วยให้ผู้วิจัยสามารถประเมินความสามารถทางวิชาการของนักเรียนตลอดจนความสามารถในการแสดงความรู้ในทางปฏิบัติ การศึกษานี้รวมเฉพาะข้อความ VKontakte ที่เปิดเผยต่อสาธารณะจากผู้เข้าร่วมที่ตกลงกัน
В ходе исследования неконтролируемое машинное обучение с векторным представлением слов было выполнено в пост-корпусе «ВКонтакте» (всего 1,9 миллиарда слов, с 2,5 миллионами уникальных слов).
“ เราได้นำเสนอแต่ละโพสต์เป็น 300 มิติเวกเตอร์โดยการหาค่าเฉลี่ยการแสดงเวกเตอร์ของคำที่เป็นส่วนประกอบทั้งหมด” สเมียร์นอฟอธิบาย "การดูโพสต์เหล่านี้ใช้ในการฝึกโมเดลการถดถอยเชิงเส้นเพื่อทำนายการให้คะแนนของผู้เขียนโพสต์ PISA"
Под «прогнозированием» исследователь подразумевает не прогнозирование будущего, а корреляцию между рассчитанными результатами и реальными баллами, полученными учащимися на экзамене PISA, а также их результатами ЕГЭ (которые общедоступны в Интернете в агрегированной форме — т.е. это средние баллы по школе). На предварительном этапе модель научилась предсказывать данные PISA. В итоговой модели расчеты сверялись с результатами ЕГЭ выпускников средних школ и абитуриентов.
โมเดลสุดท้ายควรจะทำได้รับรู้ได้อย่างน่าเชื่อถือว่านักเรียนที่แข็งแกร่งหรืออ่อนแอเขียนโพสต์เฉพาะบนโซเชียลเน็ตเวิร์กหรือกล่าวอีกนัยหนึ่งก็คือแยกความแตกต่างของวิชาให้สอดคล้องกับผลการเรียนของพวกเขา หลังจากการฝึกอบรมระยะหนึ่งแบบจำลองสามารถแยกแยะข้อความที่เขียนโดยนักเรียนที่มีคะแนน PISA สูงหรือต่ำ (ระดับ 5-6 และระดับ 0-1) ด้วยความแม่นยำ 93.7% เกี่ยวกับการเปรียบเทียบความสามารถของ PISA และ USE แม้ว่าการทดสอบทั้งสองจะแตกต่างกัน แต่การวิจัยพบว่าประสิทธิภาพของนักเรียนในการทดสอบทั้งสองมีความสัมพันธ์กันอย่างมาก
ปรากฎว่า "ผลการเรียนที่คาดการณ์ไว้เป็นไปอย่างใกล้ชิดเกี่ยวข้องกับผลการสอบ "- สเมียร์นอฟกล่าว “ ค่าสัมประสิทธิ์สหสัมพันธ์อยู่ระหว่าง 0.49 ถึง 0.6 และในกรณีของมหาวิทยาลัยเมื่อเปรียบเทียบผลการเรียนที่คาดการณ์ไว้และคะแนน USE (ข้อมูลที่มีอยู่ในการศึกษาปัจจุบันการตรวจสอบคุณภาพการรับเข้ามหาวิทยาลัย) ผลการวิจัยยังแสดงให้เห็นถึงความสัมพันธ์ที่แข็งแกร่ง ค่าสัมประสิทธิ์สหสัมพันธ์เท่ากับ 0.83 ซึ่งสูงกว่ามัธยมศึกษาตอนปลายอย่างมีนัยสำคัญเนื่องจาก ข้อมูลเพิ่มเติม "
ผล
Smirnov เน้นคุณสมบัติข้อความทั่วไปโพสต์ที่เกี่ยวข้องกับความคืบหน้าของผู้เขียน พบว่าการใช้ headwords (-0.08), อีโมติคอน (-0.06) และอัศเจรีย์ (-0.04) มีความสัมพันธ์ในทางลบกับผลการเรียน ในทางกลับกันการใช้อักขระละตินข้อความเฉลี่ยและความยาวของคำขนาดคำศัพท์และเอนโทรปีของข้อความของผู้ใช้มีความสัมพันธ์ในเชิงบวกกับผลการเรียน (จาก 0.07 ถึง 0.16 ตามลำดับ)
Также было подтверждено, что учащиеся с разным уровнем успеваемости имеют разный словарный запас.
นักเรียนที่มีผลการเรียนสูงใช้:
- คำภาษาอังกฤษ;
- คำที่เกี่ยวข้องกับวรรณคดี (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- แนวคิดการอ่าน (อ่านตีพิมพ์หนังสือเล่ม);
- เงื่อนไขและชื่อที่เกี่ยวข้องกับฟิสิกส์ (จักรวาลควอนตัมทฤษฎีไอน์สไตน์นิวตันฮอว์คิง)
- คำที่เกี่ยวข้องกับกระบวนการคิด (การคิดการท่องจำ)
นักเรียนที่มีคะแนนต่ำใช้คำที่มีความผิดพลาดชื่อเกมคอมพิวเตอร์ยอดนิยมแนวคิดที่เกี่ยวข้องกับการรับราชการทหาร (กองทัพคำสาบาน ฯลฯ ) คำศัพท์เกี่ยวกับดวงชะตา (ราศีเมษราศีธนู) และคำที่เกี่ยวข้องกับอุบัติเหตุจากการขับขี่และรถยนต์ (การชนตำรวจจราจรล้อรถการปรับแต่ง)
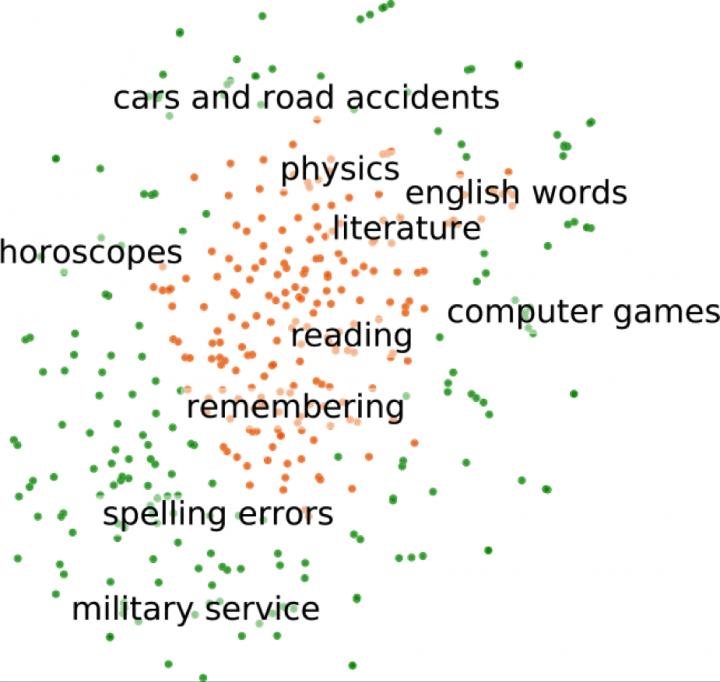 คลัสเตอร์เฉพาะเรื่อง: แทนคำที่ให้คะแนนสูงสุดและต่ำสุดจากชุดข้อมูลการฝึกอบรม
Смирнов рассчитал коэффициенты для всех 2,5 млн слов векторной модели и предоставил их для дальнейшего изучения. Интересно, что даже слова, которые редко встречаются в наборе обучающих данных, могут предсказать академическую успеваемость. Например, даже если имя «Ньют» (как у персонажа из вселенной «Гарри Поттера», Ньют Скамандер) никогда не появляется в наборе обучающих данных, модель может присвоить более высокий рейтинг сообщениям, которые его содержат. Это произойдет, если модель узнает, что слова из серии романов используются учениками с высокими достижениями, и посредством обучения без учителя модель «интуитивно» поймет, что имя «Ньют» относится к этой категории.
อ่านยัง
ภารกิจประจำปีในอาร์กติกสิ้นสุดลงแล้วและข้อมูลน่าผิดหวัง อะไรรอมนุษยชาติอยู่?
ชม Hummer ใหม่เอาชนะอุปสรรคบนท้องถนนเคลื่อนไหวเหมือนปู
ในวันที่ 3 ของการเจ็บป่วยผู้ป่วย COVID-19 ส่วนใหญ่สูญเสียความรู้สึกในการดมและมักจะมีอาการน้ำมูกไหล