Analizdeki her kelimenin kendi derecelendirmesi vardır. Bilimsel ve kültürel konuların tartışılması, İngilizce kullanımı
Çalışma, Rusya Bilim Vakfı'ndan bir hibe ile desteklendi.
Smirnov'un çalışması kullanıldıHSE boylamsal kohort panel çalışması "Eğitim ve Kariyer Yolları"ndan (TrEC) elde edilen verilerin temsili bir örneği. Araştırma, Rusya'nın 42 bölgesinden PISA (Uluslararası Öğrenci Değerlendirme Programı) programına katılan üniversitelerden 4.400 öğrencinin kariyer gelişimini takip ediyor. Çalışma verileri ayrıca öğrencilerin VK hesaplarına ilişkin verileri de içeriyordu (3.483 öğrenci katılımcı bu bilgiyi sağlamayı kabul etti).
"Bu tür veriler, dijitalizleri elde etmek zordur, neredeyse hiç kullanılmazlar ”diye açıklıyor Smirnov. Bu arada, böyle bir veri seti, diğer parametrelere uygulanabilecek sağlam bir modelin geliştirilmesine olanak tanır. Ve sonuçlar, diğer tüm öğrencilere - lise ve lise öğrencileri için tahmin edilebilir.
Eğitim örneği olarak kullandıkGenel VKontakte sayfalarından mesajlar - 2012'de PISA testini geçen 2.468 kişiden toplam 130.575 mesaj. Test, araştırmacının öğrencinin akademik yeteneğini ve bilgisini pratikte gösterme yeteneğini değerlendirmesine izin verdi. Çalışma, yalnızca kabul edilen katılımcılardan halka açık VKontakte mesajlarını içeriyordu.
Çalışma sırasında VKontakte post-corpus'ta kelimelerin vektör temsiliyle denetimsiz makine öğrenimi gerçekleştirildi (2,5 milyon benzersiz kelimeyle toplam 1,9 milyar kelime).
"Her gönderiyi 300 boyutlu olarak sundukTüm kurucu kelimelerin vektör temsillerinin ortalamasını alarak vektörler, ”diye açıklıyor Smirnov. "Bu yayın görüşleri, PISA sonrası yazarların derecelendirmelerini tahmin etmek için doğrusal bir regresyon modeli eğitmek için kullanıldı."
Araştırmacı "tahmin" yoluylageleceği tahmin etmek anlamına gelmez; hesaplanan sonuçlar ile öğrencilerin PISA sınavında elde ettiği gerçek puanlar ve Birleşik Devlet Sınavı sonuçları (bunlar internette toplu biçimde kamuya açıktır; yani bunlar okuldaki ortalama puanlar). Ön aşamada model, PISA verilerini tahmin etmeyi öğrendi. Nihai modelde hesaplamalar lise mezunlarının ve başvuranların Birleşik Devlet Sınavı sonuçlarıyla karşılaştırıldı.
Nihai modelin yapabilmesi gerekiyorduGüçlü veya zayıf bir öğrencinin bir sosyal ağda belirli bir gönderi yazıp yazmadığını güvenilir bir şekilde fark edin veya başka bir deyişle, akademik performansına göre konuları farklılaştırın. Bir eğitim döneminden sonra model, yüksek veya düşük PISA puanları (5-6. Düzeyler ve 0-1. Düzeyler) alan öğrenciler tarafından yazılan mesajları% 93.7 doğrulukla ayırt edebildi. PISA ve KULLANIMIN karşılaştırılabilirliği ile ilgili olarak, iki test farklı olsa da, araştırmalar, iki testteki öğrenci performansının birbiriyle güçlü bir şekilde ilişkili olduğunu göstermiştir.
"Öngörülen akademik performansınsınav sonuçlarıyla bağlantılı "- diyor Smirnov. Korelasyon katsayısı 0,49 ile 0,6 arasındadır. Ve üniversiteler söz konusu olduğunda, öngörülen akademik performans ve KULLANIM puanları karşılaştırıldığında (mevcut çalışmada bulunan bilgiler, Üniversiteye kabullerin kalitesini izleme), sonuçlar da güçlü bir ilişki gösterdi. Korelasyon katsayısı 0.83'tür ve bu, liseden önemli ölçüde daha yüksektir, çünkü daha fazla veri. "
Sonuçlar
Smirnov ortak metin özelliklerini vurguladıyazarlarının ilerlemesiyle ilgili gönderiler. Başlık (-0.08), emoticon (-0.06) ve ünlem (-0.04) kullanımının akademik performansla negatif yönde ilişkili olduğu bulunmuştur. Öte yandan, Latince karakterlerin kullanımı, ortalama mesaj ve kelime uzunluğu, kelime haznesi boyutu ve kullanıcı metinlerinin entropisi akademik performansla pozitif olarak ilişkilidir (sırasıyla 0,07'den 0,16'ya).
Ayrıca farklı başarı düzeylerine sahip öğrencilerin farklı kelime dağarcığına sahip olduğu da doğrulandı.
Yüksek performans gösteren öğrenciler şunları kullandı:
- İngilizce kelimeler;
- Edebiyatla ilgili kelimeler (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Okuma kavramları (okuma, yayınlama, kitap, cilt);
- Fizik ile ilgili terimler ve isimler (Evren, kuantum, teori, Einstein, Newton, Hawking);
- Düşünce süreçleriyle ilgili kelimeler (düşünme, ezberleme).
Düşük puana sahip öğrencilerhatalar, popüler bilgisayar oyunlarının isimleri, askerlik hizmetiyle ilgili kavramlar (ordu, yemin vb.), burç terimleri (Koç, Yay) ve araba ve araba kazalarıyla ilgili kelimeler (çarpışma, trafik polisi, tekerlekler, ayarlama).
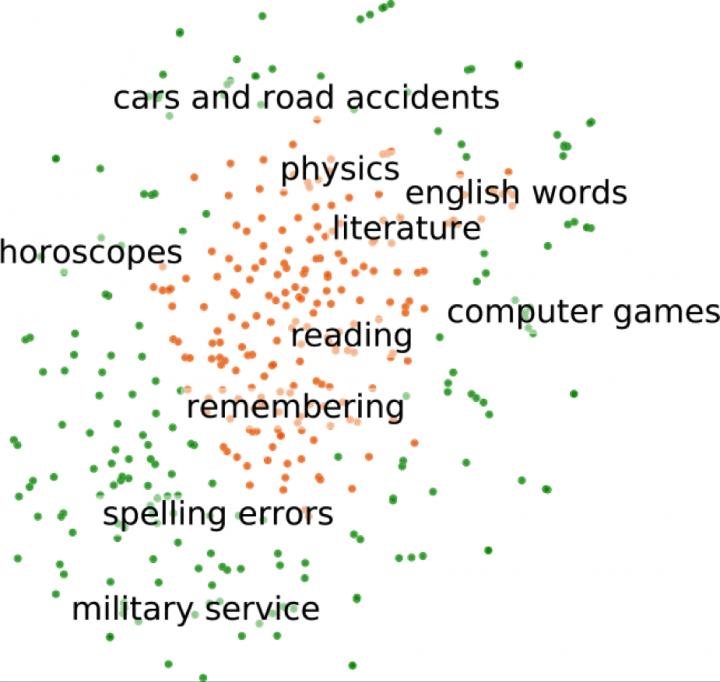 Tematik Kümeler: Eğitim veri setinden en yüksek ve en düşük puan alan kelimeleri temsil eder
Smirnov 2,5 milyonun tamamı için katsayıları hesapladıvektör modelinin sözlerini ve bunları daha ileri çalışmalar için sağladım. İlginçtir ki, eğitim veri setinde nadir bulunan kelimeler bile akademik performansı tahmin edebilir. Örneğin, "Newt" adı (Harry Potter karakteri Newt Scamander gibi) eğitim verilerinde hiç görünmese bile model, onu içeren mesajlara daha yüksek bir derecelendirme atayabilir. Bu, modelin roman serisindeki kelimelerin yüksek başarılı öğrenciler tarafından kullanıldığını öğrenmesi ve denetimsiz öğrenme aracılığıyla modelin "Newt" adının bu kategoriye girdiğini "sezgisel olarak" anlaması durumunda gerçekleşecektir.
Ayrıca okuyun
Kuzey Kutbu'ndaki yıllık görev sona erdi ve veriler hayal kırıklığı yaratıyor. İnsanlığı neler bekliyor?
Yengeç gibi hareket eden yoldaki engellerin üstesinden gelen yeni Hummer'ı izleyin
Hastalığın 3. gününde, COVID-19 hastalarının çoğu koku alma duyusunu kaybeder ve sıklıkla burun akıntısı çekerler