У світі, заснованому на даних, створення центрів, в яких можна дешево зберігати, швидко та ефективно
Система зберігання даних, заснована на ДНК,звучить як наукова фантастика. Але такі рішення вже реалізовані. Щоправда, поки що здебільшого у дослідницьких цілях і для зберігання архівних даних, які не потрібно часто використовувати. Ключовим обмеженням для роботи з ДНК є складність зі швидким паралельним доступом до великої кількості файлів та помилки під час читання та запису.
Міжнародна група дослідників розробилатехнологію, яка може усунути наявні недоліки. Один із авторів дослідження, опублікованого в журналі Nature, упевнений, що з використанням запропонованого рішення протягом 5–10 років повноцінні дата-центри, що базуються на ДНК, стануть реальністю.
ДНК як система зберігання даних
Ідея використання ниток ДНК для зберігання данихобговорювалась упродовж десятиліть. Ще в 1988 році дослідники з Гарварду і художник Джо Девіс закодували зображення стародавньої німецької руни розміром 5 на 7 пікселів (всього 35 біт інформації) у ДНК, включену до бактерії кишкової палички. Але цей приклад був просто демонстрацією майбутніх можливостей: технологія була надто дорогою та складною.
Технічно зберігання даних у ДНК стало можливим,коли у 2011 році дослідники з Гарварду розробили технологію керованого синтезу ДНК. Подальші дослідження у цій галузі значно знизили вартість і збільшили швидкість створення синтетичної ДНК, що містить необхідні послідовності ДНК.
Для зберігання інформації в ДНК замість 0і 1, які використовуються для кодування даних, можна застосовувати пари основ «аденін – тимін» та «цитозин – гуанін». У лабораторії основи з'єднуються у певному порядку, утворюючи синтетичні нитки ДНК.
Переваги ДНК
Зберігання даних у ДНК дає багато переваг.Наприклад, файл ДНК не займає багато місця: через високу щільність молекули — кожен нуклеотид, еквівалентний двом бітам, становить близько 1 нм. А екзабайт даних (1000000 Тб), що зберігаються у вигляді ДНК, може поміститися на долоні. ДНК також вкрай стабільна — відкриття генетичного коду, що зберігся, в скам'янілостях древніх мікроорганізмів і тварин яскравий тому приклад. Крім того, ця технологія не вимагає істотних витрат електроенергії.
Проблема полягає в тому, що якщо у питанняхзаписи даних існуючі рішення працюють досить добре (хоча і залишаються відносно дорогими), то з читанням починають виникати проблеми. Використовуваний в даний час для читання метод довільного доступу за допомогою ПЛР схильний до великої кількості помилок. Системи можуть читати лише один файл за раз, а якість даних дуже погіршується при кожному читанні.
Процес читання влаштований так:кожен файл даних у ДНК включає послідовність, яка пов'язується з певним праймером. За допомогою полімеразної ланцюгової реакції (ПЛР) дослідники запускають процес синтезу мільйона копій потрібного фрагмента.
За тим же принципом працює, наприклад,тестування на коронавірус: під впливом певного синтетичного праймера запускає ланцюгова реакція і навіть незначна кількість ДНК вірусу стає виявленою. Проблема в тому, що для читання декількох окремих файлів потрібно, щоб кілька праймерів працювало одночасно, а це призводить до багатьох помилок у процесі копіювання та знищення вихідної ДНК.
Технологія, що масштабується
Міжнародна група дослідників пропонуєметод, який, як вони вважають, дозволить подолати ці обмеження ПЛР з термофіксацією. Вчені створили мікрокапсули з білків та полімерів, які діють як окремі файли ДНК. Кожна капсула пов'язана з одним файлом даних. Крім того, вони сконструйовані таким чином, що при нагріванні безлічі мікрокапсул до температури вище 50 °C, кожна з цих капсул запечатується.
Це дозволяє процесу ПЛР під час зчитуваннявідбуватися незалежно у кожній капсулі, залишаючи дуже мало місця для помилки. При нормалізації температури вихідний файл залишається прив'язаним до капсули, а скопійовані файли залишають її. Це зберігає вихідні дані та ДНК від псування.
Генетики використовували свій новий підхід дляодночасного читання 25 файлів, що зберігаються в розділеній ДНК. Результати були позитивними та несподіваними. У середньому при використанні термокапсул втрати даних при зчитуванні становлять 0,3% після трьох зчитувань, порівняно з 35%, при використанні існуючого методу.
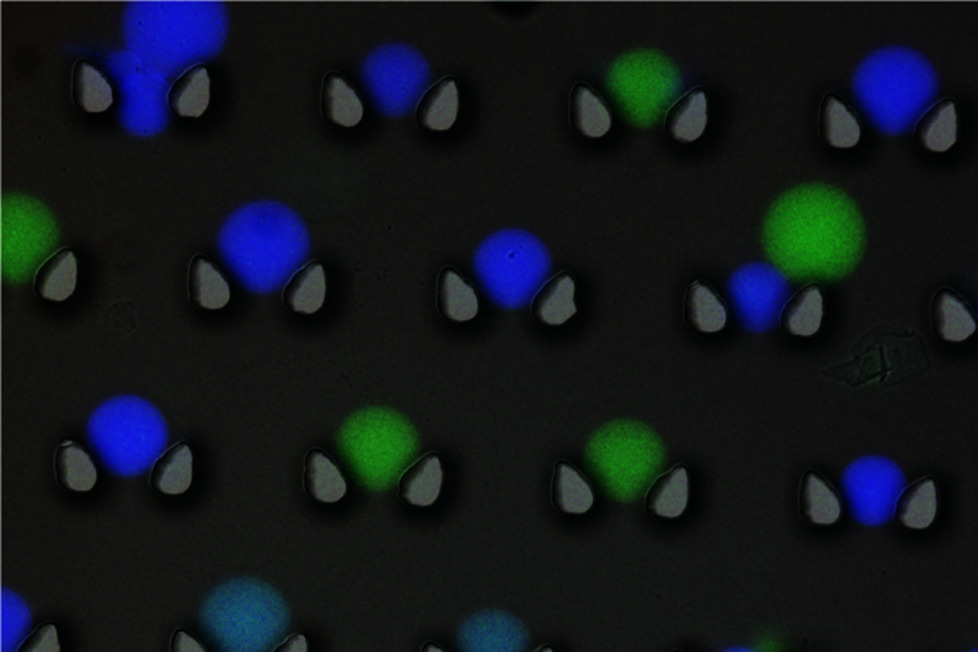 Пофарбовані флюоресцентними мітками мікрокапсули. Зображення: Tom de Greef
Друга «інновація» — пофарбована спеціальнимимітками каталог. Кожному файлу присвоюється флуоресцентна етикетка, а кожній капсулі свій колір. Після цього спеціальний пристрій може розпізнавати кольори та відокремлювати їх один від одного, щоб спростити сортування та пошук інформації у великому сховищі.
Автори технології впевнені, що цих інноваційдостатньо для того, щоб створити повноцінний дата-центр на основі ДНК. «В одній частині будівлі нові файли будуть закодовані за допомогою синтезу ДНК. Інша — міститиме великі поля капсул, кожна з окремим файлом. Роботизована рука дістане капсулу, прочитає її вміст і помістить назад», — каже один із авторів дослідження. Справа за малим: дочекатися, коли вартість синтезу ДНК скоротиться ще більше, а для цього вистачить одного десятиліття, переконані вчені.
Читати далі:
Штучний інтелект знайшов чотири геогліфи Наскі — гігантські малюнки в пустелі
Відсутність «комкуватості» у Всесвіті пояснили надлегкими частинками темної матерії
Близько мільярда років на добу на Землі тривали 19 годин: дослідники пояснили чому
На обкладинці: Зображення від Freepik