Кожне слово у аналізі має свій рейтинг. Обговорення наукових та культурних тем, використання англійських
Дослідження було підтримано грантом Російського наукового фонду.
У дослідженні Смирнова використовуваласьрепрезентативна вибірка даних лонгітюдного когортного панельного дослідження НДУ ВШЕ «Освітні та кар'єрні траєкторії» (TrEC). У дослідженні простежується кар'єрне зростання 4400 студентів із 42 регіонів Росії з вузів, що беруть участь у програмі PISA (Програма оцінки іноземних студентів). Дані дослідження також включають дані про облікові записи студентів у ВК (3483 студенти-учасники погодилися надати цю інформацію).
«Оскільки такі дані в поєднанні з цифровимитрасування важко отримати, вони майже ніколи не використовуються », - пояснює Смирнов. Тим часом, такий набір даних дозволяє розробити надійну модель, яку можна застосувати до інших параметрів. І результати можуть бути екстрапольовані на всіх інших учнів - старшокласників і учнів середньої школи.
Як навчальної вибірки використовувалисяповідомлення з загальнодоступних сторінок «ВКонтакте» - в цілому 130 575 повідомлень від 2468 людей, що пройшли тест PISA в 2012 році. Тест дозволив досліднику оцінити академічні здібності студента, а також його здатність показувати свої знання на практиці. У дослідження були включені тільки загальнодоступні повідомлення «ВКонтакте» від погодилися учасників.
У ході дослідження неконтрольоване машинне навчання з векторним поданням слів було виконано у пост-корпусі «ВКонтакте» (всього 1,9 мільярда слів, з 2,5 мільйонами унікальних слів).
«Ми представили кожен пост у вигляді 300-мірноговектора шляхом усереднення векторних уявлень всіх складових його слів », - пояснює Смирнов. «Ці подання повідомлень використовувалися для навчання моделі лінійної регресії для прогнозування оцінок авторів повідомлень PISA».
Під «прогнозуванням» дослідникмає на увазі не прогнозування майбутнього, а кореляцію між розрахованими результатами і реальними балами, отриманими учнями на іспиті PISA, а також їх результатами ЄВЕ (які загальнодоступні в .е. по школі). На попередньому етапі модель навчилася передбачати дані PISA. У підсумковій моделі розрахунки звірялися з результатами ЄДІ випускників середніх шкіл і абітурієнтів.
Передбачалося, що остаточна модель зможедостовірно розпізнати, чи написав сильний чи слабкий учень конкретний пост у соціальній мережі, або, іншими словами, диференціювати предмети відповідно до їх успішністю. Після періоду навчання модель змогла розрізняти повідомлення, написані студентами, які отримали високі або низькі бали по PISA (рівні 5-6 і рівні 0-1) з точністю 93,7%. Що стосується сумісності PISA і ЄДІ, хоча ці два тести розрізняються, дослідження показали, що результати учнів за цими двома тестами сильно корелюють один з одним.
Виявилося, що «прогнозована успішність тіснопов'язана з результатами ЄДІ », - говорить Смирнов. «Коефіцієнт кореляції становить від 0,49 до 0,6. А у випадку з університетами, коли порівнювалися прогнозована академічна успішність і бали абітурієнтів ЄДІ (інформація доступна в поточному дослідженні «Моніторинг якості прийому до вищих навчальних закладів»), результати також продемонстрували сильну зв'язок. Коефіцієнт кореляції становить 0,83, що значно вище, ніж для середньої школи, тому що даних більше ».
Отримані результати
Смирнов виділив загальні текстові особливостіпостів по відношенню до успішності їх авторів. Було виявлено, що використання великих слів (-0,08), смайликів (-0,06) і вигуків (-0,04) негативно корелює з успішністю. З іншого боку, використання латинських символів, середня довжина повідомлення і слова, розмір словникового запасу і ентропія призначених для користувача текстів позитивно корелюють з академічною успішністю (від 0,07 до 0,16 відповідно).
Також було підтверджено, що учні з різним рівнем успішності мають різний словниковий запас.
Учні з високим рівнем успішності використовували:
- Англійські слова;
- Слова, які стосуються літературі (Бредбері, Фаренгейт, Оруелл, Хакслі, Фолкнер, Набоков, Бродський, Камю, Манн);
- Поняття, пов'язані з читанням (прочитати, опублікувати, книгу, тому);
- Терміни і назви, пов'язані з фізики (Всесвіт, квантова, теорія, Ейнштейн, Ньютон, Хокінг);
- Слова, які стосуються розумових процесів (мислення, запам'ятовування).
Учні з низькими балами використовували слова зпомилками, назви популярних комп'ютерних ігор, поняття, які стосуються військової служби (армія, присяга і т. д.), терміни гороскопу (Овен, Стрілець) і слова, пов'язані з водінням і автомобільними аваріями (зіткнення, ДАІ, диски, тюнінг).
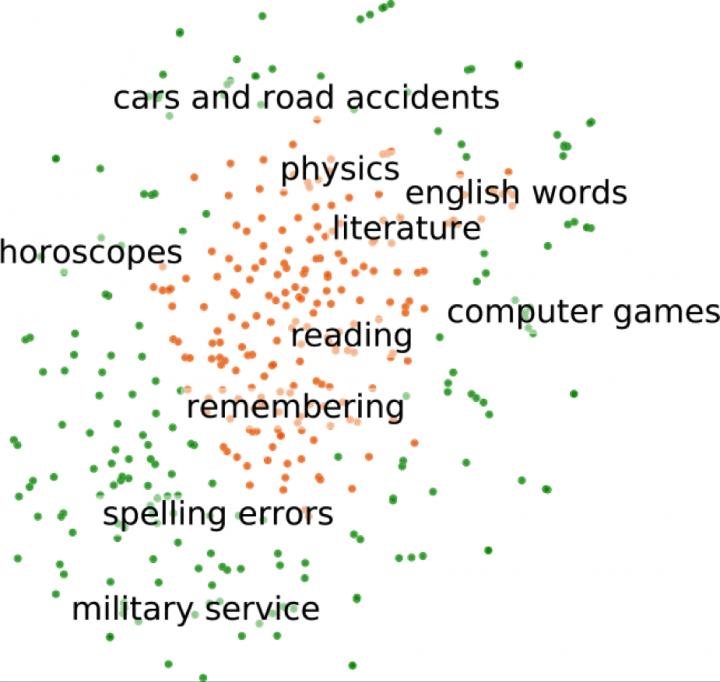 Тематичні кластери: уявлення слів з найвищим і найменшим балом з набору навчальних даних
Смірнов розрахував коефіцієнти для всіх 2,5 млн.слів векторної моделі і надав їх для подальшого вивчення. Цікаво, що навіть слова, які рідко зустрічаються в наборі навчальних даних, можуть передбачити академічну успішність. Наприклад, навіть якщо ім'я «Ньют» (як у персонажа з Всесвіту «Гаррі Поттера», Ньют Скамандер) ніколи не з'являється в наборі навчальних даних, модель може призначити більш високий рейтинг повідомлень, які його містять. Це відбудеться, якщо модель дізнається, що слова з серії романів використовуються учнями з високими досягненнями, і за допомогою навчання без вчителя модель «інтуїтивно» зрозуміє, що ім'я «Ньют» відноситься до цієї категорії.
Читати також
Річна місія в Арктиці закінчилася, і дані невтішні. Що чекає людство?
Подивіться, як новий Hummer долає перешкоди на дорозі, рухаючись як краб
На 3 день хвороби більшість хворих COVID-19 втрачають нюх і часто страждають нежиттю