Хоча джерела упередженості у системах ІІ різноманітні, однією з її основних причин є стереотипні
Щоб допомогти усунути цю проблему в їїпершоджерелі, дослідники з Princeton Visual AI Lab розробили інструмент з відкритим вихідним кодом, який автоматично виявляє потенційні спотворення в наборах візуальних даних. Інструмент дозволяє творцям наборів даних і користувачам виправляти проблеми недопредставлених або стереотипного зображення до того, як колекції зображень будуть використовуватися для навчання моделей комп'ютерного зору. У відповідній роботі члени Visual AI Lab опублікували порівняння існуючих методів запобігання упередженості в самих моделях комп'ютерного зору і запропонували новий, більш ефективний підхід до зниження упередженості.
Перший інструмент, що називається REVISE, використовуєстатистичні методи для перевірки набору даних щодо потенційних упереджень або проблем недопредставленості за трьома вимірами: об'єктним, гендерним та географічним.
REVISE оцінює вміст набору даних,використовуючи існуючі анотації до зображень і такі вимірювання, як кількість об'єктів, спільне присутність об'єктів і людей, а також країни походження зображень. Серед цих вимірів інструмент виявляє закономірності, які відрізняються від медіанного розподілу.
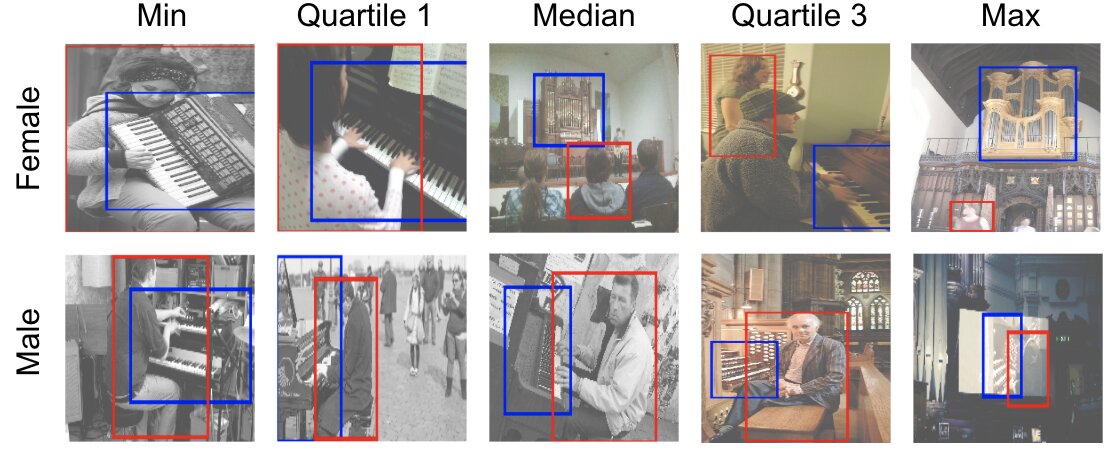 В одному наборі даних REVISE виявив потенційнугендерну упередженість в зображеннях, на яких зображені люди (червоні прямокутники) і орган музичного інструменту (сині прямокутники). Аналіз розподілу передбачуваних тривимірних відстаней між людиною і органом показав, що чоловіки, як правило, зображувалися як фактично грають на інструменті, тоді як жінки часто просто перебували в тому ж просторі, що й інструмент. Надано: Princeton Visual AI Lab.
Наприклад, в одному із протестованих наборівданих REVISE показав, що зображення, що включають людей і квіти, відрізнялися у чоловіків і жінок: чоловіки частіше з'являлися з квітами на церемоніях або зустрічах, а жінки, як правило, з'являлися в декораціях або картинах.
Як тільки інструмент виявляє такого родуневідповідності, «виникає питання, чи є це абсолютно невинним фактом, чи відбувається щось важливіше, і це дуже важко автоматизувати», — пояснює Ольга Русаковська, доцент кафедри інформатики та головний дослідник Visual AI Lab.
«Практика збору наборів даних в комп'ютернихнауках до недавнього часу не вивчалась так ретельно », - робить висновок співавтор дослідження Анджеліна Ван, аспірантка в області комп'ютерних наук. Вона пояснює, що зображення в основному «беруться з Інтернету, і люди не завжди розуміють, що їх зображення використовуються [в наборах даних]. Ми повинні збирати зображення від більш різних груп людей і робимо це з повагою ».
Читати також:
Створити термоядерний реактор на Землі реально. Які будуть наслідки?
Льодовик «Судного дня» виявився небезпечніше, ніж думали вчені. розповідаємо головне
На 3 день хвороби більшість хворих COVID-19 втрачають нюх і часто страждають нежиттю