Varje ord i analysen har sitt eget betyg.
Studien stöddes av ett bidrag från Russian Science Foundation.
Smirnovs studie användsett representativt urval av data från HSE longitudinella kohortpanelstudien "Educational and Career Trajectories" (TrEC). Studien följer karriärutvecklingen för 4 400 studenter från 42 regioner i Ryssland från universitet som deltar i PISA-programmet (Program for International Student Assessment). Studiedatan inkluderade även data om studenters VK-konton (3 483 studentdeltagare gick med på att lämna denna information).
”Eftersom sådan data, kombinerat med digitalspår är svåra att få, de används nästan aldrig, förklarar Smirnov. Under tiden tillåter en sådan dataset en robust modell som kan tillämpas på andra parametrar. Och resultaten kan extrapoleras till alla andra studenter - gymnasieelever och gymnasieelever.
Som ett träningsprov använde vimeddelanden från offentliga VKontakte-sidor - totalt 130 575 meddelanden från 2468 personer som klarade PISA-testet 2012. Testet gjorde det möjligt för forskaren att bedöma studentens akademiska förmåga, liksom hans förmåga att visa sina kunskaper i praktiken. Studien inkluderade endast offentligt tillgängliga VKontakte-meddelanden från överenskomna deltagare.
Under studien utfördes oövervakad maskininlärning med vektorrepresentation av ord i VKontakte post-corpus (1,9 miljarder ord totalt, med 2,5 miljoner unika ord).
”Vi har presenterat varje inlägg som ett 300-dimensionelltvektorer genom att beräkna vektorrepresentationerna för alla dess beståndsdelar, förklarar Smirnov. "Dessa inläggsvyer användes för att träna en linjär regressionsmodell för att förutsäga betyg för PISA-postförfattarna."
Genom "förutsägelse" forskarenbetyder inte att förutsäga framtiden, utan en korrelation mellan de beräknade resultaten och de faktiska poängen som eleverna erhållit på PISA-provet, såväl som deras Unified State Examination-resultat (som är allmänt tillgängliga på Internet i aggregerad form – dvs. dessa är genomsnittliga poäng i skolan). I det preliminära skedet lärde sig modellen att förutsäga PISA-data. I den slutliga modellen jämfördes beräkningarna med resultaten från Unified State Examinationen för gymnasieutexaminerade och sökande.
Den slutliga modellen skulle kunnapå ett tillförlitligt sätt känna igen om en stark eller svag student skrev ett specifikt inlägg på ett socialt nätverk, eller med andra ord, differentiera ämnen i enlighet med deras akademiska prestationer. Efter en träningsperiod kunde modellen urskilja meddelanden skrivna av studenter med höga eller låga PISA-poäng (nivåer 5-6 och nivåer 0-1) med en noggrannhet på 93,7%. När det gäller jämförbarheten mellan PISA och USE, även om de två testerna skiljer sig åt, har forskning visat att studenternas prestanda på de två testerna starkt korrelerar med varandra.
Det visade sig att ”förutsagda akademiska prestationer är närakopplat till resultaten av examen, "- säger Smirnov. ”Korrelationskoefficienten ligger mellan 0,49 och 0,6. Och när det gäller universiteten, när de förutspådda akademiska prestationerna och USE-poängen jämfördes (information tillgänglig i den aktuella studien, Övervakning av universitetens antagningskvalitet), visade resultaten också en stark relation. Korrelationskoefficienten är 0,83, vilket är betydligt högre än för gymnasiet, eftersom mer data. "
Resultat
Smirnov markerade vanliga textfunktionerinlägg i förhållande till deras författares framsteg. Användningen av huvudord (-0.08), uttryckssymboler (-0.06) och utrop (-0.04) visade sig vara negativt korrelerad med akademisk prestation. Å andra sidan är användningen av latinska tecken, genomsnittligt meddelande och ordlängd, ordförrådsstorlek och entropi för användartexter positivt korrelerade med akademisk prestanda (från 0,07 till 0,16).
Det har också bekräftats att elever med olika prestationsnivåer har olika ordförråd.
Högpresterande studenter använde:
- Engelska ord;
- Ord relaterade till litteratur (Bradbury, Fahrenheit, Orwell, Huxley, Faulkner, Nabokov, Brodsky, Camus, Mann);
- Läskoncept (läs, publicera, bok, volym);
- Termer och namn relaterade till fysik (Universum, kvant, teori, Einstein, Newton, Hawking);
- Ord relaterade till tankeprocesser (tänkande, memorering).
Studenter med låga poäng använde ord medmisstag, namn på populära dataspel, begrepp relaterade till militärtjänst (armé, ed, etc.), horoskoptermer (Väduren, Skytten) och ord relaterade till körning och bilolyckor (kollision, trafikpolis, hjul, tuning).
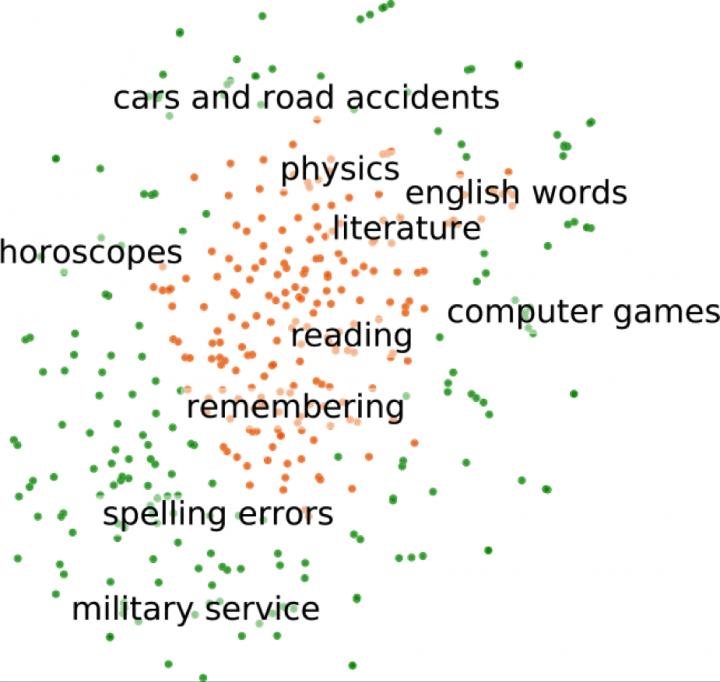 Temakluster: Representerar de högsta och lägsta poängen från träningsdataset
Smirnov beräknade koefficienterna för alla 2,5 miljonerord från vektormodellen och gav dem för vidare studier. Intressant nog kan även ord som är sällsynta i träningsdatauppsättningen förutsäga akademisk prestation. Till exempel, även om namnet "Newt" (som Harry Potter-karaktären Newt Scamander) aldrig förekommer i träningsdata, kan modellen ge ett högre betyg till meddelanden som innehåller det. Detta kommer att ske om modellen lär sig att ord från romanserien används av högpresterande elever, och genom oövervakat lärande förstår modellen "intuitivt" att namnet "Newt" faller inom denna kategori.
Läs också
Det årliga uppdraget i Arktis har avslutats och uppgifterna är en besvikelse. Vad väntar mänskligheten?
Se den nya Hummer övervinna hinder på vägen och rör sig som en krabba
På sjukdagens dag 3 förlorar de flesta COVID-19-patienter luktkänslan och lider ofta av en rinnande näsa